两份网页只差一个时间戳、一段广告或一个访问计数器,搜索引擎应该只保留一份;训练语言模型前,语料里成千上万份转载的新闻稿也应该合并。这就是近重复检测(near-duplicate detection):每份文档先压成一个几十到几百字节的草图(sketch),再只让草图”看起来像”的文档对进入精确比较。
围绕这两种草图,流传着三种说法,都需要修正:
- “Google 用 64 位 SimHash、汉明距离不超过 3 判重复”常被当成通用阈值。Manku 等人(WWW 2007)的原文是:在 80 亿网页上,这个设置的人工标注精确率与召回率都接近 0.75。按随机超平面模型换算,汉明距离不超过 3 只在余弦相似度约 0.98 以上才有过半的命中概率(第五节)。
- “\((ax+b) \bmod p\) 这种 2-独立哈希对 MinHash 足够”。Broder 等人(JCSS 2000)证明线性族连近似 min-wise 独立都不是;本文的实验里,输入是连续整数时,用 128 个线性哈希估计 \(J = 1/3\) 得到 0.283,而且增加哈希个数不会消除这个偏差(第三节)。
- “LSH 的阈值就是召回的下限”。datasketch 2.0.0 的
MinHashLSH默认threshold=0.9,它选出的分段参数在相似度恰为 0.9 时,只有 31% 的概率把这对文档列为候选(第四节)。
本文按”相似度定义 → MinHash 估计 → 哈希函数要求 → banding
候选生成 → SimHash → 汉明距离检索 →
两者之争”的顺序展开。所有误差、概率和候选数都来自同目录的
reproduce/sketch_sim.c(固定种子的蒙特卡洛实验,环境见第十节);论文中的数字都注明出处。LSH
的一般理论(\(\rho\)
值、p-stable 分布、多探针)放在站内 局部敏感哈希(LSH),本文只讲
Jaccard 与汉明距离这两种具体情形。
一、问题:把文档变成集合或向量
shingling 与 Jaccard 相似度
Broder 在 1997 年的 “On the resemblance and containment of documents”(Compression and Complexity of SEQUENCES 1997)里给出了今天仍在用的定义。文档先分词,连续 \(w\) 个词构成一个 shingle(瓦片,也就是 \(w\)-gram),文档 \(D\) 的 \(w\)-shingling \(S(D, w)\) 是它所有 shingle 的集合。两份文档的相似度(resemblance,即 Jaccard 相似度)和包含度(containment)分别是
\[ r(A, B) = J(A, B) = \frac{|S_A \cap S_B|}{|S_A \cup S_B|}, \qquad c(A, B) = \frac{|S_A \cap S_B|}{|S_A|}. \]
\(1 - J\) 满足三角不等式,是一个度量。Jaccard 衡量”两份文档整体有多像”,包含度衡量”\(A\) 有多少出现在 \(B\) 里”:一段短文被整段嵌进长文时,\(J\) 很低而 \(c(A, B)\) 接近 1,这两种需求不能用同一个阈值糊弄。
Broder 的论文还交代了工程细节:7 个英文词组成的 shingle 平均 40 到 50 字节,所以先用 Rabin 指纹把每个 shingle 映射成 \(\ell\) 位整数(他的实验取 \(\ell = 40\))。此后估计的其实是指纹集合的 Jaccard,指纹碰撞会让估计值偏高,这是所有实现都绕不开的一层误差(第三节 datasketch 的例子就是它)。
\(w\) 取多大没有公认答案。Broder 等人的网页聚类用 10 个词,Henzinger(SIGIR 2006)的对比实验取 8 个词,并指出 5 和 10 都有人用;Lee 等人(ACL 2022)对语言模型训练集去重用的是空格分词后的 5-gram。\(w\) 越小,改写后仍能匹配的 shingle 越多,但无关文档也越容易共享常见短语。
加权特征与余弦相似度
另一条路线不看词序,把文档看成加权特征向量 \(\mathbf{u}\)(分词、去停用词、词干化后按权重计),用余弦相似度
\[ \cos\theta(\mathbf{u}, \mathbf{v}) = \frac{\mathbf{u} \cdot \mathbf{v}}{\lVert \mathbf{u} \rVert \, \lVert \mathbf{v} \rVert}. \]
Manku 等人描述的 Google 爬虫系统就是这样提取特征的。两种相似度在二值特征上可以互相约束:若 \(A\)、\(B\) 都是单位权重的集合,记 \(S = |A \cap B| / \sqrt{|A||B|}\) 为余弦、\(R\) 为 Jaccard,Shrivastava 和 Li(AISTATS 2014)给出 \(S^2 \le R \le S / (2 - S)\)。特别地,当 \(|A| = |B| = n\)、交集为 \(c\) 时,\(S = c/n\),\(R = c/(2n - c)\);本文第五节的实验就用这组关系在两种相似度之间换算。
为什么要草图
对 \(N\) 份文档逐对计算需要 \(\binom{N}{2}\) 次比较,\(N = 10^9\) 时约 \(5 \times 10^{17}\) 次,每次还要扫描两份集合。近重复检测系统因此分成三步:
flowchart LR
    D[document] --> F[shingles or weighted features]
    F --> S[fixed-size sketch]
    S --> C[candidate pairs via banding or block tables]
    C --> V[exact check: Jaccard, edit similarity]
    V --> G[clusters via union-find]
草图决定”能估计什么相似度、误差多大”,候选生成决定”哪些文档对会被比较”,最后一步用精确相似度剔除假阳性。MinHash 与 SimHash 的差别主要在前两步,第七节再比较它们的实测表现。
二、MinHash:最小元素决定是否相等
核心等式
设 \(\pi\) 是全集上均匀随机的一个置换,\(h_\pi(S) = \min \{ \pi(x) : x \in S \}\)。则
\[ \Pr\left[ h_\pi(A) = h_\pi(B) \right] = \frac{|A \cap B|}{|A \cup B|} = J(A, B). \]
证明只需看 \(A \cup B\) 中 \(\pi\) 值最小的那个元素 \(x^\ast\)。\(h_\pi(A)\) 与 \(h_\pi(B)\) 相等,当且仅当 \(x^\ast\) 同时属于 \(A\) 和 \(B\):若 \(x^\ast \in A \cap B\),它同时是两边的最小值;若 \(x^\ast\) 只属于 \(A\),那么 \(h_\pi(A) = \pi(x^\ast)\) 严格小于 \(B\) 中任何元素的像,两者必不相等。由于 \(\pi\) 均匀随机,\(A \cup B\) 的每个元素成为 \(x^\ast\) 的概率都是 \(1/|A \cup B|\),所以概率为 \(|A \cap B| / |A \cup B|\)。\(\blacksquare\)
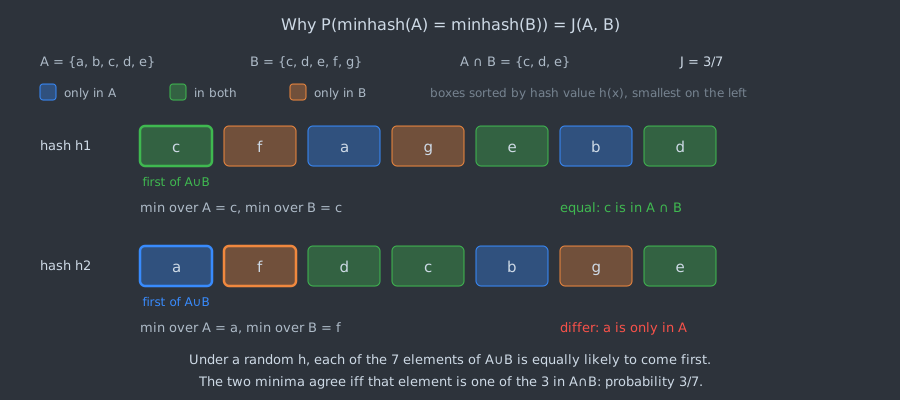
图中第一行哈希 \(h_1\) 下最小的是交集元素 c,两边的最小值都是 c;第二行 \(h_2\) 下最小的是只属于 \(A\) 的 a,\(A\) 的最小值是 a,\(B\) 的最小值是排在后面的 f。证明用到的只有一件事:并集中每个元素成为最小值的机会均等。第三节会看到,工程里的哈希函数恰恰可能破坏这一点。
三种草图
同一个等式有三种用法,它们的差别在于”用几个哈希函数、每个函数保留几个值”:
| 草图 | 提出者 | 构造 | 估计量 |
|---|---|---|---|
| bottom-\(k\) | Broder(SEQUENCES 1997,记作 \(\mathrm{MIN}_s\)) | 1 个置换,保留最小的 \(k\) 个值 | \(\lvert \mathrm{MIN}_k(M_A \cup M_B) \cap M_A \cap M_B \rvert / k\) |
| \(k\) 个哈希(k-mins) | Broder 等(STOC 1998 引言以 100 个独立置换为例) | \(k\) 个独立置换,各保留 1 个最小值 | 相等分量的比例 |
| 单置换分桶(OPH) | Li、Owen、Zhang(NIPS 2012) | 1 个置换把全集均分成 \(k\) 个桶,每桶保留最小值 | 相等的非空桶数 / 非空桶数 |
常见的说法把 MinHash 等同于”\(k\) 个哈希函数”,其实 Broder 1997 的定理 1 用的是单个置换加最小 \(s\) 个元素:\(\mathrm{MIN}_s(M_A \cup M_B)\) 恰好是 \(\mathrm{MIN}_s(\pi(A \cup B))\),其中属于交集的比例是 \(J\) 的无偏估计。\(k\) 个独立置换的版本出现在 Broder、Charikar、Frieze、Mitzenmacher 的 “Min-wise independent permutations”(STOC 1998;期刊版 JCSS 60(3), 2000)的引言里,AltaVista 的去重就是以它为背景。基因组比较工具 Mash(Ondov 等,Genome Biology 2016)用的也是 bottom-\(k\)。
对 \(k\) 个独立哈希,相等分量数服从二项分布,\(\hat{J}\) 无偏且
\[ \mathrm{Var}(\hat{J}) = \frac{J(1-J)}{k}, \qquad \Pr\left[ |\hat{J} - J| \ge \varepsilon \right] \le 2 e^{-2k\varepsilon^2}. \]
第二个式子是 Hoeffding 不等式。要以 99% 的概率把误差压在 \(\pm 0.05\) 内,需要 \(k \ge \ln(2/0.01) / (2 \times 0.05^2) \approx 1060\);这是最坏情况的界,标准差本身在 \(J = 0.5\)、\(k = 128\) 时约为 0.044。bottom-\(k\) 相当于从 \(A \cup B\) 中不放回地均匀抽 \(k\) 个元素,估计量服从超几何分布,方差多一个有限总体修正因子 \((|A \cup B| - k) / (|A \cup B| - 1)\),\(k\) 接近并集大小时明显更准。
b-bit:只存最低几位
Li 和 König 的 “b-Bit minwise hashing”(WWW 2010)只保存每个最小值的最低 \(b\) 位。两个值不同时低 \(b\) 位也可能碰巧相同,所以匹配概率变成 \(E_b = C_{1,b} + (1 - C_{2,b}) J\)(论文 Theorem 1);在集合远小于全集的稀疏极限下 \(C_{1,b} = C_{2,b} = 2^{-b}\),无偏估计量与方差是
\[ \hat{J}_b = \frac{\hat{E}_b - 2^{-b}}{1 - 2^{-b}}, \qquad \mathrm{Var}(\hat{J}_1) = \frac{1 - J^2}{k} \quad (b = 1). \]
\(b=1\) 时方差是完整值的 \((1+J)/J\) 倍,\(J = 0.5\) 时为 3 倍;但每个槽只占 1 位,论文据此给出”相似度不低于 0.5 时,比 64 位存储至少省 21.3 倍(\(64/3\))“的结论。
实测:误差随草图大小的变化
sketch_sim err 构造并集大小固定为
1000、\(J \in \{0.2, 0.5,
0.8\}\) 的集合对,每个配置 1000
次试验(每次重新生成元素 ID 和哈希种子),哈希用带种子的 64
位 MurmurHash3 finalizer。
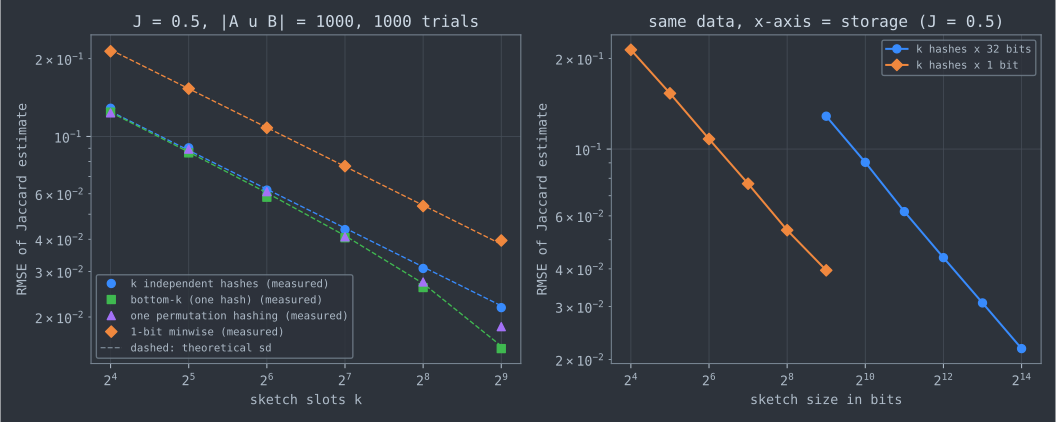
\(k = 128\) 时的均方根误差(括号内为理论标准差):
| \(J\) | \(k\) 个哈希 | bottom-\(k\) | OPH | 1-bit |
|---|---|---|---|---|
| 0.2 | 0.0369(0.0354) | 0.0331(0.0330) | 0.0336 | 0.0835(0.0866) |
| 0.5 | 0.0436(0.0442) | 0.0406(0.0413) | 0.0409 | 0.0767(0.0765) |
| 0.8 | 0.0345(0.0354) | 0.0336(0.0330) | 0.0338 | 0.0533(0.0530) |
三点观察。第一,所有实测误差都落在理论值附近;72 个配置的平均偏差最大为 0.0068,都在各自标准误差的 3 倍以内,看不出系统偏差(前提是哈希足够随机,见下一节)。第二,OPH 与 bottom-\(k\) 都只算一次哈希,误差却略低于 \(k\) 个独立哈希,这就是 Li 等人所说的”不放回抽样”效应;代价是 OPH 在集合比 \(k\) 小时会出现空桶,需要 Shrivastava 和 Li 的致密化(densification,ICML 2014;改进版见 UAI 2014 与 Shrivastava,ICML 2017)才能直接用于 banding。第三,右图按存储位数比较:512 位的 1-bit 草图误差 0.040,而 512 位只够放 16 个 32 位槽,误差 0.129。
三、哈希函数要多”随机”
min-wise 独立族
真正的随机置换没法存储,实践中用哈希函数代替。Broder 等人(JCSS 2000)把核心等式成立所需的条件精确地写了出来:置换族 \(\mathcal{F} \subseteq S_n\) 称为 min-wise 独立(min-wise independent),如果对任意 \(X \subseteq [n]\) 和任意 \(x \in X\),
\[ \Pr_{\pi \in \mathcal{F}}\left[ \min \pi(X) = \pi(x) \right] = \frac{1}{|X|}. \]
这正是第二节证明里”并集中每个元素成为最小值的机会均等”。论文的结论对工程很不友好:
- 精确的 min-wise 独立族大小至少是 \(\mathrm{lcm}(1, \ldots, n) = e^{n - o(n)}\)(Theorem 1),无法实用;
- 对任意两两独立的置换族,最小值概率有下界 \(1/(2(k-1))\)、上界 \(O(1/\sqrt{k})\)(\(k = |X|\),Theorem 10),与 \(1/k\) 可以差很多;
- 对线性族 \(\pi(x) = ax + b \bmod p\),取 \(X = \{0, 1, \ldots, k\}\),元素 0 成为最小值的概率渐近于 \(\frac{3}{\pi^2} \cdot \frac{\ln k}{k}\)(Theorem 11),所以线性族对任何常数 \(\varepsilon\) 都不是近似 min-wise 独立的。
作者同时写道,这些结果”suggest that although this family of permutations is not min-wise independent, its performance should be sufficient in many practical situations”。两句话都对:偏差只在输入有结构时出现。
实测:结构化输入上的线性哈希
sketch_sim lin 让 \(A = \{0, \ldots, 999\}\)、\(B = \{s, \ldots, s +
999\}\),分别用 128 个 \((ax + b) \bmod (2^{61} - 1)\)
和 128 个带种子的 MurmurHash3 finalizer 估计 \(J\),再用第一个线性哈希做
bottom-128;对照组把连续整数换成随机 ID。每行 2000
次试验取平均:
| 输入 | 真实 \(J\) | 线性,\(k\) 个哈希 | 强混合,\(k\) 个哈希 | 线性,bottom-\(k\) |
|---|---|---|---|---|
| 连续整数,\(s = 100\) | 0.8182 | 0.7482 | 0.8175 | 0.8179 |
| 连续整数,\(s = 500\) | 0.3333 | 0.2832 | 0.3331 | 0.3336 |
| 连续整数,\(s = 900\) | 0.0526 | 0.0437 | 0.0523 | 0.0523 |
| 随机 ID,\(s = 500\) | 0.3333 | 0.3345 | 0.3347 | 0.3330 |
在连续整数上,\(k\) 个线性哈希系统性地低估了 9% 到 17%,而 2000 次平均的标准误差只有 0.001 左右,这不是噪声。偏差来自每个哈希函数各自的偏斜,平均 128 个同样偏斜的函数不会让它消失。同一个线性哈希拿去做 bottom-\(k\) 却是准的:Thorup 在 “Bottom-k and priority sampling, set similarity and subset sums with minimal independence”(STOC 2013)中证明,bottom-\(k\) 只需 2-独立哈希,期望相对误差就是 \(O(1/\sqrt{fk})\)(\(f\) 为被估计的比例),并明确指出 \(k\) 个 min-wise 哈希在常数独立度下”there is an at least constant bias … and it is not reduced with larger k”。上表把这两句话都复现出来了。
理论上的另一条出路是提高独立度:Indyk(J. Algorithms 2001)证明 \(O(\log(1/\varepsilon))\)-独立的哈希族就是 \(\varepsilon\)-近似 min-wise 独立的;Pătraşcu 和 Thorup(ICALP 2010)给出了匹配的下界,说明 \(\Omega(\log(1/\varepsilon))\) 的独立度不能再降,并指出实践中常用的 2-独立 multiply-shift 方案在 min-wise 场景下同样会严重失效。工程上更常见的做法是先用一个强混合函数把输入”打散”,再做线性变换。
datasketch 2.0.0 换掉了默认方案
Python 库 datasketch 是这一节的工程注脚。以
2.0.0(2026-07)为准,datasketch/minhash.py
提供三种方案:
"legacy"(2.0.0 之前的唯一方案):输入先经 SHA-1 截成 32 位,再算(a * hv + b) % (2**61 - 1)并与2**32 - 1按位与;"affine32"(2.0.0 起的默认):SHA-1 截 32 位后先过一遍 MurmurHash3 finalizer(_fmix),再算 \(a h' + b \bmod 2^{32}\),\(a\) 取奇数,保证这一步是双射;"affine64":同样的构造换成 64 位。
旧方案的问题不是上表那种结构化输入(SHA-1
已经把输入打散了),而是把 61 位的结果截成 32
位:截断后的映射不再是置换,会在输入哈希碰撞之外再制造碰撞。项目文档
docs/minhash.rst 的 “Why the legacy scheme was
replaced”
一节写道:两个不相交、各十亿元素的集合,旧方案的估计值约为
0.23,接近 32 位输入哈希碰撞本身造成的下限(约
0.12)的两倍;32 位下限在每集合一千万元素时约为
+0.001,一亿时约为
+0.01(以上均为文档数据,本文未复现)。文档建议集合超过数千万元素时改用
affine64。这里还有一个升级陷阱:2.0.0
之前持久化的签名与新方案不可比较,从已有哈希值构造
MinHash 时必须显式传
scheme="legacy"。
四、Banding:把相似度变成候选对
构造
有了签名,比较一对文档只要 \(k\) 次整数比较,但 \(N\) 份文档仍有 \(\binom{N}{2}\) 对。banding(分段)让”签名足够像”的文档自己落进同一个桶:把长度 \(k\) 的签名切成 \(b\) 段、每段 \(r\) 行(\(br \le k\)),每一段用这 \(r\) 个值作为键建一张哈希表;两份文档只要某一段的 \(r\) 个值完全相同,就成为候选对。这是 Indyk 和 Motwani(STOC 1998)局部敏感哈希里 AND(段内拼接)加 OR(多张表)放大的具体形式,一般理论见 局部敏感哈希(LSH);教材化的写法来自 Leskovec、Rajaraman、Ullman 的 Mining of Massive Datasets 第 3 章。
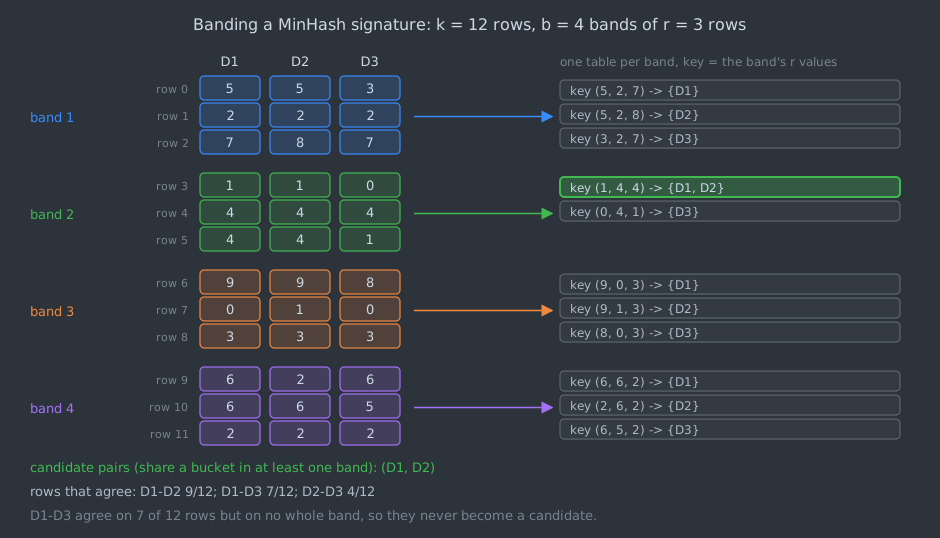
图中 D1 与 D2 的 12 行里有 9 行相同(估计 \(J \approx 0.75\)),第 2 段三个值全同,于是在第 2 张表里撞到一起。D1 与 D3 有 7 行相同(估计 \(J \approx 0.58\)),但每一段都至少差一个值,banding 永远不会把它们放在一起。这正是 banding 的意图:用”整段相同”这个苛刻条件过滤掉中等相似的文档对,代价是偶尔漏掉本应比较的对。
S 曲线
设两份文档的 Jaccard 为 \(s\),且 \(k\) 个 MinHash 分量独立。一段的 \(r\) 行全相同的概率是 \(s^r\),\(b\) 段都不全同的概率是 \((1 - s^r)^b\),所以
\[ P(s) = 1 - \left(1 - s^r\right)^b. \]
\(P(s)\) 是一条 S 形曲线。教材常用 \(t \approx (1/b)^{1/r}\) 近似它的拐点;真正让 \(P(s) = 1/2\) 的点是 \(s_{1/2} = \left(1 - 2^{-1/b}\right)^{1/r}\),略低于近似值。Henzinger 所比较的 Broder 算法(下称算法 B)也是 banding:84 个 MinHash 分成 6 个 supershingle、每个由 14 个值再做一次指纹,至少 2 个 supershingle 相同才算近重复,对应的概率是 \(1 - (1-p)^6 - 6p(1-p)^5\),\(p = s^{14}\)。
sketch_sim scurve 在并集大小 1000、\(s\) 从 0 到 1 每隔 0.02
的集合对上各做 2000 次试验,直接数候选对比例:
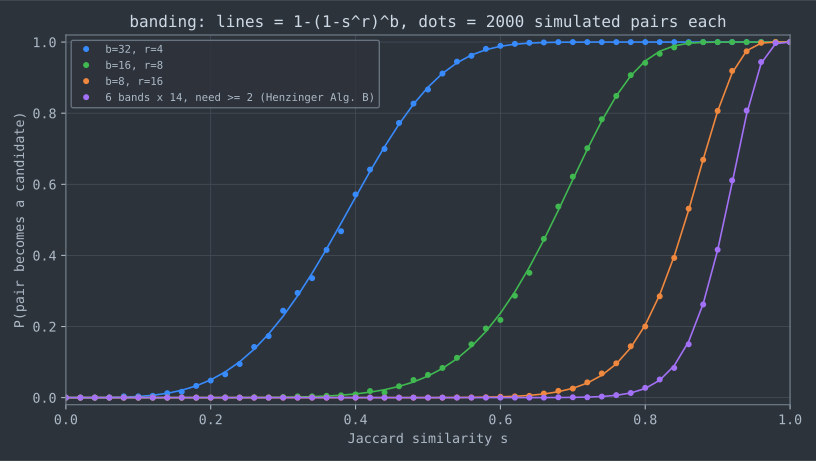
| 参数 | \((1/b)^{1/r}\) | \(s_{1/2}\) | 实测 \(P(0.5)\) | 实测 \(P(0.7)\) | 实测 \(P(0.9)\) |
|---|---|---|---|---|---|
| \(b=32, r=4\) | 0.420 | 0.383 | 0.867 | 1.000 | 1.000 |
| \(b=16, r=8\) | 0.707 | 0.674 | 0.064 | 0.622 | 1.000 |
| \(b=8, r=16\) | 0.878 | 0.856 | 0.000 | 0.026 | 0.807 |
| 6 段 × 14 行,至少 2 段 | — | — | 0.000 | 0.001 | 0.416 |
约 200 个实测点与公式的最大偏离不到 3 个二项标准差,说明”分量独立”这一假设在强混合哈希下成立。表里的算法 B 最陡也最保守:Jaccard 为 0.9 的文档对只有 42% 被报告。这组参数偏向精确率,但 Henzinger 的实验里它的精确率仍然只有 0.38(第七节)。她的错误分析把原因归于同一站点内的页面共用大量模板文本(boilerplate),只有中间的主体内容不同;这类页面的 shingle 集合确实很像,是相似度定义的问题,不是 banding 的随机性。
参数怎么选:datasketch 的做法
给定 \(k\) 和目标阈值
\(t\),datasketch 2.0.0 的
MinHashLSH 用 lsh.py 中的
_optimal_param 选 \((b, r)\):枚举所有 \(br \le k\) 的组合,最小化
\[ w_{\mathrm{fp}} \int_0^t P(s)\,\mathrm{d}s + w_{\mathrm{fn}} \int_t^1 \left(1 - P(s)\right) \mathrm{d}s, \]
默认 \(w_{\mathrm{fp}} =
w_{\mathrm{fn}} = 0.5\)。这是把 \([0, 1]\) 上的 \(s\)
当成均匀分布时”假阳性面积”与”假阴性面积”的加权和。用
datasketch 2.0.0
本身计算(reproduce/datasketch_params.py,num_perm=128):
threshold |
选出的 \((b, r)\) | 用到的行数 \(br\) | \(P(t)\) | \(s_{1/2}\) |
|---|---|---|---|---|
| 0.5 | (25, 5) | 125 | 0.548 | 0.487 |
| 0.7 | (14, 9) | 126 | 0.438 | 0.714 |
| 0.8 | (9, 13) | 117 | 0.399 | 0.819 |
| 0.9(默认) | (5, 25) | 125 | 0.311 | 0.922 |
两点容易被忽略。其一,threshold 是 S
曲线大致的中点,不是召回下限:默认参数下 \(J = 0.9\) 的文档对有 69%
不会成为候选。需要高召回时,应调大 weights
中假阴性的权重,或直接用 params 指定 \((b, r)\)。其二,\(br\) 可以小于
num_perm,多出来的签名分量不参与 banding。
另一个公开的参数例子来自 Lee 等人(ACL 2022)对语言模型训练集的去重:签名长度 9000,公式写作 \(1 - (1 - s^b)^r\),其中 \(b = 20\) 是每段行数、\(r = 450\) 是段数,与本文记号正好相反。按这组参数,\(P(0.7) = 0.30\)、\(P(0.75) = 0.76\)、\(P(0.8) = 0.995\),\(s_{1/2} \approx 0.72\);候选对再用编辑相似度大于 0.8 过滤。
五、SimHash:随机超平面上的比特指纹
Charikar 的定义与 Manku 的算法
Charikar 在 “Similarity estimation techniques from rounding algorithms”(STOC 2002)中把 LSH 与近似算法里的舍入技巧联系起来。对余弦相似度,他取随机向量 \(\mathbf{r}\)(每个坐标独立服从标准正态分布),定义
\[ h_{\mathbf{r}}(\mathbf{u}) = \begin{cases} 1, & \mathbf{r} \cdot \mathbf{u} \ge 0, \\ 0, & \mathbf{r} \cdot \mathbf{u} < 0, \end{cases} \qquad \Pr\left[h_{\mathbf{r}}(\mathbf{u}) = h_{\mathbf{r}}(\mathbf{v})\right] = 1 - \frac{\theta(\mathbf{u}, \mathbf{v})}{\pi}, \]
\(\theta\) 是两个向量的夹角。等式来自 Goemans 和 Williamson 的最大割舍入分析:随机超平面把两个向量分到两侧的概率正比于它们的夹角。同一篇论文还证明了一个常被忽略的否定结果:Dice 系数和 Overlap 系数这类相似度不存在满足”碰撞概率等于相似度”的 LSH。论文正文里没有”simhash”这个词,也没有下面这个按位加减权重的算法;这个名字和算法流程出自 Manku 等人(WWW 2007)对 Charikar 实现的描述:
- 维护 \(f\) 维整数向量 \(V\),初值全 0;
- 每个特征哈希成 \(f\) 位整数;第 \(i\) 位为 1 则 \(V_i\) 加上该特征的权重,为 0 则减去;
- 处理完所有特征后,按 \(V_i\) 的符号得到指纹的第 \(i\) 位。
把第 2 步写成向量形式,\(V_i = \mathbf{r}_i \cdot \mathbf{u}\),其中 \(\mathbf{u}\) 是权重向量,\(\mathbf{r}_i\) 的坐标由各特征哈希值的第 \(i\) 位决定、取 \(\pm 1\)。所以 Manku 的算法就是 \(f\) 个随机超平面,只是超平面法向量的坐标是 Rademacher 分布(等概率取 \(\pm 1\))而不是正态分布。Henzinger(SIGIR 2006)的算法 C 也是这样做的:每个词元投影到 \(b\) 维空间,每一维随机取 \(-1\) 或 \(1\)。
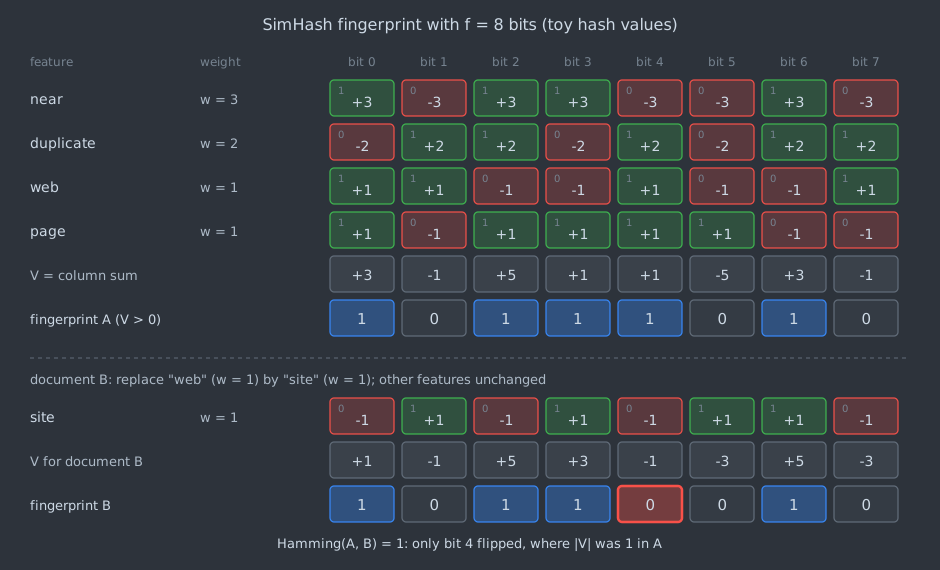
图中的例子说明了 SimHash
的”局部性”从哪里来:替换一个低权重特征,只会翻转那些 \(|V_i|\)
本来就很小的位。高权重特征对 \(V\)
的贡献大,决定了大多数位,这也是为什么 SimHash
对特征权重的选择很敏感。复现程序里的实现只有几行(reproduce/sketch_sim.c,单位权重,hmix
是带种子的 64 位混合函数):
static void simhash_acc(int *v, const uint64_t *feat, int n, uint64_t seed, int words)
{
    for (int i = 0; i < n; i++)
        for (int w = 0; w < words; w++) {
            uint64_t h = hmix(feat[i], seed + (uint64_t)w);
            for (int j = 0; j < 64; j++)
                v[w * 64 + j] += (int)((h >> j) & 1) * 2 - 1;
        }
}
指纹第 \(j\) 位取
v[j] > 0。Manku
的原文只说”符号决定比特”,没有规定 \(V_i = 0\)
时怎么办;这个细节在特征很少时会有影响,下面的实验能看到。
汉明距离服从二项分布
\(f\)
个超平面相互独立,所以两个指纹的汉明距离 \(H\) 服从二项分布 \(\mathrm{Binomial}(f,
\theta/\pi)\),期望 \(f\theta/\pi\)。这给出了从”汉明距离阈值”到”余弦相似度”的换算。sketch_sim simbits
构造两份各有 \(n\)
个单位权重特征、共享 \(c\)
个的文档(余弦为 \(c/n\)),比较 Rademacher
与正态两种超平面下每一位不同的比例(每格 4000 次试验、每次
64 位):
| \(n\) | \(\cos\theta\) | \(\theta/\pi\) | Rademacher(Manku 算法) | 正态(Charikar 定义) |
|---|---|---|---|---|
| 4 | 0 | 0.5000 | 0.4303 | 0.4983 |
| 4 | 0.5 | 0.3333 | 0.2811 | 0.3331 |
| 16 | 0 | 0.5000 | 0.4802 | 0.4995 |
| 16 | 0.5 | 0.3333 | 0.3190 | 0.3341 |
| 256 | 0 | 0.5000 | 0.4991 | 0.5004 |
| 256 | 0.5 | 0.3333 | 0.3331 | 0.3335 |
正态超平面在任何 \(n\) 下都符合 \(\theta/\pi\)。Rademacher 版本在特征少时偏低,主要原因正是平局:\(n = 4\)、两文档无共享特征时,\(V_i\) 为 4 个独立 \(\pm 1\) 之和,取 0 的概率为 \(6/16\),按”\(V_i > 0\) 才记 1”的规则,每位为 0 的概率是 \(11/16\),两位不同的概率为 \(2 \cdot \frac{11}{16} \cdot \frac{5}{16} \approx 0.4297\),与实测的 0.4303 一致。特征数到 256 时,平局和离散性的影响都小于千分之二。网页通常有数百个特征,二项模型可以直接使用;短文本(标题、短消息)则不能照搬。
汉明距离不超过 3 意味着什么
sketch_sim simthr 让每份文档有 1024
个单位权重特征,统计两种判定规则下被判为近重复的比例:Manku
的 64 位、\(H \le 3\),以及
Henzinger 算法 C 的 384 位、至少 372 位相同(即 \(H \le 12\))。
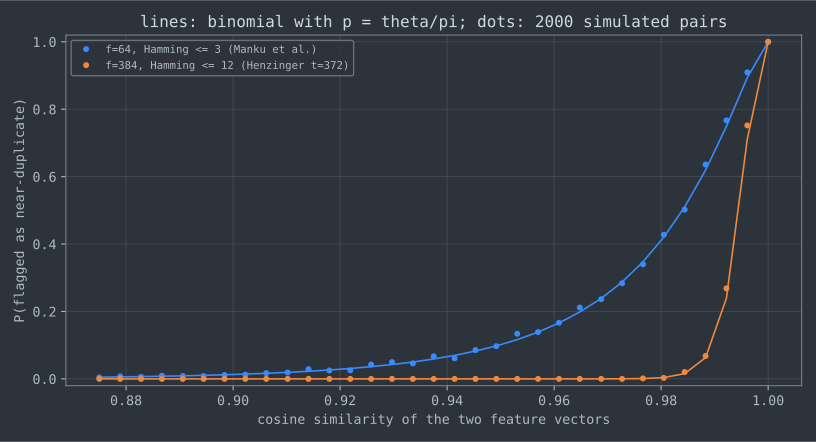
| \(\cos\theta\) | 64 位 \(H \le 3\):实测 | 二项模型 | 384 位 \(H \le 12\):实测 | 二项模型 |
|---|---|---|---|---|
| 0.9375 | 0.067 | 0.059 | 0.000 | 0.000 |
| 0.9688 | 0.237 | 0.239 | 0.000 | 0.000 |
| 0.9844 | 0.502 | 0.510 | 0.021 | 0.016 |
| 0.9922 | 0.767 | 0.749 | 0.269 | 0.239 |
| 0.9961 | 0.910 | 0.894 | 0.752 | 0.711 |
按二项模型,64 位、\(H \le 3\) 的命中概率在 \(\cos\theta \approx 0.984\)(\(\theta/\pi \approx 0.057\),夹角约 10°)时达到一半;384 位、\(H \le 12\) 的半数点在 \(\cos\theta \approx 0.9946\)。对单位权重、等大小的集合,\(\cos\theta = 0.984\) 对应 Jaccard 约 0.969。换句话说,“汉明距离不超过 3”是一个非常严格的相似度门槛。这与 Manku 等人的标注口径相符:他们把”只在计数器、广告或时间戳上略有不同”的页面对算作真正的近重复,这类页面的特征向量几乎完全相同。门槛能否迁移到别的语料,取决于那里的”重复”是否也这么接近。最后两行的实测值略高于模型,那里两份文档只差 8 个或 4 个特征,\(V\) 的差值是少数 \(\pm 1\) 之和,二项模型的连续近似开始失效。
还要纠正一个流传很广的说法:“SimHash 能做语义级匹配”。SimHash 的输入是词元、短语这类词法特征,同义词会被哈希到毫不相关的比特;它衡量的是加权特征向量的夹角,和 MinHash 衡量 shingle 集合的重合一样,都不理解语义。
六、汉明距离检索:置换排序表
问题与两种笨办法
有了 64 位指纹,Manku 等人要解决的是汉明距离问题(Hamming Distance Problem):给定 \(f\) 位指纹的集合和查询指纹 \(F\),判断是否存在与 \(F\) 至多相差 \(k\) 位的指纹。论文给的具体规模是 80 亿(\(2^{34}\))个 64 位指纹、共 64 GB;在线版本要在几毫秒内回答一次查询,批量版本要在约 100 秒内处理 100 万个查询。论文脚注特意说明,这些数值”for illustrative purposes only”,是设计目标的示意,不是线上系统的实测。
两种直接的办法都不可行。一是把所有指纹排序,把与 \(F\) 距离不超过 3 的每个 \(F'\) 都查一遍,需要 \(\sum_{i=0}^{3} \binom{64}{i} = 43745\) 次探测(论文只算了主项 \(\binom{64}{3} = 41664\));二是反过来把每个指纹的所有邻居预先存进表,空间放大同样是这个量级。
鸽巢原理与分块
论文的办法是复制几份表、每份换一种比特顺序。直观上,\(2^d\) 个随机指纹排好序后,最高的 \(d\) 位几乎就是一个计数器,匹配 \(F\) 最高 \(p\) 位的指纹期望只有 \(2^{d-p}\) 个。只要保证”至多差 \(k\) 位”的指纹一定在某张表的前 \(p\) 位与 \(F\) 完全一致,就能用少量探测找全。
保证它的是鸽巢原理:把 64 位切成 \(k + 1 = 4\) 块,3 个不同的比特最多落在 3 块里,至少有一块完全相同。于是建 4 张表,第 \(i\) 张把第 \(i\) 块移到最高位后排序;查询时每张表二分查找前 16 位相同的一段,再逐个检查汉明距离。
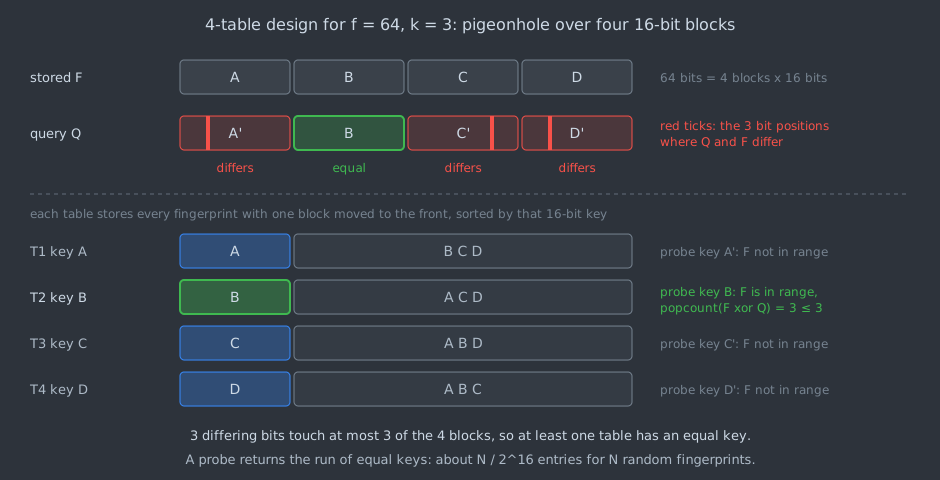
一般地,把 64 位分成 \(m\) 块、每张表取其中 \(m - k\) 块作为前缀,共 \(\binom{m}{k}\) 张表,前缀位数
\(p_i\)
是所选块的位数之和。16 表方案则是两级分块:先在 4 个 16
位块里选 1 块,再把剩下 48 位切成 4 个 12 位块、再选 1
块,\(p_i = 28\)。Example
3.1 的四种设计与 sketch_sim tables
的实测如下;实测用 \(N =
2^{20}\) 个随机指纹,查询包括 20
万个在已有指纹上随机翻转 0 到 3 位的”植入”查询和 20
万个随机查询:
| 设计 | 表数 | \(p_i\) | 论文:\(d = 34\) 时每次探测的期望匹配 | 本文:\(d = 20\) 时每个随机查询的候选数,理论 | 实测 | 植入查询召回 |
|---|---|---|---|---|---|---|
| 4 块选 1 | 4 | 16 | \(2^{18} = 256\mathrm{K}\) | 64 | 64.00 | 1.0 |
| 5 块选 2 | 10 | 25、26 | 至多 \(2^{9} = 512\) | 0.2188 | 0.2177 | 1.0 |
| 两级 4 块选 1 | 16 | 28 | \(2^{6} = 64\) | 0.0625 | 0.0631 | 1.0 |
| 6 块选 3 | 20 | 31 到 33 | 至多 \(2^{3} = 8\) | 0.0054 | 0.0053 | 1.0 |
“理论”列是各表 \(2^{d - p_i}\) 之和。实测与之吻合,召回是 1 并非统计意义上的”很高”,而是鸽巢原理的确定性保证;这与 banding 形成对照:banding 的召回是概率性的 S 曲线,Manku 的分表方案对”汉明距离不超过 \(k\)“这个判定是精确的,代价是表数随 \(k\) 组合增长(论文 §3.1.2 给出了在 \(p_i\) 下限约束下最少表数的递推式)。空间代价也很直接:\(t\) 张表就是 \(t\) 份指纹。
压缩、批处理与真实分布
论文还给出几项工程细节。每张表按块压缩:相邻指纹异或后最高 1 位的位置用 Huffman 编码,后面的比特原样保存,块大小典型值 1024 字节,8B 规模下表能压到约一半。批量模式把 100 万个查询(约 8 MB)建成表,再用 MapReduce 顺序扫描 GFS 上的指纹文件;压缩后约 32 GB,200 个 mapper 合计扫描速度超过 1 GB/s,整体不到 100 秒(§4.3 此处写作 “File Q”,按 §3.3 的设定指的应是存量指纹文件 F)。
所有表的设计都假设指纹均匀随机,而 SimHash 恰恰会让相似文档的指纹聚在一起。论文 §4.2 的图 2 显示,相邻指纹异或最高位的分布左半边衰减得比随机情形慢,并且按值分桶有尖峰:空页面的 SimHash 都是 0,“File not Found” 页面和使用同一论坛软件的登录页也各自聚成一团。这些热点会让某些探测返回远多于 \(2^{d-p}\) 的候选,工程上需要单独处理。至于判定质量,§4.1 在人工标注的样本上给出 \(k = 3\) 时精确率与召回率都接近 0.75,这是本文开头那句”约 0.75”的出处;论文没有给出网页中近重复所占的比例,也没有描述在重复版本之间保留哪一个的策略。
七、MinHash 还是 SimHash:一场没有定论的比较
Henzinger 2006:等存储下的网页去重
Henzinger 的 “Finding near-duplicate web pages: a large-scale evaluation of algorithms”(SIGIR 2006)在网页规模上正面比较了两者,Manku 等人的论文也直接引用它作为两种方法的对比。她在 16 亿个不同网页上运行两种算法,并刻意让它们存储相同:算法 B 存 6 个 64 位 supershingle,算法 C 取 \(b = 384\) 位投影,都是每页 48 字节。算法 B 用 8 个词元的 shingle,至少 2 个 supershingle 相同算近重复;算法 C 要求 384 位中至少 372 位相同。两种算法的输入也有本质差别:B 看词元顺序(shingle)、忽略频率,C 忽略顺序、考虑词频。
| 指标 | 算法 B(MinHash 系) | 算法 C(SimHash 系) |
|---|---|---|
| 报告的近重复对数 | 1831M | 1630M |
| 抽样人工评估的精确率,全部 | 0.38 | 0.50 |
| 同一站点内的文档对 | 0.34 | 0.37 |
| 不同站点之间的文档对 | 0.86 | 0.9 |
两者在同一站点内都表现很差,原因前面说过:共用模板的页面在两种相似度下都很像。C 的总体精确率更高,主要是因为它找到了更多跨站点的”仅 URL 不同”的页面对(406 对,B 只有 108 对),而跨站点对的精确率本来就高。Henzinger 最后给出的是组合方案:先用 B 找候选,再按 C 的相似度过滤,精确率 0.79,召回保留 B 的 79%。她也指出 B 的错误集中在两个在线数据库上(它们贡献了 28% 的错误对),这类页面只差一段连续词元,shingle 大小的选择对结果影响很大。
Shrivastava 与 Li 2014:二值数据上的检索
“In Defense of MinHash over SimHash”(AISTATS 2014)给出了相反方向的结论:“MinHash virtually always outperforms SimHash when the data are binary”。论证分两步:先用 \(S^2 \le R \le S/(2-S)\) 证明 MinHash 也是余弦相似度 \(S\) 的合法 LSH,再比较两者的 LSH 指数 \(\rho\),并在 MNIST、NEWS20、NYTIMES、RCV1、URL、WEBSPAM 六个二值化数据集上做 top-\(k\) 检索:对每种方法分别在 \(K \in \{1, \ldots, 30\}\)、\(L \in \{1, \ldots, 200\}\) 中搜索最优参数,比较达到给定召回所需扫描的数据比例。例如 MNIST 上 top-1 达到 90% 召回,MinHash 平均扫描 0.6% 的点,SimHash 要扫描 5%。
两个结论为什么不冲突
两篇论文回答的是不同的问题:
- 任务不同。Henzinger 做的是阈值判定(这一对是不是近重复),评价标准是人工标注的精确率;Shrivastava 和 Li 做的是 top-\(k\) 近邻检索,标准答案由余弦相似度本身定义。前者的误差主要来自”相似度定义与人类判断不一致”,后者只衡量”哈希对相似度的逼近效率”。
- 成本口径不同。Henzinger 按每页字节数对齐;Shrivastava 和 Li 按哈希函数个数 \(K\) 和表数 \(L\) 比较,一个 MinHash 值是完整整数,一个 SimHash 值是 1 位。论文自己也承认 1-bit MinHash 在相似度不高时竞争力下降,需要 \(b = 4\) 或 8 位才与完整 MinHash 相当。
- 特征不同。Henzinger 的两种算法用的是不同特征(shingle 对词元),差异不全来自哈希方法;Shrivastava 和 Li 在同一二值特征上比较。
所以更准确的表述是:在同一二值特征上做近邻检索,MinHash 的候选生成更高效;在网页去重这种阈值任务上,存储相同时 SimHash 系的精确率更高,但两者都受限于特征对”重复”的刻画。还有一个工程因素让 SimHash 在爬虫系统里流行:Manku 等人把”指纹小”列为 SimHash 相对 shingle 方法的一大优点,一个 64 位指纹是 8 字节,而他们引用的 Broder 式 shingle 指纹需要 24 字节(6 个 Rabin 指纹中至少 2 个相同)。
八、学术谱系与开放问题
谱系
| 年份 | 工作 | 贡献 |
|---|---|---|
| 1997 | Broder,SEQUENCES | 定义 resemblance 与 containment,用单个置换的最小 \(s\) 个值(bottom-\(s\))和 \(\mathrm{MOD}_m\) 采样做无偏估计;AltaVista 上 3000 多万文档、150 GB 的聚类实验 |
| 1997 | Broder、Glassman、Manasse、Zweig,WWW6 | “Syntactic clustering of the Web”,把 shingle 聚类用于整个网页集合 |
| 1998 | Broder、Charikar、Frieze、Mitzenmacher,STOC(期刊版 JCSS 2000) | min-wise 独立置换的定义、下界与线性族的反例 |
| 1998 | Indyk、Motwani,STOC | 局部敏感哈希框架,banding 的理论来源 |
| 2001 | Indyk,J. Algorithms | \(O(\log(1/\varepsilon))\)-独立足以实现 \(\varepsilon\)-近似 min-wise |
| 2002 | Charikar,STOC | 随机超平面 LSH;证明 Dice、Overlap 系数不存在 LSH |
| 2006 | Henzinger,SIGIR | 16 亿网页上 shingle 与随机投影的等存储比较 |
| 2007 | Manku、Jain、Das Sarma,WWW | 64 位 SimHash 与置换排序表,爬虫规模的汉明距离检索 |
| 2010 | Li、König,WWW | b-bit MinHash |
| 2010 | Pătraşcu、Thorup,ICALP | 证明 Indyk 的独立度上界是紧的 |
| 2012 | Li、Owen、Zhang,NIPS | 单置换哈希(OPH) |
| 2013 | Thorup,STOC | bottom-\(k\) 只需 2-独立;\(k\) 个 min-wise 哈希在常数独立度下有不随 \(k\) 消失的偏差 |
| 2014 | Shrivastava、Li,ICML / UAI / AISTATS | OPH 致密化;二值数据上 MinHash 优于 SimHash |
| 2016 | Ondov 等,Genome Biology | Mash:用 bottom-\(k\) MinHash 估计基因组距离 |
| 2017 | Dahlgaard、Knudsen、Thorup,FOCS | 快速相似度草图:\(O(t \log t + \lvert A \rvert)\) 期望时间,集中性与 \(t\) 个独立 MinHash 相同 |
| 2017 | Shrivastava,ICML | 最优致密化 |
| 2022 | Lee 等,ACL | 语言模型训练数据的 MinHash 去重,给出 9000 维签名的 banding 参数 |
这条线索里有两个反复出现的主题。一是计算代价:从 \(k\) 个独立哈希(\(O(k|A|)\))到单置换、再到兼顾速度与集中性的草图,每一步都在回应”\(k\) 次哈希太贵”;OPH 在小集合上的空桶问题引出了致密化,而 Dahlgaard 等人指出致密化方案恰恰在 \(|A| = O(t)\) 这个需要它的区间里给不出好的集中界。二是哈希的随机性:从 BCFM 的否定结果、Indyk 的上界、Pătraşcu–Thorup 的下界,到 Thorup 对 bottom-\(k\) 的正面结果,理论把”要多随机”刻画得越来越精确,而实践几乎都在用没有独立性证明的快速混合函数。
开放问题
- 相似度定义与”重复”的判断之间的差距。Henzinger 的数据里,同一站点内两种算法的精确率都只有 0.34 到 0.37,错误主要来自模板文本。她建议按频率给 shingle 加权、调整 shingle 长度,但也指出缩短 shingle 会让”只差一段连续词元”的数据库页面更容易被误判。模板剥离、加权方案和 shingle 长度之间没有公认的最优组合,至今仍需在各自语料上调。
- 阈值依赖数据。Manku 的 \(k = 3\) 是在他们的人工标注样本上选出来的,Lee 等人的 banding 参数与编辑相似度 0.8 也是经验值;datasketch 的参数选择假设相似度在 \([0,1]\) 上均匀分布,而在去重场景里,绝大多数文档对彼此无关,相似度集中在低端,假阳性的实际数量远比均匀假设下的面积所示的多。按数据分布选择 banding 参数和汉明阈值,目前没有通用方法。
- 理论与实现之间的独立性空隙。Thorup 的结果只覆盖 bottom-\(k\);\(k\) 个哈希的方案和 OPH 在常用哈希函数下的偏差没有一般性的保证。本文第三节的实验说明问题在结构化输入上是真实存在的,但对 MurmurHash 这类混合函数,除实验外并无证明。
- SimHash 检索的非均匀性。Manku 的分表方案假设指纹均匀,而 SimHash 恰恰把相似文档聚在一起;空页面、错误页这类热点会让个别探测退化。论文只描述了现象,没有给出针对热点的分析或设计。
- MinHash 与 SimHash 的公平比较。按哈希个数比较(Shrivastava–Li)与按存储比较(Henzinger)结论不同,而按比特数比较时还要引入 b-bit MinHash;在同一特征、同一存储、同一种阈值任务下的系统比较仍然缺乏。
九、工程选择与常见陷阱
| 需求 | 更合适的选择 | 依据 |
|---|---|---|
| 估计 Jaccard、做集合相似度检索 | MinHash(bottom-\(k\) 或 OPH 加致密化)+ banding | 碰撞概率就是 \(J\);bottom-\(k\) 对哈希独立性要求最低 |
| 海量文档、每篇只能存 8 字节、判定”几乎相同” | 64 位 SimHash + 置换排序表 | Manku 2007;判定精确,但门槛约等于余弦 0.98 以上 |
| 带权特征(TF-IDF)、关心余弦 | SimHash(随机超平面) | Charikar 2002;特征少时注意平局与离散性 |
| 需要控制召回 | 用公式算 \(P(s)\) 选 \((b, r)\),或事后验证 | datasketch 按默认权重选出的参数,在阈值处只有约 31% 到 55% 的召回 |
| 存储极紧、相似度较高 | b-bit MinHash | Li–König 2010;相似度低时需要更多位 |
几个容易出错的地方:
- 把阈值当成召回下限。banding 的
threshold是 S 曲线的大致中点,汉明距离阈值也只是一个判定边界;如果业务要求”相似度 0.9 以上必须找到”,要么把 S 曲线往左移,要么多用几组参数取并集,然后用精确相似度过滤。 - \(k\) 个哈希用线性哈希。\((ax + b) \bmod p\) 在结构化输入上有不随 \(k\) 消失的偏差(第三节)。要么先用强混合函数打散输入,要么改用 bottom-\(k\)。
- 指纹位数不够。32 位 shingle 指纹的碰撞会给不相交集合带来一个估计下限,按 datasketch 文档的数据,每集合一千万元素时约 +0.001、一亿时约 +0.01;大集合应当使用 64 位。
- 升级库版本后混用签名。datasketch 2.0.0 改变了默认方案,旧签名与新签名比较得到的是无意义的数字。签名必须与生成它的方案和种子一起存档。
- 把 SimHash 的汉明阈值照搬到短文本。二项模型在特征少时失效,平局规则也会改变碰撞率(第五节);短文本需要重新标定阈值。
- 忽略指纹的非均匀分布。空页面、错误页会让大量文档共享同一个 SimHash 值,查询这些值时探测会退化,应当在进入检索前单独过滤。
- 只看算法、不看特征。Henzinger 的实验说明,同一站点模板页的误判来自相似度定义本身。换哈希方法不能解决这个问题,要在特征提取阶段剥离模板。
十、复现
所有实验在一个 C 文件里,按模式分别运行;每次试验的集合和哈希种子都由固定种子的 splitmix64 生成,输出完全确定,不涉及计时。
cd post/algorithms/34-minhash-simhash/reproduce
sh run.sh 11 /path/to/python-with-matplotlib /path/to/python-with-datasketch
run.sh 用 gcc -O2 -Wall -Wextra
编译 sketch_sim.c,把各模式绑定到参数指定的 CPU
核上运行,结果写入 results/,再调用
plot.py(matplotlib)和
draw_svgs.py
重绘全部图,最后删除二进制。第三个参数省略时跳过 datasketch
部分,已有的 results/datasketch_params.txt
保持不变。
| 模式 | 测量内容 | 对应章节 |
|---|---|---|
err |
四种 MinHash 草图在 \(J \in \{0.2, 0.5, 0.8\}\)、\(k\) 从 16 到 512 下的 RMSE 与偏差,每点 1000 次 | 第二节 |
lin |
线性哈希与强混合哈希在连续整数与随机 ID 上的平均估计,每点 2000 次 | 第三节 |
scurve |
四组 banding 参数的候选概率与公式对照,每点 2000 次 | 第四节 |
simbits |
Rademacher 与正态超平面的单比特碰撞率,每点 4000 次 | 第五节 |
simthr |
64 位 \(H \le 3\) 与 384 位 \(H \le 12\) 的判定概率,每点 2000 次 | 第五节 |
tables |
Manku 四种分表设计的候选数与召回,\(N = 2^{20}\) | 第六节 |
datasketch_params.py 直接调用 datasketch
2.0.0 的
datasketch.lsh._optimal_param,并按公式计算
\(P(t)\) 与 \(s_{1/2}\)(第四节)。本文的结果在以下环境得到:Intel
Core i9-12900K,WSL2(Linux
6.6.87.2-microsoft-standard-WSL2),gcc 16.1.1,Python
3.14.5,matplotlib 3.11.2,datasketch 2.0.0(numpy
2.5.3、scipy 1.18.1)。sketch_sim.c 在
-O2 与 AddressSanitizer/UBSan
下都无警告,两种构建的输出一致。由于是确定性的蒙特卡洛,换一台机器应当得到逐字节相同的
results/*.txt;只有更换编译器的数学库(log、cos、lgamma)可能让正态超平面和二项分布列的末位不同。
十一、参考资料
规范与文档
- datasketch 2.0.0
文档,
docs/minhash.rst,“Why the legacy scheme was replaced” 一节(legacy、affine32、affine64 三种方案与 32 位碰撞下限)。 - datasketch 2.0.0
文档,
docs/lsh.rst(MinHashLSH的threshold、weights、params参数)。
源码
- datasketch 2.0.0(提交
3da96a59),
datasketch/minhash.py:MinHash的scheme参数、_fmix与三种置换方案。 - datasketch 2.0.0(提交
3da96a59),
datasketch/lsh.py:_optimal_param与MinHashLSH默认参数。
核心论文
- A. Z. Broder, “On the resemblance and containment of documents”, Compression and Complexity of SEQUENCES 1997, pp. 21–29, doi:10.1109/SEQUEN.1997.666900.
- A. Z. Broder, S. C. Glassman, M. S. Manasse, G. Zweig, “Syntactic clustering of the Web”, Computer Networks and ISDN Systems 29(8–13):1157–1166, 1997(WWW6)。
- A. Z. Broder, M. Charikar, A. M. Frieze, M. Mitzenmacher, “Min-wise independent permutations”, STOC 1998;期刊版 JCSS 60(3):630–659, 2000, doi:10.1006/jcss.1999.1690。
- M. S. Charikar, “Similarity estimation techniques from rounding algorithms”, STOC 2002, pp. 380–388, doi:10.1145/509907.509965.
- G. S. Manku, A. Jain, A. Das Sarma, “Detecting near-duplicates for web crawling”, WWW 2007, pp. 141–150.
- M. Henzinger, “Finding near-duplicate web pages: a large-scale evaluation of algorithms”, SIGIR 2006, pp. 284–291, doi:10.1145/1148170.1148222.
- P. Li, A. C. König, “b-Bit minwise hashing”, WWW 2010, pp. 671–680, doi:10.1145/1772690.1772759.
- P. Li, A. B. Owen, C.-H. Zhang, “One permutation hashing”, NIPS 2012, arXiv:1208.1259.
- M. Thorup, “Bottom-k and priority sampling, set similarity and subset sums with minimal independence”, STOC 2013, pp. 371–380, doi:10.1145/2488608.2488655.
其他论文
- P. Indyk, R. Motwani, “Approximate nearest neighbors: towards removing the curse of dimensionality”, STOC 1998, pp. 604–613.
- P. Indyk, “A small approximately min-wise independent family of hash functions”, Journal of Algorithms 38(1):84–90, 2001.
- M. Pătraşcu, M. Thorup, “On the k-independence required by linear probing and minwise independence”, ICALP 2010, LNCS pp. 715–726;期刊版 ACM TALG 12(1), 2015。
- A. Shrivastava, P. Li, “Densifying one permutation hashing via rotation for fast near neighbor search”, ICML 2014, PMLR 32.
- A. Shrivastava, P. Li, “Improved densification of one permutation hashing”, UAI 2014, arXiv:1406.4784.
- A. Shrivastava, P. Li, “In defense of MinHash over SimHash”, AISTATS 2014, PMLR 33, arXiv:1407.4416.
- A. Shrivastava, “Optimal densification for fast and accurate minwise hashing”, ICML 2017, PMLR 70, arXiv:1703.04664.
- S. Dahlgaard, M. B. T. Knudsen, M. Thorup, “Fast similarity sketching”, FOCS 2017, pp. 663–671;修订版 arXiv:1704.04370。
- B. D. Ondov et al., “Mash: fast genome and metagenome distance estimation using MinHash”, Genome Biology 17:132, 2016, doi:10.1186/s13059-016-0997-x.
- K. Lee et al., “Deduplicating training data makes language models better”, ACL 2022, pp. 8424–8445, arXiv:2107.06499.
工程资料
- J. Leskovec, A. Rajaraman, J. D. Ullman, Mining of Massive Datasets, Cambridge University Press,第 3 章 “Finding Similar Items”(banding 的教材化表述)。
实验
reproduce/sketch_sim.c:第二到第六节全部蒙特卡洛数据的来源,六个模式见第十节。reproduce/datasketch_params.py:第四节 datasketch 参数表。reproduce/plot.py、reproduce/draw_svgs.py:本文全部统计图与示意图中的数值。reproduce/results/*.txt:本文引用的原始输出。
系列导航: - 上一篇:水塘抽样:Algorithm R/L/Z、加权键与样本合并 - 下一篇:频率估计与 Heavy Hitter:Misra-Gries、Space-Saving 与空间下界
相关阅读: - 局部敏感哈希:从概率保证到多探针近邻检索 - 字符串哈希:Rabin-Karp、滚动哈希与内容定义分块 - HyperLogLog:从概率计数到 Redis 实现的基数估计
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。
基数排序:绕开比较下界的代价,从 LSD、American flag sort 到 ska_sort
比较下界只约束比较模型,基数排序把代价转移到键长和内存访问上。本文推导代价模型,用缓存模拟与绑核实测解释位宽为何停在 8 到 11 位,并对照 ska_sort、ClickHouse、DuckDB 与 IPS²Ra 说明它何时赢、何时输。