给你 1000 万个排好序的 64 位整数,问某个键在第几位。二分查找平均要 23 次比较,碰到约 20 条不同的缓存行;把同一个数组套上一棵静态 B+tree,缓存行能降到 10 条左右,比较次数却一次不少(第五节实测)。2017 年底,Kraska 等人换了个问法:这个”第几位”就是键的累积分布函数(CDF)乘以 \(n\),何不直接把它学出来?
围绕这个想法流传着两种说法。一种是”用神经网络取代 B-tree,快 70%、省一个数量级内存”,来自原论文摘要;另一种是”调优过的 B-tree 一样快,学习索引是炒作”。两种说法都只对了一部分:原论文效果最好的第二层其实是线性模型,后来胜出的结构(PGM-index、RadixSpline)几乎全是分段线性;而独立基准(SOSD)确认了学习索引在只读、内存、稠密有序数组上确实领先,一旦加上写入、难拟合的分布、并发和端到端内存口径,差距就明显收窄(GRE 基准)。
本文按”问题模型 → 谱系 → RMI → 误差有界的分段线性 → 实验
→ 可更新结构 → 争论”展开。B-tree
本身的结构、分裂与磁盘模型见 B-tree
深度解剖,原地更新与 LSM 的写放大对比见 B+tree 与
LSM-tree;本文只讨论”从键到位置”这一步能不能学、学了值多少。实验数据全部来自同目录下的
reproduce/li_bench.cpp,论文数字都标出
figure/table、数据集与硬件。
一、查找就是求 rank:CDF 视角与误差窗口
rank、CDF 与”最后一公里”
设有序数组 \(A[0..n-1]\) 存放互不相同的键。对查询键 \(k\),我们要的是
\[ \mathrm{rank}(k) = \left|\{\, i : A[i] < k \,\}\right|, \]
也就是 std::lower_bound 返回的下标:\(k\) 存在时它就是 \(k\)
的位置,不存在时是插入点。若把 \(A\)
看成来自某个分布的样本,经验 CDF 为 \(F_n(x) = \frac{1}{n}\left|\{i : A[i]
\le x\}\right|\),那么对存在的键有 \(\mathrm{rank}(A[i]) = i = n F_n(A[i])
-
1\)。索引要做的事,是在不扫描数组的前提下估计这个函数。
学习索引用一个便宜的模型 \(f\) 近似 rank,并记住它在已存键上的最大误差:
\[ \varepsilon = \max_{i} \left| f(A[i]) - i \right|. \]
查找时先算 \(p = f(k)\),再在窗口 \([p-\varepsilon,\ p+\varepsilon]\) 里做二分,这一步叫”最后一公里”(last-mile search),代价约 \(\log_2(2\varepsilon+1)\) 次比较,与 \(n\) 无关。于是整个查找的代价被拆成两部分:算模型的开销,和由 \(\varepsilon\) 决定的窗口搜索。
不存在的键需要单调性
\(\varepsilon\) 只在已存的键上度量。对不存在的键 \(k\),若 \(A[i-1] < k < A[i]\) 且 \(f\) 单调不减,则
\[ f(k) \in [f(A[i-1]),\ f(A[i])] \subseteq [\,i-1-\varepsilon,\ i+\varepsilon\,], \]
窗口仍然盖住插入点 \(i\)。如果 \(f\) 不单调,这个保证就没有了。Kraska 等人在论文 3.4 节明确指出:RMI 对存在的键一定能找到,对不存在的键可能返回错误的上下界,需要强制模型单调、在窗口边界处扩展搜索,或改用指数搜索。本文的 RMI 实现采用第二种办法(第三节),PGM-index 的每一段都是单调直线,不存在这个问题。
B+tree 也是一个模型
Kraska 等人的出发点是:B-tree 本身就是一个把键映射到页的模型,最小误差 0,最大误差为页大小(论文第 2 节)。一棵静态 B+tree 的内部节点只存分隔键,相当于用阶梯函数逼近 CDF。
这个视角能解释一个常被忽略的事实。扇出为 \(B\) 的 B+tree 高度约 \(\log_B n\),每个节点内二分要 \(\log_2 B\) 次比较,总数是
\[ \log_B n \cdot \log_2 B = \log_2 n, \]
与 \(B\) 无关。B+tree 省下的是缓存未命中(每层只碰一两条缓存行),不是比较次数;学习索引则用几次乘加替掉了上层的大部分比较。第五节的实验把这两件事分开计数。
数据分布决定拟合难度
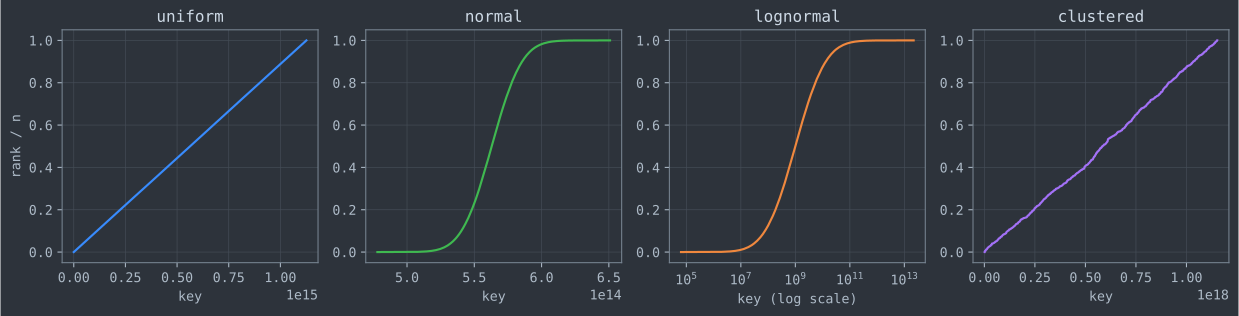
图中是本文实验用的四个合成数据集(每个取 100 万键画图,实验用 1000 万)。uniform 的 CDF 是一条直线,一条线段就够;normal 和 lognormal 是光滑曲线,分几十段就能拟合;clustered 由 1000 个宽度差几个数量级的高斯簇组成,整体看近似直线,放大后是一连串陡坡和平台,这类”整体平滑、局部突变”的数据正是学习索引的难点。生成方式见第五节。
二、谱系:从 RMI 到可更新结构
| 工作 | 发表 | 模型 | 误差 | 更新 | 分叉点 |
|---|---|---|---|---|---|
| RMI(Kraska 等) | SIGMOD 2018;arXiv 1712.01208 | 分阶段模型,末层线性 | 每叶记录,无全局上界 | 不支持 | 提出”索引即模型” |
| FITing-Tree(Galakatos 等) | SIGMOD 2019 | 分段线性,贪心 ShrinkingCone | 全局 \(\varepsilon\) | 页内预留 / 每段缓冲 | 把误差上界变成参数 |
| PGM-index(Ferragina、Vinciguerra) | PVLDB 13(8),2020 | 最优分段线性,递归分层 | 每层 \(\varepsilon\) | 追加 \(O(1)\) 摊还;对数方法 | 最少段数与最坏情况界 |
| RadixSpline(Kipf 等) | aiDM 2020 | 线性样条 + 基数表 | 样条误差 | 不支持 | 单遍构建、两个参数 |
| ALEX(Ding 等) | SIGMOD 2020 | 模型树 + 带间隙数组 | 无硬上界 | 模型位置插入、扩展/分裂 | 把 RMI 做成可更新 |
| LIPP(Wu 等) | PVLDB 14(8),2021 | 每节点线性模型,冲突建子节点 | 精确位置 | 冲突时下推 | 去掉最后一公里 |
评测与落地这一支同样重要:SOSD 先以 NeurIPS 2019 ML for Systems 研讨会论文发布,完整版 “Benchmarking Learned Indexes” 发表在 PVLDB 14(1)(2020);Wongkham 等人的 “Are Updatable Learned Indexes Ready?”(PVLDB 15(11),2022)把评测扩展到写入、并发与分布变化。系统集成方面,Bourbon(OSDI 2020)在 LSM 的每个 SSTable 上学分段线性模型;Google 的研讨会论文(NeurIPS 2020 ML for Systems,arXiv 2012.12501)把学习索引接进 Bigtable 的 SSTable 块索引。理论上,Ferragina、Lillo、Vinciguerra 的 “Why Are Learned Indexes So Effective?”(ICML 2020)第一次给出了段长的概率分析(第四节)。
Kraska 等人的论文还讨论了学习型哈希和学习型 Bloom filter。后者在 170 万条钓鱼 URL 上,用 0.0259 MB 的 GRU 模型加一个”溢出” Bloom filter,在 1% 误判率下把 2.04 MB 降到 1.31 MB(论文 5.2 节,减少 36%);这种做法依赖负样本分布,与传统 Bloom filter 的最坏情况保证不同,本文不展开,传统结构见 Bloom Filter 家族。
三、RMI:分阶段模型与每叶误差
结构与训练
一个模型很难同时拟合 CDF 的全局形状和局部细节,递归模型索引(Recursive Model Index,RMI)把问题分层:第 0 阶段的模型读入键,输出”该交给下一阶段的哪个模型”;最后一个阶段的模型输出位置。形式化地(论文 3.2 节),第 \(\ell\) 阶段有 \(M_\ell\) 个模型,第 \(\ell\) 阶段模型的输出按 \(\lfloor M_{\ell+1} f_\ell(k) / n \rfloor\) 选出下一阶段的模型,各阶段逐层训练:先用全部数据训练根,再把每个键交给根选中的叶子,各叶子只拟合分到自己的那部分键。阶段之间没有搜索,这与 B+tree 每层都要在节点里二分不同。
训练完成后,每个末级模型记录自己在所负责键上的最大低估和最大高估(论文称 min-error 与 max-error),查找窗口就是 \([p - e_{\mathrm{lo}},\ p + e_{\mathrm{hi}}]\)。论文 3.3 节的”混合索引”更进一步:误差超过阈值的叶子直接换成一棵 B-tree,用它给最坏情况兜底。
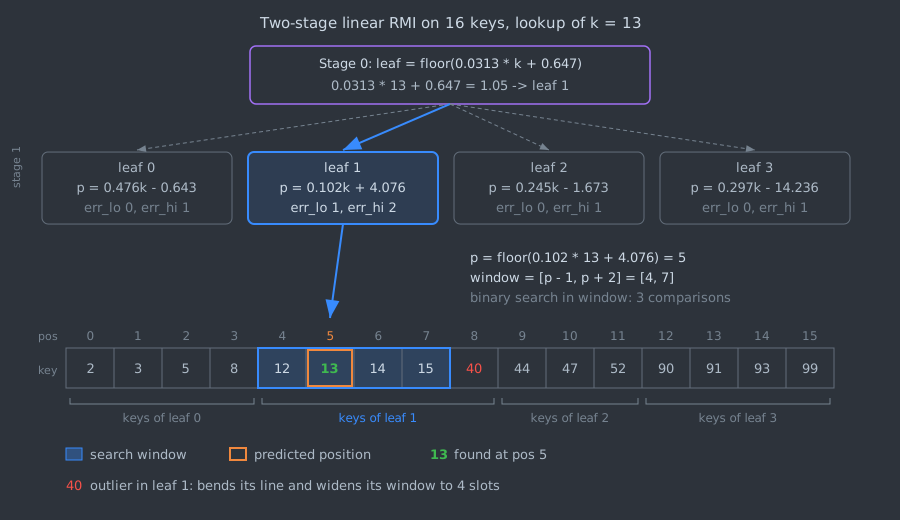
图中的数字由与 li_bench.cpp
相同的规则算出(最小二乘拟合、预测值向下取整)。根模型 \(\lfloor 0.0313k + 0.647
\rfloor\) 把 16 个键分成 4、5、3、4 个;叶子 1 分到了
12、13、14、15 和离群值 40,最小二乘直线被 40 拉平,于是 12
到 15 都被预测到位置 5 附近,误差区间变成 \([-1, +2]\),窗口 4
格,而其他叶子的窗口只有 2 格。这就是 RMI
的主要弱点:误差由数据决定,事先没有上界,一个离群值或一个簇就能让某个叶子的窗口变得很宽。
下面是 reproduce/li_bench.cpp 中 RMI
查找的核心,后半段处理不存在的键落在窗口外的情况:
// reproduce/li_bench.cpp, struct RMI, find();删去了计数代码、std:: 前缀与类型转换
size_t j = leaf_of(k);                       // stage 0: which leaf
const Leaf &f = leaves[j];
int64_t p = pred(f, k);                      // stage 1: position estimate
size_t lo = max<int64_t>(0, p - f.err_lo);
size_t hi = min<int64_t>(n, p + f.err_hi + 1);
size_t r = lower(a, lo, hi, k);              // last-mile binary search
// The window is exact for stored keys; an absent key may fall outside it.
if (r == lo && lo > 0) {
    if (a[lo - 1] >= k) r = lower(a, 0, lo - 1, k);
} else if (r == hi && hi < n) {
    if (a[hi] < k) r = lower(a, hi + 1, n, k);
}
return r;
原论文的数字与前提
Kraska 等人用两阶段 RMI(第二阶段 1 万到 20 万个线性模型)对比一个”类似 stx::btree、做了缓存行优化、100% 填充”的只读 B-tree,数据是约 2 亿个地图经度(Maps)、2 亿个网站请求时间戳(Weblogs)和 1.9 亿个对数正态样本(\(\mu=0\),\(\sigma=2\)),键和值都是 64 位。论文 Figure 4 以页大小 128 的 B-tree 为基准(它在 B-tree 各配置中查找最快):
| 数据集 | B-tree(页 128 键) | RMI,1 万叶 | RMI,10 万叶 |
|---|---|---|---|
| Maps | 13.11 MB,265 ns | 0.15 MB,98 ns | 1.53 MB,82 ns |
| Weblogs | 12.98 MB,260 ns | 0.15 MB,222 ns | 1.53 MB,144 ns |
| Lognormal | 12.46 MB,263 ns | 0.15 MB,178 ns | 1.53 MB,152 ns |
论文据此总结为”快 1.5 到 3 倍、小至多两个数量级”。读这张表要注意三点:论文没有给出 CPU 型号;表里的索引大小不含数据数组本身;B-tree 的”大小”随页大小变化,页 512 时同样只有 3 MB 左右(Figure 4 的其余行),所以”小两个数量级”是对页 128 这一行而言。第一阶段的模型经网格搜索在”0 到 2 个隐藏层”之间挑选,第二阶段一律是线性模型——论文自己的解释是最后一公里上不值得跑复杂模型。
调参才是 RMI 的主要成本
RMI 至少有四个维度要选:各阶段的模型类型、叶子数量、误差界怎么存、最后一公里用什么搜索。SOSD 基准里的 RMI 由 CDFShop(Marcus、Zhang、Kraska,SIGMOD 2020 演示论文)自动枚举配置;Maltry 与 Dittrich(PVLDB 15(5),2022)做了第一个”非原作者”的系统分析,结论是除了模型类型和层大小,误差界的存储方式和搜索算法同样必须一起考虑,并给出了一套无需枚举的配置指南,重写后的构建速度提高 2.5 到 6.3 倍。第五节的实验会看到,线性根模型在 clustered 数据上几乎失效,增加叶子数量也救不回来。
四、误差有界的分段线性:FITing-Tree、PGM-index 与 RadixSpline
把误差上界变成输入参数
另一条路线反过来:先规定最大误差 \(\varepsilon\),再用尽量少的线段满足它。一条线段 \(s(x) = \alpha (x - x_0) + \beta\) 称为 \(\varepsilon\)-近似的,如果它覆盖的每个点 \((A[i], i)\) 都满足 \(|s(A[i]) - i| \le \varepsilon\)。分段线性 \(\varepsilon\)-近似(piecewise linear approximation,PLA)问题要求用最少的 \(\varepsilon\)-近似线段覆盖全部点。有了它,最后一公里的窗口就被 \(\varepsilon\) 硬性封顶,不再取决于数据。
FITing-Tree(Galakatos 等,SIGMOD 2019)用贪心的 ShrinkingCone 算法切段:以段的第一个点为原点,维护一个”可行斜率锥”,每加入一个点就用 \((i \pm \varepsilon - y_0)/(x - x_0)\) 收窄锥的上下沿,新点落在锥外就开新段。这个算法 \(O(n)\)、常数内存,但不是最优的:线段被强制穿过段首点,而最优线段不必如此。论文附录 A.2 证明它可以比最优解任意差,Table 1 在真实数据上测得段数是最优的 1.05 到 1.6 倍。段之上再用一棵 B+tree 索引各段的首键。
最优 PLA:O’Rourke 的流式算法
PGM-index(Ferragina、Vinciguerra,PVLDB
13(8),2020)指出最优 PLA 早有线性时间解:O’Rourke 1981 年在
CACM 上的 “An on-line algorithm for fitting straight lines
between data ranges”。把每个点换成竖直区间 \([i-\varepsilon,\
i+\varepsilon]\),问题变成”能否用一条直线穿过所有区间”。算法维护上端点集合的下凸包和下端点集合的上凸包,以及由四个极端点构成的可行区域(PGM-index
源码里叫
rectangle);新区间到来时检查可行区域是否仍非空,非空就更新凸包,空了就输出一段、从当前点重新开始。每个点进出凸包各一次,总时间
\(O(n)\)。PGM 论文 Lemma 1
把它表述为:存在线性时间、线性空间的流式算法,求出最少段数。
Lemma 2 给出一个简单但关键的上界:
\[ m_{\mathrm{opt}} \le \frac{n}{2\varepsilon}. \]
证明只需一条水平线:任取连续 \(2\varepsilon\) 个键 \(A[i], \ldots, A[i+2\varepsilon-1]\),直线 \(y = i + \varepsilon\) 到这些点的纵向距离都不超过 \(\varepsilon\),所以最优解的每一段至少覆盖 \(2\varepsilon\) 个键。这意味着最优 PLA 在最坏情况下也不会比”每 \(2\varepsilon\) 个键一个分隔键”的 B+tree 叶层上一级更大。
reproduce/li_bench.cpp 里的
OptPLA 移植自 PGM-index(commit
c6fcf3d,include/pgm/piecewise_linear_model.hpp,OptimalPiecewiseLinearModel),去掉了重复键处理。reproduce/pla_crosscheck.cpp
把它和库里的 make_segmentation
放在同一批数据上比较:四个数据集、\(\varepsilon \in \{8, 64, 512,
4096\}\)、\(n =
10^7\),16 组段数完全相同。
段为什么这么长
实测中段数远小于 \(n/(2\varepsilon)\)。Ferragina、Lillo、Vinciguerra(ICML 2020)给了第一个概率解释:若相邻键的间隔 \(g_i = A[i+1] - A[i]\) 独立同分布,均值 \(\mu\)、方差 \(\sigma^2\),且 \(\varepsilon\) 远大于 \(\sigma/\mu\),则斜率取 \(1/\mu\) 的线段在误差 \(\varepsilon\) 内平均覆盖
\[ \frac{\mu^2}{\sigma^2}\,\varepsilon^2 \]
个键(论文 Theorem 1),而且 \(1/\mu\) 是期望意义下最好的斜率(Theorem 2)。直观上,位置误差是间隔偏差的累加,像一次随机游走,走出 \(\pm\varepsilon\) 的带子平均需要 \(\Theta(\varepsilon^2)\) 步。均匀随机键的间隔近似指数分布,\(\mu^2/\sigma^2 \approx 1\),预测是 \(\varepsilon^2\) 个键一段。这个结论只针对固定斜率的线段,最优 PLA 可以做得更好;第五节的 uniform 数据上,\(\varepsilon = 8\) 时最优 PLA 每段平均覆盖 265.7 个键,是 \(\varepsilon^2 = 64\) 的 4 倍多。
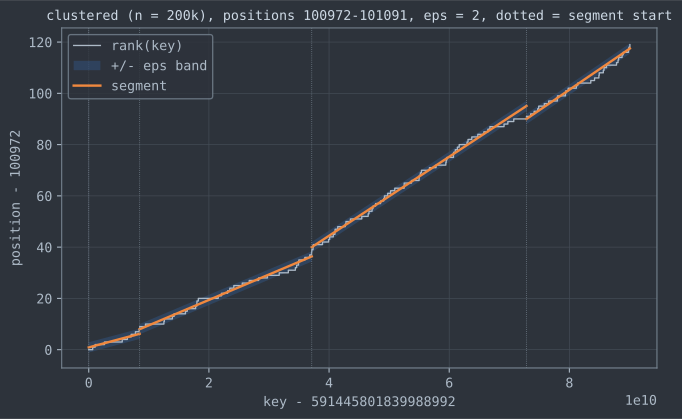
图中是 clustered 数据集(\(n = 2\times10^5\))中间一段 120 个键、\(\varepsilon = 2\) 的最优 PLA。每条橙线只负责到下一段起点为止,阶梯在它覆盖的键上始终落在蓝色误差带里;密度一变(阶梯斜率变化),就需要开新段。相邻两段在断点处不连续也没关系,查找时只用”首键不超过 \(k\) 的最后一段”。
递归:用 PLA 索引 PLA
段数为 \(m\) 时,还要找到”首键不超过 \(k\) 的最后一段”。FITing-Tree 用 B+tree 做这件事;PGM-index 把段的首键再当作一个有序数组,用误差 \(\varepsilon_r\) 再做一次 PLA,如此递归,直到只剩一段。查找从根开始,每层用选中的线段预测下一层的位置,在一个很小的窗口里找到正确的段。
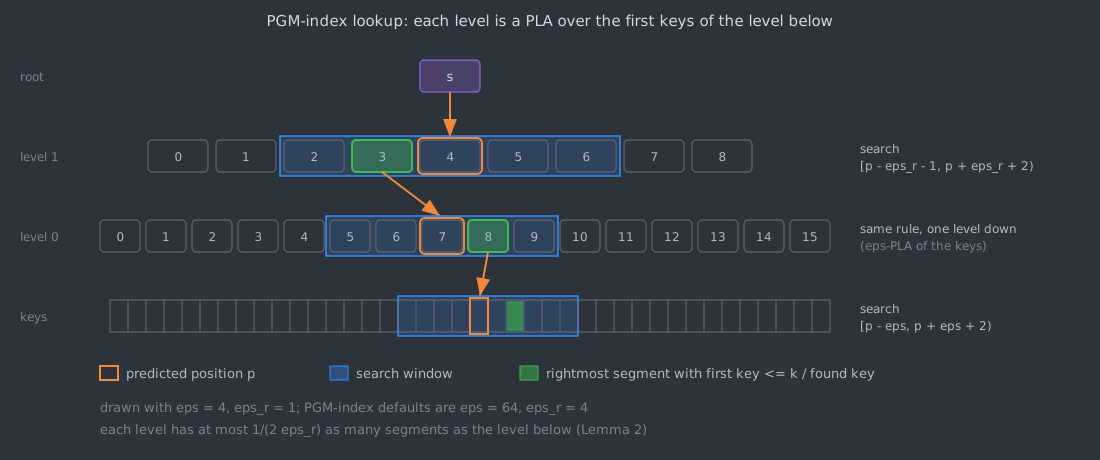
图中取 \(\varepsilon =
4\)、\(\varepsilon_r =
1\) 以便画出来;PGM-index 库
PGMIndex<K, Epsilon = 64, EpsilonRecursive = 4>
的默认值是 64 和 4。上层窗口取 \([p-\varepsilon_r-1,\
p+\varepsilon_r+2)\)、底层取 \([p-\varepsilon,\
p+\varepsilon+2)\),与库中
segment_for_key() 和 search() 的
PGM_SUB_EPS/PGM_ADD_EPS 一致。由
Lemma 2,每层段数至多是下一层的 \(1/(2\varepsilon_r)\),层数为
\(O(\log_c m)\),\(c \ge 2\varepsilon\)。PGM 论文
Theorem 1 据此给出:空间 \(\Theta(m)\),查询时间 \(O(\log m + \log
\varepsilon)\),外存模型下 \(O(\log_c m \cdot
\log(\varepsilon/B))\) 次 I/O。
库里的一个段是 16 字节(#pragma pack 的 64
位首键、float 斜率、uint32_t
截距)。本文的实现用 double 斜率和 64
位截距,每段 24 字节,第五节的索引大小按 24 字节计。
RadixSpline:一遍扫描、两个参数
RadixSpline(Kipf 等,aiDM@SIGMOD 2020,作者包括 Neumann)换了一种模型:不是互不相连的线段,而是一条连续的线性样条。构建时用 GreedySplineCorridor 在排好序的数据上一遍扫描,选出一组样条节点(knot),保证在相邻两个节点之间线性插值的误差不超过 \(e\)。节点本身再用一张基数表(radix table)索引:取键去掉公共前缀后的前 \(r\) 位作为下标,表项给出候选节点的范围,在这个范围里找到夹住 \(k\) 的两个节点,插值得到位置,最后在 \(\pm e\) 的窗口内搜索。
它只有两个超参数:样条误差 \(e\) 和基数位数 \(r\),论文强调两者对大小和延迟的影响直观可靠,实现约一百行 C++。代价也写在论文里:数据严重倾斜时,大部分键挤在少数几个基数前缀下,基数表基本失效,需要退化为树状的基数结构或单独处理离群值。本文的实验没有实现 RadixSpline,它与 PGM、RMI 的横向比较见第七节引用的 SOSD 结果。
五、实验:同一批键上的比较次数、缓存行与索引大小
设置
reproduce/li_bench.cpp 在同一个排好序的
uint64_t
数组上实现四种结构,全部只读、单线程:
- 二分查找:
std::lower_bound的等价实现,作为基线。 - 静态 B+tree:隐式布局(类似 CSS-tree),每页 \(B\) 个键,内层只存各子页首键,页内二分;\(B \in \{16, 64, 256, 1024\}\)。
- PGM:第四节的最优 PLA 加递归层,\(\varepsilon \in \{8, 32, 128, 512, 2048\}\),\(\varepsilon_r = 4\)。
- RMI:线性根模型加 \(M\) 个线性叶子,每叶存低估与高估误差,\(M \in \{2^{10}, 2^{12}, \ldots, 2^{20}\}\)。
四个合成数据集各生成 \(10^7\) 个 64
位键(mt19937_64,排序去重后略少于 \(10^7\)):uniform 在 \([0, 2^{50})\) 上均匀;normal 取
\(\mathcal{N}(2^{49},
2^{44})\);lognormal 仿照 Kraska 论文取 \(\mu=0\)、\(\sigma=2\) 再乘以 \(10^9\);clustered 由 1000
个高斯簇组成,簇心在 \([2^{40},
2^{60})\) 上均匀,标准差在 \(2^{20}\) 到 \(2^{36}\)
之间按指数均匀选取。每个数据集随机抽 \(10^6\) 个已存在的键做查询。
每次查询统计两个与机器无关的量:键比较次数(包括上层结构里的比较)和访问的不同 64 字节缓存行数(包括模型参数所在的行)。计时是次要指标:同一组查询连续跑 3 遍取中位数,查询之间没有数据依赖,CPU 可以重叠相邻查询,所以测的是吞吐意义上的平均耗时,不是单次延迟。索引大小只算索引本身,不含数据数组:B+tree 按每个内层键 8 字节,PGM 按每段 24 字节,RMI 按每叶 24 字节加根模型 16 字节。
正确性检查:./li_bench test
在四个数据集、\(n \in \{1, 2, 3,
10, 10^3, 10^5, 10^6\}\) 上,对存在和不存在的键逐一与
std::lower_bound 比对,并逐点验证每个 PLA
段的误差不超过 \(\varepsilon\);这组测试也在
AddressSanitizer 与 UndefinedBehaviorSanitizer 下跑过。
环境:Intel Core i9-12900K(L3 30 MiB),31 GB
内存,WSL2(Linux 6.6.87.2),g++ 16.1.1
-O2,计时绑定在 CPU 4 上;Python
3.14.5、matplotlib 3.11.2 作图。复现:
cd reproduce
sh run.sh 4          # build, test, write results/*.txt, redraw the four SVGs
# optional: cross-check OptPLA against the PGM-index library
git clone https://github.com/gvinciguerra/PGM-index && git -C PGM-index checkout c6fcf3d
g++ -std=c++17 -O2 -I PGM-index/include -o pla_crosscheck pla_crosscheck.cpp && ./pla_crosscheck
数据集与段数
四个数据集的 CDF 见第一节的图。
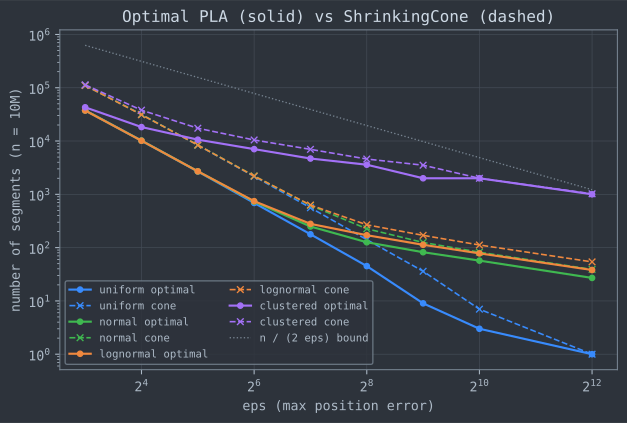
| 数据集 | \(\varepsilon=8\) 最优 / 贪心 | \(\varepsilon=64\) 最优 / 贪心 | \(\varepsilon=512\) 最优 / 贪心 | \(\varepsilon=4096\) 最优 / 贪心 |
|---|---|---|---|---|
| uniform | 37,635 / 110,822 | 689 / 2,167 | 9 / 36 | 1 / 1 |
| normal | 37,552 / 110,932 | 730 / 2,217 | 82 / 125 | 27 / 39 |
| lognormal | 37,337 / 110,396 | 744 / 2,202 | 113 / 170 | 38 / 54 |
| clustered | 42,929 / 113,268 | 7,046 / 10,466 | 2,001 / 3,521 | 1,000 / 1,023 |
几点观察:
- 最优 PLA 比贪心少约三分之二的段。uniform 上 \(\varepsilon\) 从 16 到 256,ShrinkingCone 的段数一直是最优解的 3.1 倍左右,对应减少约 68%,与 PGM 论文 Table 2 在合成数据上报告的 20% 到 75% 的减少幅度一致。\(\varepsilon\) 变大后差距缩小,clustered 在 \(\varepsilon = 4096\) 时两者都接近”每簇一段”。
- 小 \(\varepsilon\) 下分布几乎无关。\(\varepsilon = 8\) 时四个数据集都是 3.7 万到 4.3 万段,远低于 Lemma 2 的上界 \(n/(2\varepsilon) = 6.25 \times 10^5\)。此时决定段长的是相邻间隔的随机波动(第四节的 \(\varepsilon^2\) 规律),而不是 CDF 的整体形状。
- 大 \(\varepsilon\) 下只剩全局形状。\(\varepsilon = 4096\) 时 uniform 一段就够,normal 与 lognormal 需要二三十段来描出 S 形,clustered 至少要 1000 段。Wongkham 等人正是用这两个尺度定义数据”难度”:\(\varepsilon = 4096\) 的段数衡量全局难度,\(\varepsilon = 32\) 的段数衡量局部难度。按这个定义,本文四个数据集的全局难度分别是 1、27、38、1000,局部难度分别是 2683、2702、2700、10603,clustered 在两个尺度上都最难。
查找代价与索引大小
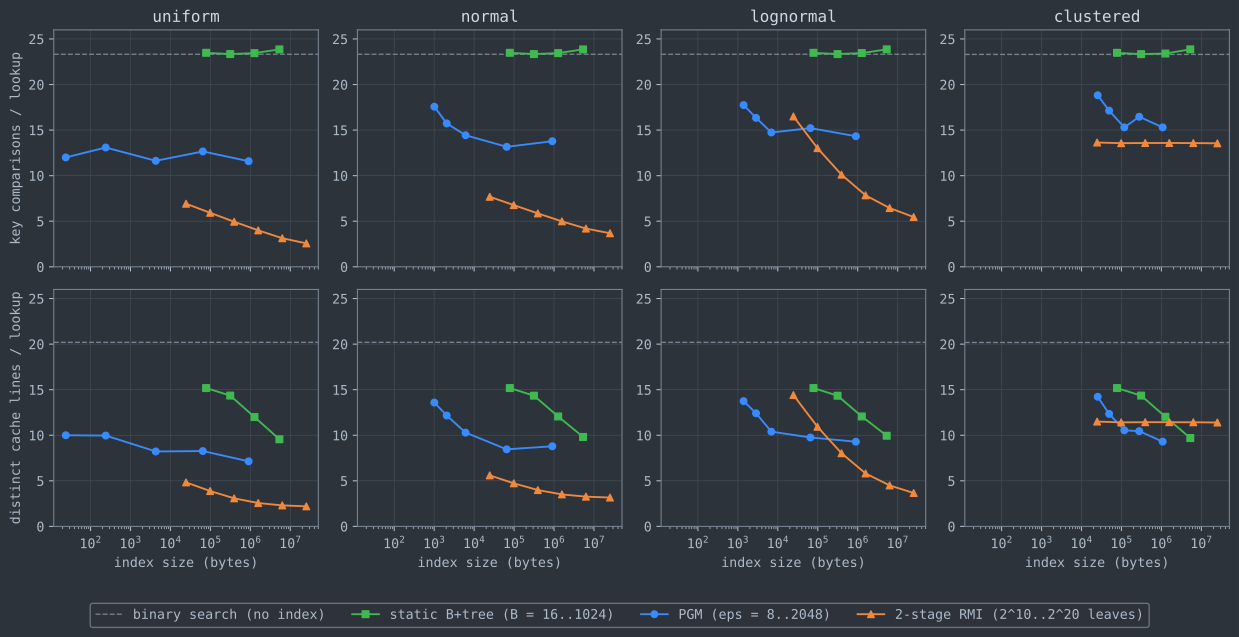
从 results/bench.txt
中挑出的配置如下,比较次数与缓存行为每次查找的平均值:
| 数据集 | 结构与参数 | 索引大小 | 比较次数 | 缓存行 | 耗时(ns) |
|---|---|---|---|---|---|
| 各数据集 | 二分查找 | 0 | 23.3 | 20.2 | 261–271 |
| uniform | B+tree,\(B=16\) | 5.33 MB | 23.86 | 9.56 | 182 |
| uniform | B+tree,\(B=1024\) | 78 KB | 23.48 | 15.18 | 240 |
| uniform | PGM,\(\varepsilon=8\) | 906 KB | 11.59 | 7.14 | 121 |
| uniform | PGM,\(\varepsilon=2048\) | 24 B | 12.00 | 10.00 | 197 |
| uniform | RMI,\(M=2^{18}\) | 6.29 MB | 3.13 | 2.30 | 48 |
| normal | PGM,\(\varepsilon=32\) | 65 KB | 13.16 | 8.46 | 126 |
| normal | RMI,\(M=2^{10}\) | 25 KB | 7.68 | 5.60 | 95 |
| lognormal | PGM,\(\varepsilon=8\) | 899 KB | 14.33 | 9.29 | 133 |
| lognormal | RMI,\(M=2^{10}\) | 25 KB | 16.50 | 14.41 | 385 |
| lognormal | RMI,\(M=2^{20}\) | 25.2 MB | 5.46 | 3.66 | 76 |
| clustered | B+tree,\(B=16\) | 5.28 MB | 23.86 | 9.70 | 180 |
| clustered | PGM,\(\varepsilon=8\) | 1.08 MB | 15.30 | 9.30 | 151 |
| clustered | PGM,\(\varepsilon=2048\) | 25 KB | 18.82 | 14.22 | 304 |
| clustered | RMI,任意 \(M\) | 25 KB–25 MB | 13.55–13.64 | 11.4–11.5 | 224–244 |
B+tree 的页大小只改变缓存行,不改变比较次数。 四种页大小的比较次数都在 23.3 到 23.9 之间,与二分查找相同,正是第一节 \(\log_B n \cdot \log_2 B = \log_2 n\) 的结果;变化的是缓存行,\(B = 16\) 时从二分的 20.2 行降到 9.6 行,耗时从约 270 ns 降到 182 ns。所以”学习索引 vs B+tree”的比较,实质是在比谁用更少的字节换来更少的缓存未命中和更少的比较。
PGM 在比较次数上稳定地比 B+tree 少,大小取决于数据。 uniform 上一个 24 字节的段就把比较次数压到 \(\log_2(2\varepsilon + 2) \approx 12\);其他三个数据集需要 13 到 19 次比较,clustered 上达到同样比较次数要多花一个数量级的空间(\(\varepsilon = 2048\) 时 25 KB,uniform 只要 24 B)。窗口有硬上界,所有配置的比较次数和缓存行都少于二分查找;但耗时不一定:clustered 上 \(\varepsilon = 2048\) 时 PGM 要 304 ns,比二分的 261 ns 还慢,尽管它的比较少 4.5 次、缓存行少 6 行。本文没有用硬件计数器定位原因,只能说明比较次数与缓存行数不能直接换算成耗时。
RMI 的上限最高,下限也最低。 uniform 上 \(2^{18}\) 个叶子只需 3.1 次比较、48 ns,是全表最快;但 lognormal 上 \(2^{10}\) 个叶子时平均 16.5 次比较、385 ns,比二分查找还慢,因为线性根模型把大部分键分给了少数叶子,最大窗口达到 997,632 个位置。clustered 上它对 \(M\) 完全不敏感:簇宽(标准差不超过 \(2^{36}\))远小于键域(\(2^{60}\)),线性根模型几乎总把一整个簇交给同一个叶子,叶子数再多也只是增加空叶子,最大窗口始终在 3.2 万到 3.7 万之间。这就是第三节说的”误差事先没有上界”,也是 CDFShop 和 Maltry 的工作要解决的调参问题;换成三次样条根模型或非线性根模型会改善,但本文没有实现。
这组实验不能说明什么
- 数据集全部是合成的,没有 SOSD 的 amzn、face、osm、wiki 那样的真实分布;clustered 只是对”局部难”的粗略模仿。
- 索引大小不含数据数组。B+tree 若把值和键放在一起、每页留空隙以便插入,真实开销会大得多;学习索引若要支持插入,同样要付出空隙或缓冲区的代价(第六节)。
- 耗时是在 WSL2 上、单核、吞吐方式测得的,只用于相对比较,不应和论文的绝对数字对照;比较次数和缓存行才是本实验的主要结论。
- 两种学习索引都是简化实现:PGM 的段比库多 8 字节,RMI 只有线性模型。它们的相对位置可以参考,具体大小和耗时不代表各自的最优调参。
六、可更新的学习索引:空隙、缓冲与冲突子节点
只读结构里,模型只需拟合一次。插入一个键会让它之后所有键的 rank 加一,严格说整条 CDF 都变了。各家的办法可以归为三类:在数组里预留空隙、把新键放进缓冲区、或者干脆让模型决定位置。
缓冲区与对数方法
FITing-Tree 给了两种策略(论文第 5 节)。原地插入把误差 \(\varepsilon\) 拆成分段误差 \(e\) 和插入预算 \(\delta\),\(\varepsilon = e + \delta\);每页大小为 \(|s| + 2\delta\),数据放在中间、两端留空,新键插入时整体向较近的一端移动,空位用完就重新分段。增量插入给每段配一个固定大小、保持有序的缓冲区,查找时同时搜数据和缓冲区,缓冲区满了就与段合并并重新分段,缓冲区大小同样要计入误差参数。
PGM-index 对追加写(时间序列)做到了 \(O(1)\) 均摊:新键若能被最后一段在 \(\varepsilon\) 内覆盖就结束,否则开新段并递归到上一层。对任意位置的插入,它套用动态化静态结构的经典技巧——对数方法(logarithmic method):维护一组大小为 \(2^0, 2^1, \ldots, 2^b\) 的静态 PGM,插入时找到第一个空的集合 \(S_i\),把 \(S_0, \ldots, S_{i-1}\) 与新键归并后重建为 \(S_i\);每个键至多参与 \(O(\log n)\) 次归并,插入均摊 \(O(\log n)\)。删除用墓碑。代价是查询要查 \(O(\log n)\) 个结构——这与 LSM-tree 的思路相同,参见 B+tree 与 LSM-tree。
ALEX:带空隙的数组与模型驱动的插入
ALEX(Ding 等,SIGMOD 2020)让模型直接决定键在数组里的位置。每个数据节点是一个带空隙的数组(gapped array):构建时用模型把键放到预测位置上,冲突的键顺延,于是键大多正好落在模型预测处。空隙里存它右侧最近那个键的副本,这样数组仍然有序、可以直接做指数搜索,另用一张位图标出哪些槽是空隙。
插入时先用模型预测位置;若该位置能保持有序且是空隙就直接放入,否则把键向最近的空隙方向平移一格。最后一公里用指数搜索而不是二分:从预测位置向外倍增步长,代价是 \(O(\log e)\),\(e\) 为实际误差,而不需要事先存误差上界。若下一次插入会让节点的键密度超过上界 \(d_u\),节点即视为满,按代价模型选择扩容重训或分裂;默认 \(d_l = 0.6\)、\(d_u = 0.8\),使平均空间利用率约为 0.7,与 B+Tree 相近。内部节点也是线性模型加指针数组,形状由代价模型自适应决定,不是固定的两层。
论文在 Intel Core i9-9900K、64 GB 内存上测得:与 B+Tree 相比吞吐最高 4.1 倍、索引最多小 2000 倍;与只读的学习索引相比吞吐最高 2.2 倍、索引最多小 15 倍。ALEX 的最后一公里代价没有硬上界,数据分布不利时指数搜索的距离会变长。
LIPP:让每个键都在预测位置上
LIPP(Wu 等,PVLDB 14(8),2021)更进一步:每个节点的槽位有三种状态——空(NULL)、存一个键(DATA)、指向子节点(NODE)。查找时用模型算出槽位,是 DATA 就比较一次,是 NODE 就进入子节点,重复下去,完全没有最后一公里搜索。插入时若预测槽已被占用,就在该槽创建一个子节点,把两个键都放进去,所以冲突变成了树的深度,而不是一条链。
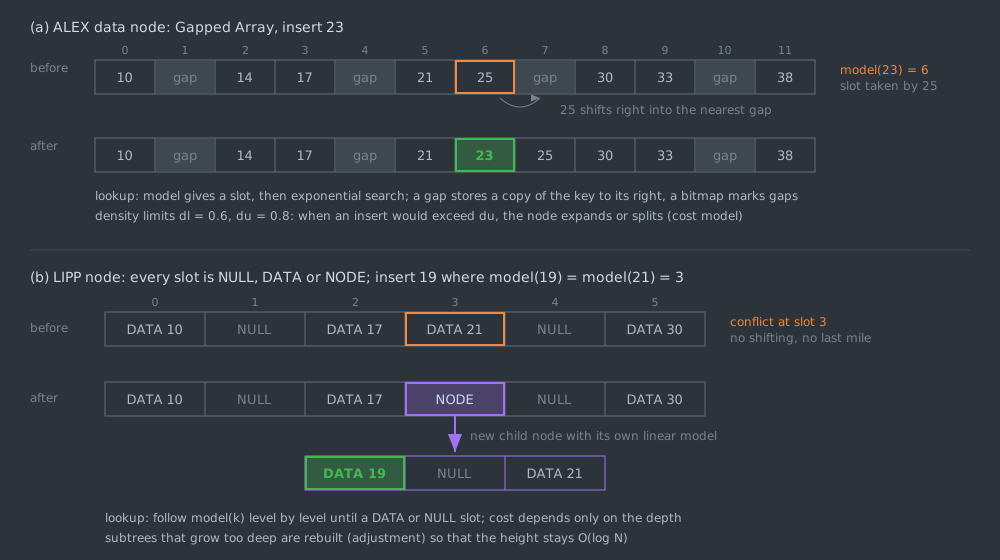
深度要受控才行。LIPP 用 FMCD(fastest minimum conflict degree)算法为每个节点选线性模型,使落在同一槽的键数(冲突度)最小;节点里冲突过多或层数失衡时,调整策略会重建子树。论文 Theorem 5.1 与 5.2 证明树高至多 \(O(\log N)\);实验在 4.0 GHz 的 Intel Core i7(4 核 8 线程)、32 GB 内存上单线程运行,报告比当时最好的方法最高快 4 倍。它的代价是空槽多、节点大,以及查找路径随插入变深。
进入系统的尝试
- Bourbon(Dai 等,OSDI 2020)在 WiscKey 的每个 SSTable 上学习分段线性模型,并用代价模型决定哪些文件值得学习。LSM 的 SSTable 一经写出就不再修改,正好规避了模型更新的问题;论文报告查找比 WiscKey 快 1.23 到 1.78 倍。
- Bigtable:Abu-Libdeh 等人的 workshop 论文(arXiv 2012.12501,预印本)在 Bigtable 里用学习索引替换了 SSTable 块索引,报告点查延迟降低 36%、扫描延迟降低 22%,点查吞吐提高 55%、扫描吞吐提高 28%。这是学习索引进入生产级存储系统的少数公开记录之一。
七、争论与开放问题
对手是不是调好的 B+tree
最早的反驳来自 Thomas Neumann 2017 年 12 月 23 日的博客 “The Case for B-Tree Index Structures”。他的论点是:B+tree 的内层本来就是 CDF 的一种近似,把相邻分隔键之间的位置做线性插值,就是一条样条;再把页大小调到与 RMI 相同的字节数来比较。在 Kraska 论文的 Maps 与 Lognormal 数据上,他报告的平均误差如下(B-tree 按整个数据集平均,RMI 的数字取自原论文):
| 数据 | 结构(大小) | 平均误差 |
|---|---|---|
| Maps | RMI,1 万叶(0.15 MB) | 8 ± 45 |
| Maps | 插值 B-tree(0.15 MB) | 225 |
| Maps | 插值 B-tree(1.53 MB) | 22 |
| Lognormal | RMI,10 万叶(1.53 MB) | 17,005 ± 60,959 |
| Lognormal | 插值 B-tree(0.15 MB) | 1,330 |
| Lognormal | 插值 B-tree(1.53 MB) | 3 |
在 Lognormal 上,他的原型(i7-5820K @ 3.30 GHz,以乱序查找全部元素)用 0.15 MB 的 B-tree 测得 156 ns,而论文报告的 10 万叶 RMI 是 152 ns。Neumann 自己强调这是”苹果和橘子”的比较:硬件不同,原论文代码也未公开。Kraska 在评论中回应:他们早期试过这种插值 B-tree,速度大约是最好的学习索引的一半;论文里的记录带有 payload,这也会影响耗时。这次交锋没有结论,但确立了之后所有评测的基本要求:同一台机器、同一份数据、对手也要调参。
SOSD:只读、内存、稠密数组
Marcus 等人的 “Benchmarking Learned Indexes”(PVLDB 14(1),2020)就是按这个要求做的,作者同时包括 Neumann 与 Kraska。平台是 Xeon Gold 6230、256 GB 内存,数据是 amzn、face、osm、wiki 四个真实数据集,各 2 亿个 64 位键。它的 Table 2 在 32 位 amzn 键上列出了各结构的最佳配置:
| 结构 | 查找(ns) | 大小 |
|---|---|---|
| RMI | 180.90 | 48 MB |
| RadixSpline | 266.58 | 4 MB |
| PGM | 326.48 | 14 MB |
| FAST | 435.33 | 102 MB |
| 插值 B-tree(IBTree) | 446.55 | 9 MB |
| B-tree | 482.11 | 166 MB |
| 二分查找 | 741.69 | 0 |
| CuckooMap | 114.50 | 1541 MB |
| RobinHash | 93.69 | 6144 MB |
结论是:在只读、内存中、稠密有序数组这一场景下,学习索引在大小与延迟的帕累托前沿上占优;但哈希表在点查上仍更快,代价是大得多的内存,而且不支持范围查询(参见 Cuckoo Hashing)。论文还发现一个容易被忽略的效应(4.4.2 节、Figure 15):在两次查找之间插入内存屏障后,RMI 与 RadixSpline 慢了约 50%,而 B-tree、FAST、PGM 几乎不受影响——学习索引的一部分优势来自 CPU 能把相邻查找的模型计算与内存访问重叠起来。第五节的计时方式恰好有利于这一点,这也是本文只把耗时当作相对参考的原因之一。
动态场景:GRE 基准
Wongkham 等人(PVLDB 15(11),2022)把问题推到读写混合、并发的场景,在 4 路 24 核 Xeon Platinum 8268、768 GB 内存上比较 ALEX、LIPP、PGM 等学习索引与 STX B+-tree、ART、HOT、Masstree、Wormhole 等传统结构。他们用第五节提到的全局/局部难度把数据集铺成一个平面,结论有好有坏:
- 单线程下,ALEX 与 LIPP 在超过 80% 的”数据 × 负载”组合里比 ART、Masstree、HOT、Wormhole 快;
- 算上叶层的键和位置,学习索引端到端最多只小 3.2 倍,远不是”两个数量级”;
- LIPP 对并发不友好、空间效率也不高,ALEX+ “几乎可用”;写密集负载下他们推荐 LSM 式的索引;传统索引对分布漂移更稳健。
他们还指出,常用的 fb 数据集是上采样得到的,osm 本质上也不是一维数据,提醒读者在这两个数据集上得出的结论不宜直接推广。
调参与构建代价
RMI 的构建和调参成本在 SOSD 里已经是主要缺点,CDFShop 与 Maltry、Dittrich 的工作把配置空间系统化了(第三节)。PGM 与 RadixSpline 一遍扫描、参数少,这是它们在工程上更容易被采用的原因。
仍然开放的问题
- 怎样事先判断数据”好不好学”。 PLA 段数是目前最实用的难度指标,但 Wongkham 自己承认 \(\varepsilon = 4096\) 和 \(32\) 是经验选取的;ICML 2020 的 \(\varepsilon^2\) 结论依赖间隔独立同分布,真实数据往往不满足。
- 字符串与变长键。 本文的实验和 SOSD 都只针对定长整数键;变长字符串键上模型怎样计算、误差怎样界定,不在这些基准的覆盖范围内。Wongkham 也提到 HOT、Wormhole 这类传统结构本就是为长字符串键设计的。
- 更新、并发与分布漂移。 模型重训的时机、并发控制、以及分布变化时的退化,都还没有像 B+tree 那样成熟的答案;Neumann 在上述博客评论里也指出,预留空间用完后插入迟早要付出代价。
八、工程选型与常见陷阱
| 场景 | 更合适的选择 | 理由与陷阱 |
|---|---|---|
| 只读、内存中的有序整数数组,要范围查询 | PGM-index 或 RadixSpline | 一遍构建、误差有硬上界、参数少;先用 PLA 段数估计数据难度,再定 \(\varepsilon\) |
| 只读、分布平滑、追求极致点查 | 调过参的 RMI | 需要 CDFShop 之类的工具搜配置;务必检查最大窗口,不能只看平均误差 |
| 只有点查、内存充足 | 哈希表 | SOSD 上 CuckooMap、RobinHash 比所有有序结构都快,代价是数十倍的内存 |
| 读多写少、单线程 | ALEX 或 LIPP | GRE 在单线程下测得它们多数情况优于传统索引;LIPP 空间开销大 |
| 写密集或高并发 | B+tree(带乐观锁)或 LSM-tree | GRE 推荐 LSM 式结构;学习索引的并发版本还不成熟 |
| LSM 的 SSTable 内部 | 在不可变文件上学模型(Bourbon、Bigtable 的做法) | 文件不再修改,模型只需构建一次;要为每个文件决定是否值得学习 |
几个容易踩的坑:
- 把平均误差当成窗口。 第五节 lognormal 上 \(2^{10}\) 叶的 RMI 平均只需 16.5 次比较,最大窗口却接近 100 万个位置;尾延迟由最大窗口决定。
- 忘了不存在的键。 误差界只对训练时见过的键成立,非单调模型对新键可能给出任意位置,需要第三节那样的边界回退。
- 和没调参的 B+tree 比。 B+tree 的页大小、节点内搜索方式、是否插值都会改变结论,对比时要把两边都调到各自的最佳(第七节)。
- 只看紧循环的吞吐。 真实系统里查找之间有别的工作,SOSD 的内存屏障实验说明紧循环会高估部分学习索引。
九、参考资料
规范与文档
- PGM-index 文档与
API:
PGMIndex<K, Epsilon, EpsilonRecursive>,默认Epsilon = 64、EpsilonRecursive = 4,https://pgm.di.unipi.it/。
源码
- PGM-index(commit
c6fcf3d):
include/pgm/piecewise_linear_model.hpp(OptimalPiecewiseLinearModel、make_segmentation)、include/pgm/pgm_index.hpp(Segment、segment_for_key、search、PGM_SUB_EPS/PGM_ADD_EPS),https://github.com/gvinciguerra/PGM-index。
核心论文
- T. Kraska, A. Beutel, E. H. Chi, J. Dean, N. Polyzotis, “The Case for Learned Index Structures”, SIGMOD 2018, pp. 489–504, doi:10.1145/3183713.3196909.
- A. Galakatos, M. Markovitch, C. Binnig, R. Fonseca, T. Kraska, “FITing-Tree: A Data-aware Index Structure”, SIGMOD 2019, doi:10.1145/3299869.3319860.
- P. Ferragina, G. Vinciguerra, “The PGM-index: a fully-dynamic compressed learned index with provable worst-case bounds”, PVLDB 13(8):1162–1175, 2020, doi:10.14778/3389133.3389135.
- A. Kipf, R. Marcus, A. van Renen, M. Stoian, A. Kemper, T. Kraska, T. Neumann, “RadixSpline: A Single-Pass Learned Index”, aiDM@SIGMOD 2020, doi:10.1145/3401071.3401659.
- J. Ding, U. F. Minhas, J. Yu, C. Wang, J. Do, Y. Li, H. Zhang, B. Chandramouli, J. Gehrke, D. Kossmann, D. Lomet, T. Kraska, “ALEX: An Updatable Adaptive Learned Index”, SIGMOD 2020, pp. 969–984, doi:10.1145/3318464.3389711.
- J. Wu, Y. Zhang, S. Chen, J. Wang, Y. Chen, C. Xing, “Updatable Learned Index with Precise Positions”, PVLDB 14(8):1276–1288, 2021, doi:10.14778/3457390.3457393.
- R. Marcus, A. Kipf, A. van Renen, M. Stoian, S. Misra, A. Kemper, T. Neumann, T. Kraska, “Benchmarking Learned Indexes”, PVLDB 14(1):1–13, 2020, doi:10.14778/3421424.3421425.
- C. Wongkham, B. Lu, C. Liu, Z. Zhong, E. Lo, T. Wang, “Are Updatable Learned Indexes Ready?”, PVLDB 15(11):3004–3017, 2022, doi:10.14778/3551793.3551848.
其他论文
- J. O’Rourke, “An On-Line Algorithm for Fitting Straight Lines Between Data Ranges”, Communications of the ACM 24(9):574–578, 1981.
- P. Ferragina, F. Lillo, G. Vinciguerra, “Why Are Learned Indexes So Effective?”, ICML 2020, PMLR 119;期刊扩展版 “On the performance of learned data structures”, Theoretical Computer Science 871:107–120, 2021, doi:10.1016/j.tcs.2021.04.015.
- M. Maltry, J. Dittrich, “A Critical Analysis of Recursive Model Indexes”, PVLDB 15(5):1079–1091, 2022, doi:10.14778/3510397.3510405.
- R. Marcus, E. Zhang, T. Kraska, “CDFShop: Exploring and Optimizing Learned Index Structures”, SIGMOD 2020 演示论文, pp. 2789–2792, doi:10.1145/3318464.3384706.
- A. Kipf, R. Marcus, A. van Renen, M. Stoian, A. Kemper, T. Kraska, T. Neumann, “SOSD: A Benchmark for Learned Indexes”, NeurIPS 2019 ML for Systems Workshop,arXiv:1911.13014(预印本).
- Y. Dai, Y. Xu, A. Ganesan, R. Alagappan, B. Kroth, A. C. Arpaci-Dusseau, R. H. Arpaci-Dusseau, “From WiscKey to Bourbon: A Learned Index for Log-Structured Merge Trees”, OSDI 2020.
- H. Abu-Libdeh, D. Altınbüken, A. Beutel, E. H. Chi, L. Doshi, T. Kraska, et al., “Learned Indexes for a Google-scale Disk-based Database”, NeurIPS 2020 ML for Systems Workshop,arXiv:2012.12501(预印本).
工程资料
- T. Neumann, “The Case for B-Tree Index Structures”, Database Architects 博客, 2017-12-23,https://databasearchitects.blogspot.com/2017/12/the-case-for-b-tree-index-structures.html(含 Kraska 等人在评论区的回应)。
实验
reproduce/li_bench.cpp:二分查找、静态 B+tree、PGM、两阶段 RMI 的实现与正确性测试;第五节全部数字。reproduce/pla_crosscheck.cpp:与 PGM-index 库的段数交叉验证。reproduce/run.sh、reproduce/plot.py:生成reproduce/results/(segs.txt、bench.txt、dump.txt)与dataset-cdfs.svg、pla-error-band.svg、segments-vs-eps.svg、lookup-cost-vs-size.svg。
系列导航: - 上一篇:MVCC 实现变体:版本存储、快照可见性与写偏斜 - 下一篇:TCP 拥塞控制:从 Reno 到 BBRv3
相关阅读: - B-tree 深度解剖:从磁盘 I/O 模型到 boltdb 源码 - B+tree 与 LSM-tree:原地更新与异地更新的读、写、空间代价 - Bloom Filter 家族:从位数组到 Ribbon,每键位数离下界还差多少 - Cuckoo Hashing:用两个位置换取最坏情况常数查找
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【数据库前沿】【数据库研究前沿】学习型索引再审视:RMI、ALEX、PGM
从 Kraska 2018 RMI 到 ALEX、PGM-Index、RadixSpline,系统梳理学习型索引的数学骨架、更新代价与落地边界,并给出一个最小 RMI 的 Python 实现
B-tree 深度解剖:从磁盘 I/O 模型到 boltdb 源码
从 Bayer-McCreight 1972 推导树高与分裂摊还代价,用计数模拟器和 bbolt v1.5.0 实测:随机插入页填充约 69%,按键序插入由分裂点决定是 50% 还是近 100%;再对照 bbolt、PostgreSQL、SQLite 源码看删除、写时复制与 B-link 并发。
LSM-tree Compaction 策略:leveling、tiering、lazy leveling 与 RocksDB 的实现
拆解 leveling、tiering、lazy leveling 的代价模型,对照 RocksDB 9.7.4 的 leveled、universal、FIFO 源码,用计数模拟器实测 22 种配置的写、读、空间放大,并验证 Monkey 给小层更多 filter 位。
MVCC 实现变体:版本存储、快照可见性与写偏斜
按 Wu 等人(VLDB 2017)的设计维度对照 PostgreSQL 17、InnoDB 8.4、Oracle、SQL Server、Hekaton 与 TiKV 的 MVCC;用模拟器验证三种可见性写法等价、测量 SSI 误杀,并在 PostgreSQL 上复现写偏斜。