常听到的说法是:Go 的 channel 用一把全局锁,所以慢;crossbeam-channel 是无锁的,所以快。这句话有两处经不起核对。
第一,crossbeam-channel 的有界实现来自 Dmitry Vyukov 2014
年为 Go 写的设计文档《Go channels on
steroids》,array.rs
的文件头直接引用了它。这份文档把”让 channel
完全无锁”列为非目标,理由是会让实现复杂得多、并让常见情形变慢;它自己的基准表里,高争用的有缓冲
channel 在 16 和 32 线程下比当时的加锁版本慢 132% 到
200%。第二,Go
没有采纳这个设计,并不只是因为没人去做。Vyukov 在 golang/go#8899
里说,Go 1.6 的一次 channel
改动之后,他的算法缺少现有代码提供的公平性保证,“does not
apply per se”。
所以真正的问题不是”有锁还是无锁”,而是三件更具体的事:
- 同一个有界环形缓冲,用一把锁、逐槽 stamp、head/tail 两阶段预留三种方式同步,一个线程停在操作中间时,其他线程还能做什么?
- channel 比队列多出的阻塞语义:线程睡下之前要做什么才不会丢失唤醒?被唤醒的线程是”操作已经被别人替它完成”,还是”醒来再去抢”?
- 这些选择在源码里怎样落地:Go 1.25 的
runtime/chan.go,crossbeam-channel 0.5.17,DPDK v25.11 的rte_ring,LMAX Disruptor 4.0。
reproduce/ 里有三种环的 C
模型(ring.h)、两种阻塞层(chan.c),以及
Go、Rust 的对照程序。主要结果(2 vCPU 的 KVM 虚拟机,AMD
EPYC 9754,Linux 6.8,GCC 13.3):
- 停住一个生产者(预留槽位之后、发布之前睡 20 ms):一把锁时其他线程一次调用都完成不了;逐槽 stamp 的环里,另一个生产者还能写满剩下的 15 个槽位,然后每次调用都立即返回”满”;两阶段预留的环里,另一个生产者一次都发不出去,卡在一次调用里自旋了二十万到三十几万圈。
- TSan 与内存序:按 DPDK v25.11 的内存序写的两阶段环,10 次运行 TSan 10 次报告数据竞争;把”等待前一个 tail”的 relaxed 读改成 acquire 后 0 次。
- 丢失唤醒:去掉”登记之后再检查一次”这一步,加宽竞争窗口后 2000 条消息里有 789 到 1088 次唤醒丢失(程序靠超时兜底才跑完);保留这一步时 0 次。
- 交接与重试:4 个生产者、1 个消费者、容量 4 时,直接交接没有一次白醒;通知重试有 9% 到 22% 的唤醒醒来后又抢不到,平均每次发送被抢先的条数是直接交接的四到六倍,最坏的一次发送等待期间被抢先了八千到一万七千条。
无界链表队列、Michael-Scott 队列、LCRQ 和 crossbeam 的
SegQueue 在第 72
篇已经讲过,本文只讨论有界环形缓冲和它上面的 channel
语义。
一、channel 比队列多出的三件事
一个有界多生产者多消费者(multi-producer multi-consumer,MPMC)队列只要回答”放得进吗、取得出吗”。channel 还要处理三件事:
- 阻塞:满时发送者睡下,空时接收者睡下,并且在条件满足时被准确地唤醒;
- 关闭:关闭之后,睡着的接收者要醒来拿到”已关闭”,睡着的发送者要醒来报错(Go 里是 panic);
- select:一个线程同时在几个 channel 上等待,只允许其中一个操作完成。
Go 的内存模型(2022 年 6 月 6 日版)把有缓冲 channel 的同步语义写成一条规则:“The \(k\)th receive from a channel with capacity \(C\) is synchronized before the completion of the \(k+C\)th send on that channel.” 第 \(k\) 次接收腾出的位置,正是第 \(k+C\) 次发送要用的位置;这条规则要求腾位置的一方与使用这个位置的一方之间有 happens-before 关系。第三节会看到,逐槽 stamp 的环正是把这条规则直接做成了每个槽位上的一对 release/acquire。
容量也有三种取法:
| 容量 | Go | crossbeam-channel 0.5.17 | DPDK rte_ring |
Disruptor |
|---|---|---|---|---|
| 0(同步交接) | make(chan T) |
bounded(0),zero flavor |
无 | 无 |
| 有界 | make(chan T, n) |
bounded(n),array flavor |
默认;可用容量为 size - 1,RING_F_EXACT_SZ
时为请求值 |
环大小须为 2 的幂 |
| 无界 | 无 | unbounded(),list flavor |
无 | 无 |
crossbeam-channel 在 src/channel.rs 里用
SenderFlavor、ReceiverFlavor
两个枚举分派到 flavors/ 下的
array、list、zero;定时器相关的
at、tick、never
是只出现在 ReceiverFlavor 里的另外三种。list
flavor 每块 31
个槽位(BLOCK_CAP = LAP - 1,LAP = 32),块的回收靠槽位上的
READ、DESTROY
标志决定由谁释放整块,没有用 crossbeam-epoch,这与第 72
篇讲的 SegQueue 是同一套办法。
二、谱系:从 CSP 的有界缓冲进程到 crossbeam-channel
Hoare 的《Communicating Sequential Processes》(CACM
21(8),1978)里还没有今天意义上的
channel。输入输出命令直接写对方进程的名字(producer?x、consumer!y),通信是同步的:双方都到达时才完成。第
7.3 节讨论过用端口(port)代替进程名,Hoare
认为两者语义等价,为了专注语义选了更直接的写法。第 7.4
节讨论过”自动缓冲”,他明确拒绝了:一是难以在多台分离的处理器上实现,二是需要缓冲时可以用已有原语写出来。第
5.1 节就是这样写的:一个有界缓冲是一个独立的进程
X,持有 buffer:(0..9) 和
in、out 两个计数,守卫
in < out + 10 和 out < in
分别决定能不能收生产者的数据、能不能响应消费者的请求。今天的有界
channel
把这个进程做进了运行时,in、out
就是 Go 的 sendx、recvx。
Go FAQ 的说法是:Go 的并发原语来自 CSP 家族树上与 Occam、Erlang 不同的一支,主要贡献是”channels as first class objects”。这一支的直接前身是 Pike 的 Newsqueak:channel 是有类型的值,可以存进变量、作为参数传递、再通过 channel 发送,《The Implementation of Newsqueak》(SP&E 20(7),1990)描述了它的实现。那句口号”Do not communicate by sharing memory; instead, share memory by communicating”出自 Effective Go,不是 Hoare 的原话;Effective Go 紧接着还有一句:“This approach can be taken too far.”
实现上,有界环形缓冲的无锁同步有几条独立的来源,后来在 channel 里汇合:
flowchart LR
  CSP["Hoare CSP<br/>CACM 1978"] --> GO["Go channel<br/>hchan + mutex"]
  LAM["Lamport<br/>TOPLAS 1983<br/>SPSC ring"] --> VY["Vyukov bounded MPMC<br/>per-slot sequence"]
  VY --> STER["Go channels on steroids<br/>design doc, 2014"]
  STER -. "not merged, go#8899" .-> GO
  STER --> CB["crossbeam-channel<br/>array flavor"]
  CB --> STD["Rust std mpsc<br/>since 1.67"]
  GO --> CL["Go 1.6 CL 16740<br/>handoff to waiters"]
  BSD["FreeBSD 8.0<br/>buf_ring"] --> DPDK["DPDK rte_ring<br/>MP/MC, RTS, HTS"]
  DIS["LMAX Disruptor<br/>2011"] --> DIS4["Disruptor 4.0<br/>FAA claim + availableBuffer"]
  AFEK["LCRQ<br/>PPoPP 2013"] --> KOT["Kotlin channels<br/>PPoPP 2023"]
几个节点需要说明:
- Lamport(TOPLAS 5(2),1983):《Specifying Concurrent Program Modules》用一个不加锁的单生产者单消费者有界缓冲作为例子讨论规约与证明,这个结构后来成了几乎所有 SPSC 环的起点。MPMC 的难处在于多个生产者会争同一个写位置。
- Vyukov 的有界 MPMC 队列:发表在他的网站
1024cores
上,给每个槽位配一个序号,用它同时编码”这一圈是否已写”和”这一圈是否已读”。crossbeam-channel
的
flavors/array.rs文件头写明”based on Dmitry Vyukov’s bounded MPMC queue”,并同时引用了 1024cores 的页面和《Go channels on steroids》。 - Go 的无锁 channel 提案:Vyukov 在 2014 年 10 月开了 go#8899,附带设计文档与实现 CL 12544043。截至本文核对时 issue 仍然是 open 状态。2016 年 12 月他写道,Go 近期的公平性改动之后,他的算法缺少现有代码的公平性保证;2017 年 4 月他指出所说的改动是 CL 16740,并说这个提案”was constantly deprioritized over other runtime changes”,一直没能跟上 runtime 的变化。
- CL 16740(“runtime: simplify chan ops, take 2”,2015 年 11 月合入,进入 Go 1.6):唤醒等待者的一方替对方完成整个协议,被唤醒的一方不必重新加锁;有等待中的接收者时,发送只拷贝一次。第六节专门讨论这个改动的代价与收益。
- Rust 标准库:rust-lang/rust#93563 把
crossbeam-channel 拷进标准库作为私有模块
sync::mpmc,std::sync::mpsc变成它的薄包装,里程碑是 Rust 1.67.0。PR 的动机是修一个五年没修掉的旧 bug(#39364),原来的实现”incredibly complex”。 - FreeBSD
buf_ring与 DPDK:DPDK 的 ring 文档说它的实现参考了 FreeBSD 8.0 加入的bufring.h,源码rte_ring_c11_pvt.h的版权行保留了 Kip Macy 的名字,并注明”Derived from FreeBSD’s bufring.h”。 - Kotlin:Koval、Alistarh、Elizarov 在 Euro-Par 2019 给出基于 FAA 的可扩展 FIFO channel,在 PPoPP 2023 的《Fast and Scalable Channels in Kotlin Coroutines》里把会合 channel 和有缓冲 channel 统一到”无限数组加两个 FAA 计数器”之上,处理缓冲和等待请求的取消。摘要报告相对原 Kotlin 实现和其他学术方案最多 9.8 倍的加速,并已替换 Kotlin Coroutines 标准库里原有的 channel 实现。它和 LCRQ(第 72 篇第八节)是同一个方向:把争用热点上的 CAS 换成不会失败的 FAA。
三、环形缓冲的三种同步方式
三种环都用单调增长的 64 位(ht 为 32
位)位置计数,槽位下标是位置对容量取模;容量取 2
的幂,取模就是按位与。reproduce/ring.h
用同一个接口实现了三种,编译时用 RING_KIND
选择。
3.1 一把锁:Go 的 hchan
Go 1.25 runtime/chan.go
的有缓冲发送,在确认没有等待中的接收者之后是这样的:
if c.qcount < c.dataqsiz {
    // Space is available in the channel buffer. Enqueue the element to send.
    qp := chanbuf(c, c.sendx)
    typedmemmove(c.elemtype, qp, ep)
    c.sendx++
    if c.sendx == c.dataqsiz {
        c.sendx = 0
    }
    c.qcount++
    unlock(&c.lock)
    return true
}
(省略了 race
检测的两行。)sendx、recvx、qcount
以及 sendq、recvq 两个等待队列全在
c.lock
保护之下,所以文件头能写出一组简单的不变式:有缓冲 channel
里 qcount > 0 蕴含 recvq
为空,qcount < dataqsiz 蕴含
sendq
为空。“缓冲里有数据却有接收者在睡”这种状态根本不会出现,这正是第六节直接交接的前提。锁外只有一条快路径:非阻塞操作(select
带 default)先不加锁地检查 full(c)
或 empty(c),确定失败就直接返回。
3.2 逐槽 stamp:Vyukov 有界 MPMC 与 crossbeam array
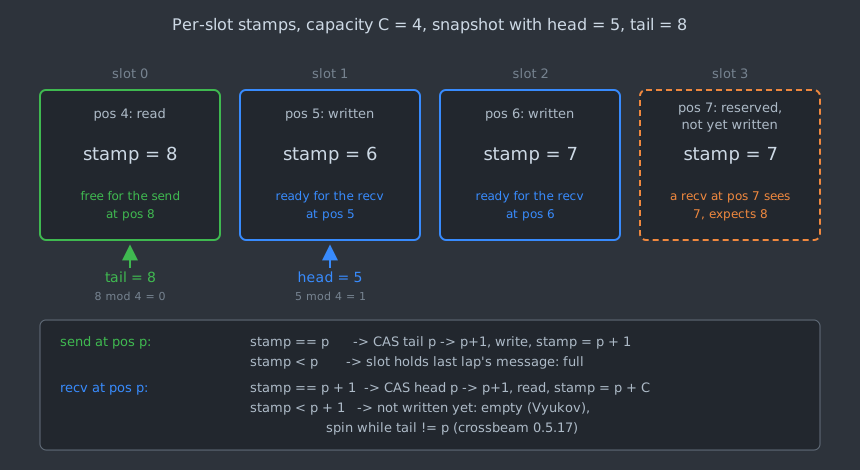
每个槽位带一个原子的 stamp。用位置 \(p\) 和容量 \(C\) 表示,约定是:
\[ \text{stamp} = p \iff \text{槽位空闲,可供位置 } p \text{ 的发送}, \qquad \text{stamp} = p + 1 \iff \text{已写入,可供位置 } p \text{ 的接收}. \]
接收者读完后把 stamp 设为 \(p +
C\),也就是下一圈同一槽位的”空闲”值。发送者只和
tail、接收者只和 head 做
CAS,两边不共享写的计数器:
uint64_t pos = atomic_load_explicit(&r->tail, memory_order_relaxed);
for (;;) {
    ring_slot_t *s = &r->slots[pos & r->mask];
    uint64_t seq = atomic_load_explicit(&s->seq, memory_order_acquire);
    int64_t d = (int64_t)(seq - pos);
    if (d == 0) {
        if (atomic_compare_exchange_weak_explicit(&r->tail, &pos, pos + 1,
                memory_order_relaxed, memory_order_relaxed)) {
            s->val = v;
            atomic_store_explicit(&s->seq, pos + 1, memory_order_release);
            return true;
        }
    } else if (d < 0) {
        return false;                      /* slot still holds last lap's message */
    } else {
        pos = atomic_load_explicit(&r->tail, memory_order_relaxed);
    }
}
同步完全落在槽位上。位置 \(k\) 的接收者用 release 写入
stamp \(= k + C\),位置
\(k + C\) 的发送者用
acquire 读到这个值才会写入,这恰好是 Go
内存模型那条规则:“第 \(k\)
次接收同步先于第 \(k + C\)
次发送完成”。tail 和 head 上的 CAS
只负责分配位置,可以是 relaxed。第四节的 TSan
实验验证了这一点:把 stamp 的 release 改成 relaxed,TSan
每次都报告数据竞争。
这个编码要求 \(C \ge
2\)。\(C = 1\)
时”位置 \(p\) 已写入”的
\(p + 1\) 与”位置 \(p + 1\) 空闲”的 \(p + C\)
是同一个值,一个后到的发送者会把尚未读走的消息当成空位覆盖掉;本文的模型在
\(C = 1\)
时实测就出现了消息损坏,所以 ring_init
拒绝这种容量。crossbeam-channel 不受这个限制:它的
tail 把位置拆成 {lap, mark, index}
三段,mark_bit 取
(cap + 1).next_power_of_two(),one_lap
是它的两倍,“下一圈”是加 one_lap 而不是加
cap,因此容量可以是任意正整数,最高的 mark
位还兼作断开标志。它的 CAS 用 SeqCst,stamp 的写入用
Release。
图中槽位 3 显示了这种环的弱点:位置 7
已经被一个发送者预留(tail 已推进到
8),但数据还没写。位置 7 的接收者看到 stamp 仍是 7,Vyukov
的原始算法此时报告”空”;crossbeam 0.5.17 的
start_recv 多做一步,发现 tail
已经越过这个位置时,就判定有人正在写,改为退避后重试。ring.h
的 SEQ_WAIT_RESERVED 开关(称为
seq-cb)模仿的就是这一步。第五节会看到两种选择在一个线程停住时的差别。
3.3 head/tail 两阶段预留:FreeBSD buf_ring 与 DPDK rte_ring
DPDK 的 rte_ring
不在槽位上放任何元数据。生产者和消费者各有一对计数
head、tail:head
是已经预留到哪里,tail
是已经发布到哪里。一次入队分三步:CAS 推进
prod.head 预留 \(n\) 个位置;写数据;等
prod.tail
追上自己预留的起点,再把它推到终点。出队对称地操作
cons。下面是 v25.11
lib/ring/rte_ring_c11_pvt.h 发布 tail
的一段:
if (!single)
    rte_wait_until_equal_32((uint32_t *)(uintptr_t)&ht->tail, old_val,
        rte_memory_order_relaxed);

/*
 * R0: Establishes a synchronizing edge with load-acquire of tail at A1.
 * Ensures that memory effects by this thread on ring elements array
 * is observed by a different thread of the other type.
 */
rte_atomic_store_explicit(&ht->tail, new_val, rte_memory_order_release);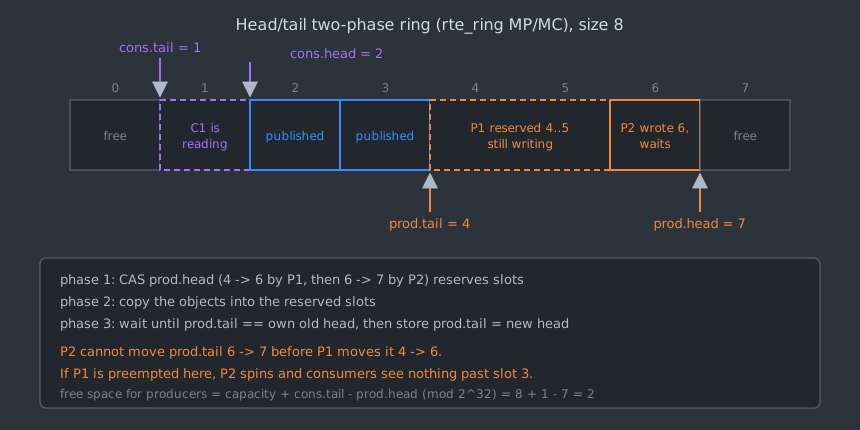
“等前面的人先发布”是这种环的代价。图中 P2 已经写完位置
6,但 prod.tail 只能按顺序推进,P2 必须原地等
P1 把 prod.tail 从 4 推到 6 之后,才能再推到
7。消费者只看 prod.tail,所以它看不到位置 6
的数据,哪怕数据早已写好。好处是另一面:消费者一次 CAS
就能拿走 \(n\)
个位置,槽位本身是普通内存,没有逐槽的原子写。
ring.h 的 RING_KIND 3 照 v25.11
的内存序实现:读自己一侧的 head 用
acquire,读对侧的 tail 用 acquire,CAS 成功用
release、失败用 acquire,等待前一个 tail 用
relaxed,发布 tail 用 release。这组内存序本身是
2025 年才定下来的。v24.11 里读 head 是
relaxed,之后接一个 acquire fence 再读对侧
tail,CAS 的成功与失败都是 relaxed。DPDK 提交
a4ad0eba9d(“ring: establish safe partial order in default
mode”,2025 年 11 月 11
日)把它们改成了上面的样子。这个提交的 Fixes:
指向 2018 年引入 C11 实现的提交 49594a63147a9,并抄送 stable
分支,也就是说,这种写法在默认模式下带着一个不安全的偏序存在了七年。它进了
v25.11,v25.07 里没有。第四节的 TSan
实验说明,改完之后等待前一个 tail 的那次
relaxed 读仍然让 C11 模型里的一条同步链断开。
3.4 Disruptor:FAA 领号,逐槽可用标志
LMAX Disruptor(Thompson、Farley、Barker、Gee、Stewart
的技术论文,2011 年 5
月)的多生产者序列器处在前两种之间。4.0.0 的
MultiProducerSequencer.next(n) 用
cursor.getAndAdd(n) 领号,一次 FAA
必然成功,不存在 CAS
失败重试;领到的位置如果要绕过最慢的消费者,就在一个
LockSupport.parkNanos(1L)
的循环里等(源码在这行旁边留了一条待办注释,问是否应该改为按等待策略自旋)。只有
tryNext 用
CAS,因为它必须在容量不足时抛出异常而不能先占位置。
发布时不推进共享的 tail,而是在与环等长的
availableBuffer 数组里,用 release
语义写入这个位置的圈数
sequence >>> indexShift。源码注释说明了原因:“to
avoid a shared sequence object between publisher
threads”。消费者用 getHighestPublishedSequence
从低到高逐个检查可用标志,遇到第一个没发布的位置就停下。这和逐槽
stamp 是同一个思路,只是把 stamp
从槽位里挪到了一个平行数组,并且只编码”已写入”这一半;“已读完”由各消费者自己的
Sequence
表示,生产者取所有消费者序号的最小值来判断能不能绕圈。Disruptor
的消费者默认各自看到全部事件,是多播而不是 MPMC
的”每条消息只给一个人”。
伪共享的处理也要按源码讲。4.0.0 的 Sequence
经
LhsPadding、Value、RhsPadding
三层继承,在 long value 前后各声明 56 个
byte 字段(p10 到
p77、p90 到
p157),每侧 56 字节;RingBuffer
的元素数组两端各多留 BUFFER_PAD = 32
个引用槽。crossbeam 的 CachePadded
则按目标架构选对齐:x86_64、aarch64、powerpc64 上是 128
字节(源码注释的理由:Intel 从 Sandy Bridge
起空间预取器成对拉取 64 字节缓存行,部分 aarch64 大核与
powerpc64 的缓存行本身就是 128
字节),arm、mips、sparc、hexagon 上是 32,m68k 上是
16,s390x 上是 256,其他平台 64。
四、验证:检查器、TSan 与变异
stress.c 让 \(P\) 个生产者各发 \(N\)
条带编号的消息(高位是生产者号,低位是序号),\(C\)
个消费者收完之后检查三件事:每条消息恰好收到一次(missing、dup),每个消费者看到的同一生产者的消息序号严格递增(order_err)。第二条是
FIFO
在多消费者下能检查的最强形式:两个消费者之间没有共同的时钟,无法比较谁先收到。检查器用普通字节数组记录收到次数,每条消息只有一个字节,不同消费者写不同字节,因此它自己不引入数据竞争。
检查器只能发现在这台 x86 机器上真的发生了的错误。x86 是
TSO 内存模型,relaxed 和 release 的 store 编译出同一条
mov,内存序写错了在这里通常表现不出来。所以另用
GCC 13 的 ThreadSanitizer 检查 C11 抽象模型下的
happens-before。每个变体 2 生产者、2 消费者、每人 20000
条、容量 8,跑 10 次(setarch -R
关闭地址随机化以兼容 TSan),单次超过 60 秒算挂起:
| 变体 | 改动 | TSan 报告 | 检查器失败 |
|---|---|---|---|
| seq | 原样 | 0/10 | 0/10 |
| seq,发布 relaxed | stamp 用 relaxed store | 10/10 | 0/10 |
| seq-cb | 满、空时按 crossbeam 的方式等待 | 0/10 | 0/10 |
| ht,DPDK v25.11 内存序 | 原样 | 10/10 | 0/10 |
| ht,等待用 acquire | 等前一个 tail 用 acquire |
0/10 | 0/10 |
| ht,不等待 | 直接写 tail,不等前面的人 |
9/10 | 9/10(其中 4 次挂起) |
AddressSanitizer 加 UndefinedBehaviorSanitizer 下,三种环的 2 生产者 2 消费者和 ht 的 3 生产者、批量 5 条的组合都没有报告,检查器也全部通过。
逐槽 stamp 的 release 是必需的。改成
relaxed 后,TSan 每次都报告:消费者读 val
与生产者写 val 之间没有
happens-before。检查器在 x86 上一次也没抓到,这正是需要 TSan
的原因。
DPDK 内存序下 TSan
的报告需要解释。报告的两端是:一个生产者写某个槽位,与更早的一个消费者读同一个槽位。链条是这样的:消费者
\(C_0\) 读完位置 \([a, h)\),用 release 把
cons.tail 写成 \(h\);消费者 \(C_1\) 读完 \([h, h + n)\),用 relaxed 读到
cons.tail 等于 \(h\),再用 release 写成 \(h + n\);生产者用 acquire 读到
\(h + n\),于是去写位置
\(a + C\) 所在的槽位,它和
\(C_0\)
读过的是同一个槽位。生产者只与 \(C_1\) 的 store 同步。\(C_1\) 读 \(C_0\) 的 store 用的是
relaxed,建立不了同步;\(C_1\) 的 store
不是读改写操作,也不延续 \(C_0\) 那次 release
的释放序列(release sequence)。按 C11 的定义,\(C_0\) 的读与生产者的写之间没有
happens-before,这是数据竞争。把等待改成
acquire,链条就接上了,TSan 报告归零。
这是不是真实硬件上的错误,是另一回事。x86 上检查器 10 次都没有失败。按 ARMv8 的公理化内存模型推理,store-release 会排在本线程之前所有的读写之后,而观察关系可以跨线程传递,这条链在硬件层面仍然有序;本文没有在 ARM 或 POWER 上实测。所以更准确的说法是:这组内存序在 C11 抽象模型里不够,要靠具体硬件模型比 C11 强来兜底。DPDK 2025 年那次修正(3.3 节)也是在 C11 模型层面补上偏序,而不是修一个观察到的崩溃。
不等待就是真错。去掉”等前一个
tail“之后,后预留的线程可能先发布、把
tail
推过前面还没写完的位置,前面那个线程随后又把
tail 写回一个更小的值。10 次里有 9
次检查器发现丢失、重复或乱序,其中 4
次程序挂住:tail 被写回较小的值之后,消费者按
tail
能看到的位置与生产者实际写过的位置再也对不上。
TSan 自身有一个限制要说清楚:GCC 13 在
-fsanitize=thread 下对
atomic_thread_fence 给出 -Wtsan
警告,TSan 不建模独立的 fence。本文的 C 模型只在两处用到
fence:seq-cb 判满、判空时 crossbeam 式的 SeqCst fence,以及
chan.c 通知者一侧”先改环、再读
is_empty“的 SeqCst fence。两处 fence
保护的都是”该不该睡、该不该叫醒”的判断,不是对数据的访问,所以
TSan 对数据竞争的结论不受影响;但丢失唤醒这类问题,TSan
在这里帮不上忙,要靠第六节的计数实验。chan.c
两种实现在 TSan 下各跑一次 3 生产者、2 消费者、每人 3000
条、容量 2,都没有报告,检查器也通过。
五、一个线程停在中间时,谁还能前进
“无锁”的本意是进度保证:任何一个线程在任意位置停下,其他线程仍然能完成操作。三种环都宣称或被宣称”无锁”或”高性能”,但真正能区分它们的是一个具体问题:一个生产者预留了位置、还没有发布就被换出,其他线程会怎样?
stall.c 直接制造这种情形。一个生产者 S
不停地发送,每第 2000 次发送在
RING_STALL_POINT()
处(预留之后、发布之前;锁环则是持锁期间)睡 20
ms。另一个生产者 P 只在 S 停住期间发送,消费者 C
一直在收。每个窗口分别统计 P、C
完成的操作数、立即返回”满”或”空”的次数,以及在一次调用内部自旋的圈数。容量
16,5 个窗口取中位数:
| 环 | P 完成 | P 返回满 | P 调用内自旋 | C 完成 | C 返回空 | C 调用内自旋 |
|---|---|---|---|---|---|---|
| lock | 0 | 0 | 0 | 0 | 0 | 0 |
| seq | 15 | 5637 | 0 | 15 | 5637 | 0 |
| seq-cb | 15 | 17074 | 0 | 15 | 0 | 478422 |
| ht | 0 | 0 | 284446 | 0 | 12283 | 0 |
逐行读:
- lock:S 持锁睡着,P 和 C 各自卡在
pthread_mutex_lock里,20 ms 内一次调用都没有返回。它们睡在 futex 上,不占 CPU,这一点比后两种自旋的情形好。 - seq:C 拿到的 15
条是停住的槽位之前已经积压的消息,停住的槽位之后它一条都拿不到,因为
head必须按位置顺序推进;此后每次调用立即返回”空”。P 写满了停住槽位之后剩下的 15 个空位,之后每次调用立即返回”满”。没有人被卡在调用里,但整个 channel 在这个槽位上断流了。 - seq-cb:P 的行为和 seq 一样。C
一旦走到停住的槽位,就在
start_recv那段退避循环里一直转,中位数 47 万圈,一次”空”都没有返回。5 个窗口里有一个 P 一条都没发出去、只返回了两次”满”,另一个窗口 C 一条都没收到:两个 vCPU 上 C 的自旋占满了一个核,P 能不能被调度到全看运气。 - ht:P 在 CAS 预留、写完数据之后卡在
ht_update_tail里等prod.tail追上来,中位数 28 万圈,这次调用 20 ms 都没有返回。C 看到的prod.tail停在 S 预留的位置之前,所以 P 早已写好的数据它也看不到,只能不停地返回”空”。
这组结果说明,三种环在严格意义上都不是无锁的:一个停住的线程总能让别人要么睡、要么转、要么对着一个逻辑上非空的队列反复得到”空”。最后一种情形也不能线性化:P
的 15 次发送已经返回,S 的发送还没返回,按 FIFO 必须排在 P
前面,那么 C 此时看到的队列不可能为空。crossbeam-channel
自己的文档从没说过它是无锁的,array.rs 只说基于
Vyukov 的有界 MPMC 队列。区别在代价落在哪里:seq
让其他线程立刻知道”现在不行”,可以去睡或做别的事;ht
让某个线程在调用里空转,直到停住的线程被重新调度。
DPDK 在 EAL
文档里把后者写成了使用约束:rte_ring
是”non-preemptive”的,做多生产者入队的线程不能被同一个环上另一个做多生产者入队的线程抢占,否则”may
cause the 2nd pthread to spin until the 1st one is scheduled
again”;如果第一个线程被更高优先级的上下文抢占,“it may even
cause a dead lock”。所以多生产者或多消费者线程”MUST not”使用
SCHED_FIFO 或 SCHED_RR;在 SCHED_OTHER 下”MAY be
used”,但要知道有性能代价。ring 文档对默认 MP/MC
模式的评价是”it can perform quite pure on some overcommitted
scenarios”。DPDK
的典型部署是每个核绑一个不被抢占的轮询线程,这个约束在那里几乎不花代价,放到一个通用的、线程数多于核数的
channel 里就不成立了。
DPDK 为此又加了两种同步模式。RTS(Relaxed Tail Sync)里
tail 只由最后一个完成的线程推进,其他线程不必在 tail
上自旋,文档说这避免了 tail 更新上的”Lock-Waiter-Preemption
(LWP)“问题,代价是每次入队或出队两次 64 位
CAS,原模式只要一次 32 位 CAS 加 tail
上的等待。HTS(Head/Tail Sync)干脆把 head 和 tail 放进一个
64 位值,只有 head == tail 时才允许推进
head,入队、出队都完全串行化;它同样避开
LWP,并且因为串行,能提供多线程安全的 peek
API。”锁等待者被抢占”这个名字来自虚拟化里的自旋锁研究:Ouyang
与 Lange(VEE 2013)指出,在超额分配的虚拟机里,ticket
自旋锁不仅怕持锁者被抢占,也怕排在队里的等待者被抢占,因为
FIFO 顺序会让后面所有人跟着等它。ht 环的 tail
更新正是一个隐式的 ticket 锁:预留位置就是取号,推进 tail
就是按号放行。
六、阻塞与唤醒:直接交接还是通知重试
6.1 丢失唤醒与”登记、复查、睡下”
阻塞层最经典的错误是丢失唤醒:接收者发现 channel 为空,决定去睡;在它把自己登记进等待队列之前,发送者放进一条消息,检查等待队列发现没人,于是不叫任何人;接收者随后登记、睡下,再也没人叫它。
sequenceDiagram
  participant R as Receiver
  participant Ring as Ring
  participant W as Waiter list
  participant S as Sender
  R->>Ring: try_recv returns empty
  S->>Ring: try_send succeeds
  S->>W: notify finds is_empty = true, wakes nobody
  R->>W: register self
  R->>R: park, nobody will wake it
Go
用锁把”检查”和”登记”放进同一个临界区来避免它:chanrecv
在 c.lock 之下发现缓冲为空,就把自己的
sudog 挂进 recvq,然后调用
gopark(chanparkcommit, unsafe.Pointer(&c.lock), ...)。锁是在
goroutine 已经进入等待状态之后,由
chanparkcommit
释放的;发送者要改缓冲就必须先拿到同一把锁,拿到时一定能看到那个
sudog。
crossbeam 的数据路径不加锁,只能用顺序来保证。它的
SyncWaker 是一把 Mutex
保护的等待列表,外加一个
is_empty: AtomicBool。阻塞的发送者先
register(持锁挂入列表,然后用 SeqCst 把
is_empty 写成 false),再复查一次:
self.senders.register(oper, cx);

// Has the channel become ready just now?
if !self.is_full() || self.is_disconnected() {
    let _ = cx.try_select(Selected::Aborted);
}

// Block the current thread.
let sel = cx.wait_until(deadline);
通知一方在写完 stamp 后调用 notify,先用
SeqCst 读 is_empty,为 true
就直接返回,不碰锁。这是 Dekker 式的对称:等待者”写
is_empty,再读环的状态”,通知者”写环的状态,再读
is_empty“。只要四次访问都在同一个 SeqCst
全序里,两方至少有一方能看到对方的写,要么等待者复查时发现能继续,要么通知者看到有人在等。crossbeam
里推进 tail、head 的 CAS 用
SeqCst,is_full 的读也是
SeqCst,满足了这个条件。chan.c 的 retry
实现照这个结构写,通知者一侧用一个 SeqCst fence 代替 SeqCst
的 CAS。
MUT_NORECHECK 变体去掉了复查。每次 park
最多等 200 ms,超时后若 channel
其实已经可以继续,就记一次丢失唤醒,然后重试,所以程序总能跑完。1
生产者 1 消费者、容量 2:
| 变体 | 消息数 | 竞争窗口 | 3 次运行的丢失唤醒 |
|---|---|---|---|
| retry | 200000 | 自然 | 0, 0, 0 |
| retry,去掉复查 | 200000 | 自然 | 0, 4, 0 |
| retry | 2000 | 登记前睡 50 µs | 0, 0, 0 |
| retry,去掉复查 | 2000 | 登记前睡 50 µs | 1088, 789, 1057 |
在自然窗口下,20 万条消息里这个错误可能一次都不出现,出现时每次代价是 200 ms 的超时(真实程序里没有超时就是永久挂起)。把窗口加宽到 50 µs 之后,一半左右的阻塞都丢了唤醒。这类错误靠压力测试很难抓到,TSan 也看不出来,因为它不是数据竞争。
6.2 被唤醒之后:操作已经完成,还是再去抢
唤醒之后发生什么,是 Go 与 crossbeam 真正的分歧。
Go 自 1.6(CL
16740)起是直接交接:唤醒者替被唤醒者把操作做完。发送时如果
recvq
里有等待的接收者,值直接拷到接收者的栈上,不经过缓冲;接收时如果缓冲是满的并且
sendq
里有等待的发送者,接收者取走队头,再把队首发送者的值拷进刚腾出的同一个槽位(源码里
c.sendx = c.recvx),然后 goready
它。被唤醒的 goroutine
醒来时操作已经完成,不需要再加锁,也不可能白醒。代价是所有这些都在
c.lock 之下,锁是唯一的串行点。
crossbeam 的 array flavor
是通知重试:write 之后调用
receivers.notify(),被选中的接收者醒来,得到
Selected::Operation,然后回到循环开头重新
start_recv。在它醒来之前,一个刚到的、没有睡过的接收者可以先把这条消息拿走。Vyukov
2014 年的设计文档把这一点写得很明白:同步 channel
做直接交接;有缓冲的 async channel “do not implement hand
off semantics – an unblocked consumer competes on general
rights with other consumers, if it loses the competition it
blocks
again”。这换来的是数据路径完全不碰等待列表的锁:没人在等时,notify
只是一次原子读。
chan.c 用同一个驱动程序比较两种语义。handoff
版是一把锁、一个环、两个 FIFO 等待队列,逻辑照 Go;retry
版是逐槽 stamp 环加上 6.1 节的 waker。每个生产者在调用
chan_send 前读一次全局的”已进入 channel
的消息数”,自己的消息进入时再算差值,得到这次发送期间被别人抢先了多少条。4
生产者、1 消费者、每人 50000 条、容量 4,3 次运行:
| 语义 | 每条消息睡下次数 | 白醒比例 | 平均被抢先 | 最多被抢先 |
|---|---|---|---|---|
| handoff | 0.59 到 0.66 | 0 | 0.39 到 0.53 | 15 到 122 |
| retry | 0.17 到 0.52 | 9.4% 到 22.4% | 2.17 到 2.49 | 8163 到 17273 |
白醒是指被唤醒后,重试时发现空位又被别人占了,只好再睡。handoff
的白醒按构造就是 0。它的”最多被抢先”也不是 0,因为计数从调用
chan_send
之前开始:线程在拿到锁之前被换出,别人照样往里放消息。一旦进了
sendq,排在它前面的最多只有另外 3
个生产者。retry
的最坏情形高两个数量级:一个倒霉的发送者可能连续几轮醒来都抢不到位置,期间别人发出了一万多条。
吞吐量上两者各有胜负(第八节)。这组实验要说明的是公平性:直接交接给出 FIFO 的等待顺序,通知重试不保证任何顺序,一个发送者可能被新来者无限期地插队。这正是 Vyukov 2016 年说他的算法在 Go 1.6 之后”does not apply per se”的原因:直接交接是 Go 已经提供的保证,换成通知重试就要放弃它。
七、关闭与 select:只让一个人赢
7.1 关闭
Go 的 closechan 在 c.lock
之下把 c.closed 置 1,把 recvq 和
sendq 里的所有 sudog
取出来,success 设为 false,收集进一个
gList,解锁之后再逐个
goready。被唤醒的接收者拿到零值和
ok == false,被唤醒的发送者
panic。之后到来的接收者先把缓冲里剩下的消息收完,缓冲空了才看到关闭。所有判断都在同一把锁下,关闭与发送、接收之间不存在中间状态。
crossbeam 的 array flavor
没有全局锁,于是把”已断开”编进了 tail
本身:disconnect 用一次 SeqCst 的
fetch_or(mark_bit)
置位,再分别叫醒发送侧和接收侧的所有等待者。start_send
每一轮先看 tail 的 mark
位,置位就返回一个空令牌,随后 write
把消息原样退回给调用者(SendError(msg),而不是
panic)。start_recv 只在判定为空时才看 mark
位,所以接收者同样先收完缓冲。标志和位置在同一个原子字里,任何一次读
tail
都能同时知道”写到哪了”和”还能不能写”,不会出现”看到位置、没看到关闭”的撕裂。
7.2 select
select 的难处在于:一个线程同时挂在几个 channel 的等待队列上,可能有几个通知者同时想叫醒它,只能有一个成功。
Go 的 selectgo
先生成两个排列。pollorder 用
cheaprandn 打乱,决定检查各个 case
的顺序,这样同时就绪的几个 case
被选中的机会均等;lockorder 按 channel
地址(sortkey() 就是 hchan
的指针值)堆排序,所有 channel 按这个顺序加锁,两个 select
以相反顺序涉及同样两个 channel
时也不会死锁。之后分三遍:第一遍按 pollorder
找已经就绪的 case,找到就直接完成;第二遍在每个 channel
上挂一个 isSelect = true 的
sudog,然后睡下;第三遍醒来后,把自己从所有没赢的
channel 上摘下来。“只赢一次”靠 dequeue 里的一次
CAS:通知者从等待队列里取出一个 isSelect 的
sudog 时,要把那个 goroutine 的
selectDone 从 0 改成 1,失败说明别的 channel
已经抢先叫醒了它,就跳过这个 sudog
继续找下一个。
crossbeam 的做法是同一个思路,但不需要同时锁住所有
channel。每个参与 select 的线程有一个
Context,里面的 select 字段初始为
Waiting;它在每个 channel 的 waker 上登记同一个
Context。通知者调用
try_select,用一次 AcqRel 的
compare_exchange 把 Waiting
改成自己的操作号,成功者负责
unpark,失败者跳过。上面 6.1
节发送者复查时调用的
cx.try_select(Selected::Aborted),也是在同一个字段上抢:它要么抢到并放弃睡眠,要么说明通知者已经先一步选中了它。waker
选人时还会跳过属于当前线程的等待者,否则一个同时在同一
channel 上 select 发送和接收的线程会和自己配对。候选 case
的顺序由 utils::shuffle 打乱,作用与 Go 的
pollorder 相同。
八、吞吐量:只看相对趋势
测试环境:KVM 虚拟机,2 个 vCPU(AMD EPYC
9754;lscpu 报告 1 个核、每核 2
个线程,客户机拓扑上两个 vCPU 是同一个核的两个 SMT
线程,宿主上的实际映射未知),Linux 6.8,GCC 13.3
-O2,Go
1.25.5(GOMAXPROCS=2),rustc 1.94.0 release
构建,crossbeam-channel
0.5.17。这台机器与其他任务共享宿主,同一个点 5
次运行的最小值与最大值常常差 2 到 5
倍,所以下表只给中位数,也只用来比较数量级和排序,不能当成这些实现的绝对性能。消息是
8 字节整数;1P1C 每人 200 万条,2P2C 每个生产者 100
万条。单位是百万条每秒:
| 实现 | 1P1C 容量 16 | 1P1C 容量 1024 | 2P2C 容量 16 | 2P2C 容量 1024 |
|---|---|---|---|---|
| C lock 环(轮询) | 1.16 | 11.6 | 1.82 | 22.7 |
| C seq 环(轮询) | 12.1 | 24.2 | 10.9 | 45.6 |
| C ht 环(轮询) | 5.00 | 15.8 | 2.50 | 5.48 |
| C handoff channel | 0.54 | 7.53 | 1.22 | 13.7 |
| C retry channel | 0.50 | 21.8 | 1.14 | 35.3 |
| Go channel | 8.37 | 10.2 | 9.87 | 16.4 |
crossbeam bounded |
1.29 | 12.2 | 3.07 | 16.1 |
std sync_channel |
0.41 | 7.57 | 无 | 无 |
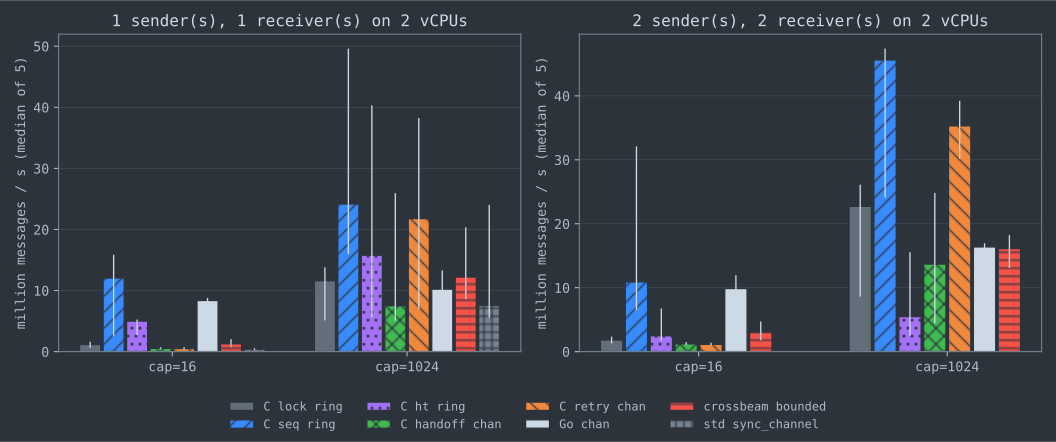
“轮询”的三行不是 channel:失败时先 pause 64
次再
sched_yield,从不睡眠,只用来比较三种环本身。std
的 sync_channel 只有一个接收端,没有 2P2C
的数据。能从表里读出的几点:
- 容量小时,阻塞的代价压倒一切。容量 16 时,所有基于 OS 线程的 channel(C 的两种、crossbeam、std)都在每秒 0.4 到 3 百万条之间,Go 却有 8 到 10 百万条。Go 的阻塞与唤醒是 goroutine 在用户态调度器里的切换,不需要 futex 系统调用和内核上下文切换;这是一个与源码一致的解释,本文没有用 profiler 单独验证。
- 容量大时,快路径的差别显现出来。容量 1024 时 retry 比 handoff 快约 2.6 到 2.9 倍:没人在等时,retry 的通知只是一次原子读,handoff 每次操作都要进出互斥锁。crossbeam 与 Go 在这一列相差不大。
- 超额订阅时 ht 环最吃亏。2P2C 是 4 个线程挤在 2 个 vCPU 上,ht 环在容量 1024 时只有 5.5,是 seq 环的八分之一,比加锁的环还慢;1P1C 时没有这个问题。这与第五节的现象一致:一个在 tail 上等前面的人的线程,前面的人被换出时只能空转。
- 批量摊薄了 ht 环的共享原子操作。2P2C、容量 1024,每次调用处理 \(B\) 条消息,每条消息在共享下标上的读改写次数是 \(2/B\):
| 批量 \(B\) | 每条消息的共享 RMW | 吞吐量(百万条/秒) |
|---|---|---|
| 1 | 2.01 | 16.1 |
| 8 | 0.250 | 75.7 |
| 32 | 0.0625 | 85.6 |
这组批量数据各只跑了一次,没有在锁下与其他测试隔离,同样只看趋势。批量接口是 head/tail 结构的天然优势:一次 CAS 预留 \(n\) 个位置,一次 store 发布 \(n\) 个位置。逐槽 stamp 的环做不到这一点,每条消息都要各写一次 stamp。
九、争论与开放问题
Go 该不该换成无锁 channel。 go#8899 从
2014 年开到现在,没有关闭也没有合入。支持的一方有 Vyukov
设计文档里的数据:非阻塞的
select(SelectNonblock)和
chan struct{}
信号量(ChanSem)在低线程数下每次操作的耗时减少六到七成。反对的理由也写在同一份文档里:高争用的有缓冲
channel(ChanContended)在 16、32
线程下耗时反而增加 132% 和 200%(“Extremely contended async
chans are slower because of increased contention in
lock-free paths”),而且 Go 1.6
的直接交接之后,他的算法缺少现有代码的公平性保证。第六节的实验把这个取舍量化到了一个小例子上:通知重试在大缓冲时快近
3
倍,代价是最坏情形下一个发送者被插队一万多次。哪个更重要,取决于程序是否依赖”先等的人先得”,这在
Go
的规范和内存模型里都没有写成保证,却是很多程序默默依赖的行为。
channel 是否真的让并发程序更安全。 Effective Go 的口号是”share memory by communicating”。Tu、Liu、Song、Zhang 在 ASPLOS 2019 研究了 Docker、Kubernetes、etcd、gRPC、CockroachDB、BoltDB 六个项目的 171 个并发 bug,发现这些项目里共享内存原语用得比消息传递更多,而消息传递导致的阻塞 bug 占阻塞 bug 的约 58%;另一方面,消息传递导致的非阻塞 bug 明显少于共享内存。换句话说,channel 把一部分数据竞争换成了死锁和泄漏的 goroutine。本文第六节的丢失唤醒是实现层面的同一类问题:阻塞语义本身是 bug 的来源。
FAA 还是 CAS。
三种环争用的热点都是一个下标上的 CAS,失败要重试。Disruptor
的多生产者领号、LCRQ、Nikolaev 的 SCQ(DISC 2019)和 Kotlin
的 channel(PPoPP 2023)都把热点换成了不会失败的 FAA。SCQ
的摘要强调,以往基于 FAA
的尝试难以同时做到无锁和可线性化,而 SCQ
两者兼得,且是有界的、只依赖在几乎所有架构上可用的原子操作。代价是领号之后不能”退号”:FAA
领到的位置如果当下不可用,必须用额外的协议把它标记作废,这让”满了就返回”的
try_send 变得复杂。Disruptor 的
next() 就干脆等到有空位,只在
tryNext() 里退回到 CAS。
开放问题。
- 内存序的正确性怎样在发布前被发现。 DPDK
的 C11 实现带着一个默认模式下的偏序缺陷存在了七年(3.3
节),修正之后第四节的 TSan 仍然能在等待 tail
的那一步报告竞争。像这样的环,现有的做法是人工推理、TSan
这类动态检查,或者针对 C11
模型的有界模型检查;哪一种能在工程上常规地覆盖
rte_ring、crossbeam 这样的代码,还没有定论。 - 抗抢占与低开销能否兼得。 第五节的三种环各自把代价放在不同的地方:锁让人睡,seq 让通道断流,ht 让人空转。DPDK 的 RTS、HTS 用更多或更宽的 CAS 换来对超额订阅的容忍。SCQ 这类真正无锁、可线性化的有界队列在这里能做到多好,放进一个还要处理阻塞、关闭和 select 的 channel 之后还剩多少优势,本文没有测,公开的对比也很少。
- 公平性怎样度量。 本文用”发送期间被抢先的条数”,它把调度延迟也算了进去(第六节 handoff 的最大值 122 就是这样来的)。Go 没有把 FIFO 写成语言保证,crossbeam 也没有承诺任何公平性。一个能区分”实现不公平”和”调度器不公平”的度量,以及 channel 应该承诺到什么程度,都还没有共识。
十、复现
reproduce/ 下的文件:
| 文件 | 内容 |
|---|---|
ring.h |
三种环(RING_KIND
1、2、3)与第四节的变异开关 |
stress.c |
正确性检查器与吞吐量驱动,输出
missing、dup、order_err
与每条消息的 RMW 次数 |
stall.c |
第五节的停顿实验 |
chan.c |
两种阻塞层(CHAN 1、2)与丢失唤醒变异 |
gobench/、rsbench/ |
Go channel 与 crossbeam-channel、std
sync_channel
的对照程序,Cargo.lock 锁定依赖版本 |
run.sh |
依次运行 E0 到 E5 并写入 results/ |
summarize.py |
汇总 timing_raw.txt,生成
results/timing.txt 与本文的
throughput.svg |
results/ |
本文引用的全部原始输出 |
需要 GCC(支持 -fsanitize=thread)、Go 1.25
以上、Rust 工具链和带 matplotlib 的 Python 3。在
reproduce/ 目录下:
TSAN_WRAP="setarch -R" bash run.shBUILD_DIR 放编译产物和 Cargo 的 target
目录,默认新建一个临时目录;CPUS
指定计时运行绑定的 CPU 列表,默认
0,1;LOCK 可以设成
flock
之类的前缀,让计时部分与机器上的其他负载错开。较新的内核默认的地址随机化位数与
GCC 13 的 TSan 运行时不兼容,所以 TSan 二进制要用
setarch -R
启动。单独验证某个现象时可以直接编译,例如第四节的 DPDK
内存序变体:
gcc -O1 -g -std=c11 -pthread -Wno-tsan -fsanitize=thread -DRING_KIND=3 stress.c -o ht_tsan
setarch -R ./ht_tsan -p 2 -c 2 -n 20000 -q 8
第五、六节的结论依赖调度:在核数更多的机器上,停住的生产者被其他核上的线程感知的方式不变,但吞吐量数字和白醒比例会不同。
十一、参考资料
规范与文档
- The Go Memory Model,2022-06-06 版。
- Frequently Asked Questions (FAQ),“Why build concurrency on the ideas of CSP?” 一节;Effective Go,“Share by communicating” 一节。
- DPDK Programmer’s Guide v25.11:Ring Library(MP/MC、RTS、HTS 模式)与 Environment Abstraction Layer(rte_ring 的 non-preemptive 约束)。
源码与提交
- Go
1.25.5:
src/runtime/chan.go、src/runtime/select.go。 - Go CL 16740,“runtime: simplify chan ops, take 2”,2015-11-08 合入(Go 1.6)。
- crossbeam-channel
0.5.17:
src/channel.rs、src/flavors/array.rs、src/flavors/list.rs、src/waker.rs、src/context.rs、src/select.rs;crossbeam-utils 0.8.21:src/cache_padded.rs、src/backoff.rs。 - DPDK v24.11 与
v25.11:
lib/ring/rte_ring_c11_pvt.h、lib/ring/rte_ring_core.h;提交 a4ad0eba9d,“ring: establish safe partial order in default mode”,2025-11-11,Fixes 49594a63147a9。 - LMAX Disruptor
4.0.0:
MultiProducerSequencer.java、Sequence.java、RingBuffer.java。
Issue、PR 与设计文档
- Dmitry Vyukov. Go channels on steroids,2014-01-28。
- golang/go#8899,“runtime: lock-free channels”,2014-10-07 创建,截至本文核对时仍为 open。
- rust-lang/rust#93563,“Merge crossbeam-channel into std::sync::mpsc”,2022-11-13 合入,里程碑 1.67.0。
谱系论文
- C. A. R. Hoare. Communicating Sequential Processes. Communications of the ACM 21(8), 1978, pp. 666–677.
- Leslie Lamport. Specifying Concurrent Program Modules. ACM TOPLAS 5(2), 1983, pp. 190–222.
- Rob Pike. The Implementation of Newsqueak. Software: Practice and Experience 20(7), 1990, pp. 649–659.
- Martin Thompson, Dave Farley, Michael Barker, Patricia Gee, Andrew Stewart. Disruptor: High Performance Alternative to Bounded Queues for Exchanging Data Between Concurrent Threads. LMAX 技术论文,2011 年 5 月。
后续与相关研究
- Adam Morrison, Yehuda Afek. Fast Concurrent Queues for x86 Processors. PPoPP 2013, pp. 103–112.
- Ruslan Nikolaev. A Scalable, Portable, and Memory-Efficient Lock-Free FIFO Queue. DISC 2019, LIPIcs 146, pp. 28:1–28:16. doi:10.4230/LIPIcs.DISC.2019.28.
- Nikita Koval, Dan Alistarh, Roman Elizarov. Scalable FIFO Channels for Programming via Communicating Sequential Processes. Euro-Par 2019, LNCS, pp. 317–333. doi:10.1007/978-3-030-29400-7_23.
- Nikita Koval, Dan Alistarh, Roman Elizarov. Fast and Scalable Channels in Kotlin Coroutines. PPoPP 2023, pp. 107–118. arXiv:2211.04986.
- Jiannan Ouyang, John R. Lange. Preemptable Ticket Spinlocks: Improving Consolidated Performance in the Cloud. VEE 2013, pp. 191–200.
- Tengfei Tu, Xiaoyu Liu, Linhai Song, Yiying Zhang. Understanding Real-World Concurrency Bugs in Go. ASPLOS 2019, pp. 865–878.
相关阅读:
- 无锁队列:Michael-Scott 算法与 ABA 问题
- Epoch-Based Reclamation:两个纪元的由来、Crossbeam 的实现与停顿的代价
- RCU:宽限期的保证、读侧的三种实现与代价的去向
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
并发哈希表:分段锁、桶锁、协作扩容与分裂有序表
对照 JDK 7/25 的 ConcurrentHashMap、NonBlockingHashMap、Linux rhashtable 与 Go sync.Map 的源码,说明并发哈希表真正难的是扩容;实测桶长分布、扩容克隆比例与树化条件,并给出通过 TSan 的分裂有序表实现。
RCU:宽限期的保证、读侧的三种实现与代价的去向
从宽限期保证的形式陈述出发,对照 liburcu 0.15.7 与 Linux v6.12 源码,说明读侧省掉的 StoreLoad 栅栏由谁补上、'读侧零开销'在哪些配置下成立;实测读侧开销、宽限期延迟、membarrier IPI 转嫁给读者的代价和一个缺栅栏的变异体。
Hazard Pointers:发布-验证协议、有界垃圾与栅栏的代价
按 Michael(TPDS 2004)的条件拆解 hazard pointers:发布后为何要复读、StoreLoad 栅栏防哪种重排、未回收节点的上界从哪来;实测两个变异体、x86 store buffering 和每个指针的开销,对照 Folly、C++26 与乐观遍历之争。
Epoch-Based Reclamation:两个纪元的由来、Crossbeam 的实现与停顿的代价
从 Fraser(2004)的三个 limbo list 出发,推导 EBR 为什么要等两个纪元、垃圾该打哪个纪元的标签;对照 crossbeam-epoch 0.9.18 源码,实测两个变异体、pin 的指令选择、每节点开销、回收速率上限,以及一个被抢占或睡住的读者让垃圾涨到多少。