风险模型要回答的是一个具体问题:给定今天的持仓,下一个调仓周期里组合可能波动多大、风险集中在哪些因子上、极端情况下最多亏多少。常见的错误有三种:拿组合历史净值算波动率(刚换过仓的组合,历史净值反映的是旧持仓);把
np.cov
得到的样本协方差直接喂给优化器(股票数接近样本天数时,优化器会专门挑”看起来最安全”的噪声方向下注);以及只看
VaR、不做压力测试。本文的结论是:用 Barra 式多因子结构把
\(N \times N\) 协方差压到
\(K \times K\)
因子协方差加对角特异方差;用收缩估计或 eigenfactor
调整修正优化组合的风险低估;用欧拉分解做事前归因;尾部风险靠
ES、VaR
回测和压力测试补足。第二节的模拟里,样本协方差对最小方差组合的风险预测只有真实值的
0.20 倍,与随机矩阵理论给出的 \(1-N/T\) 吻合。
速查表:风险问题 → 工具 → 关键假设
| 风险问题 | 对应工具 | 关键假设(不成立时会出什么问题) | 见 |
|---|---|---|---|
| 当前持仓下个月波动多大 | 因子模型协方差 \(X\Sigma_f X^\top+\Delta\),EWMA 加 Newey-West | 特异收益互不相关;因子结构在半衰期内大致稳定 | 第二、三节 |
| 优化器给出的风险是否被低估 | Ledoit-Wolf 收缩、eigenfactor 风险调整 | 样本误差是主要偏差来源;收益近似平稳 | 第二节、第九节 |
| 风险集中在哪个因子或行业 | 事前风险归因(MCR / CCR,欧拉分解) | 风险度量对权重一次齐次 | 第五节 |
| 收益从哪里来 | 事后多因子收益归因、Brinson | 暴露取 \(t-1\) 值;归因必须闭合 | 第五节 |
| 单日或 10 日尾部损失多大 | 历史模拟 / 参数法 / Hull-White VaR 与 ES | 历史窗口能代表未来;参数法还假设正态 | 第六节 |
| VaR 模型是否失准 | Kupiec 检验、Christoffersen 检验、巴塞尔红绿灯 | 例外事件独立同分布 | 第六节 |
| 历史上没出现过的极端情景 | 历史 / 假设 / 反向压力测试 | 冲击可以通过因子暴露线性传导;尾部相关性需要单独上调 | 第七节 |
| 方法从哪里来、哪里还有争论 | 谱系表、三个争论、开放问题 | — | 第九节 |
本文所有代码都在同目录的 risk_model_demo.py
和 plot_risk_figures.py
里,数据全部是固定随机种子生成的模拟数据。运行环境:Windows
11、Intel Core i9-12900K(16 核 24 线程)、64 GB
内存、Python 3.12.10、NumPy 2.5.3(OpenBLAS)、pandas
3.0.6、SciPy 1.18.1、scikit-learn 1.9.1、matplotlib
3.11.2。正文中的输出均摘自这两个脚本的实际运行结果。
风险提示与适用范围:本文不构成任何投资建议。所有代码、数据和示例数值都只用于说明算法,没有经过生产审计,直接套用造成的损失由使用者自负。文中的风险模型骨架参照 MSCI 公开的 USE4 / CNE5 方法论文档实现,与商业产品的实际公式和参数存在差异。VaR、ES 与压力测试的监管报送(巴塞尔市场风险框架 MAR 章节、SEC Rule 18f-4、各国银行资本监管规则等)有专门的口径要求,本文不替代任何监管文档。
一、风险模型的目的
估计组合波动只是风险模型的副产品。如果只需要一个波动率数字,GARCH、EWMA、已实现波动率都能给出来,用不着国家、行业、风格三层结构。风险模型存在的理由有三条。
事前预测(ex ante forecasting)
在开盘前回答:按当前持仓 \(w_t\) 拿到下一个调仓日,组合可能损失多大、损失主要来自哪些因子、有没有触碰硬约束。这件事只能建立在对未来协方差 \(\Sigma_{t+1}\) 的估计上:
\[ \sigma_p^2 = w_t^\top \Sigma_{t+1} w_t \]
难点在维度。\(N\) 只股票的协方差矩阵有 \(N(N+1)/2\) 个自由参数。因子分解把它压到 \(K(K+1)/2 + N\):以 MSCI 的 A 股模型 CNE5 为例,它有 1 个国家因子、32 个行业因子、10 个风格因子(Orr, Mashtaler & Nagy 2012),即 \(K=43\)。
事后归因(ex post attribution)
把已实现收益拆成因子贡献和特异贡献:
\[ r_p = \sum_{k=1}^{K} b_{p,k} f_k + \sum_i w_i u_i, \qquad b_{p,k} = \sum_i w_i X_{ik} \]
\(b_{p,k}\) 是组合在第 \(k\) 个因子上的暴露,\(f_k\) 是当期因子收益,最后一项是因子解释不了的选股收益。如果一个月的收益大部分来自市值因子,这个组合本质上是在押注小盘风格,而不是在选股。
组合优化输入(optimizer input)
均值方差、风险平价、Black-Litterman 的核心都是把协方差矩阵放进二次规划(见 组合构建)。协方差矩阵不可信时,优化器会放大估计误差。风险模型还给优化器提供一组结构化约束:因子暴露上下界、行业偏离上下界、跟踪误差目标、特异风险占比下界。这些约束都需要逐股票的暴露 \(X\) 和特异方差 \(\delta_i^2\) 才能写出来。下游的 头寸管理 用 \(\sigma_p\) 做波动率目标和风险预算,同样依赖这一步的输出。
因此,风险模型是同时给优化器、风控系统、归因报告供数的统一基础设施。估计频率、刷新延迟、覆盖范围、版本切换这些工程决策(见第八节)都要按这个定位来取舍。
下图是全文的骨架:Barra 式模型的因子分类和每日估计流程。

二、协方差矩阵估计
样本协方差为什么不稳定
设 \(N\) 只股票、\(T\) 天的收益矩阵 \(R \in \mathbb{R}^{T \times N}\),样本协方差为:
\[ \hat\Sigma = \frac{1}{T-1}(R - \bar R)^\top (R - \bar R) \]
第一,秩不够。\(\hat\Sigma\) 的秩不超过 \(\min(N, T-1)\)。\(N=4000\)、\(T=252\) 时,至少 3749 个特征值严格为零,矩阵不可逆。
第二,特征值谱失真。即使 \(T > N\),只要 \(q = N/T\) 不可忽略,样本特征值也会系统性地向两端散开。Marčenko & Pastur(1967)给出了纯噪声情形下的极限谱:当真实协方差为 \(\sigma^2 I\) 时,样本特征值落在区间
\[ \lambda_\pm = \sigma^2 (1 \pm \sqrt{q})^2 \]
之内。Laloux, Cizeau, Bouchaud & Potters(1999,Physical Review Letters)把这个结论用到 S&P 500 成分股的相关矩阵上,发现经验特征值密度的主体与随机矩阵预测高度吻合,因此对风险管理中直接使用经验相关矩阵提出了”严重怀疑”。
第三,优化会专门放大误差。优化器偏爱样本方差小的方向,而这些方向的小特征值恰恰是被低估得最厉害的。Michaud(1989,Financial Analysts Journal)把均值方差优化称为”误差最大化”(error maximization)。Bouchaud & Potters(2009,arXiv:0910.1205,综述,未经同行评审)给出了定量结论:在收益独立同分布、\(N, T \to \infty\) 且 \(q\) 固定的假设下,用样本协方差求出的最小方差组合满足
\[ R_{\text{in}} = R_{\text{true}} \sqrt{1-q} = R_{\text{out}} (1-q) \]
其中 \(R_{\text{in}}\) 是样本内预测风险,\(R_{\text{true}}\) 是真实协方差已知时可达到的最小风险,\(R_{\text{out}}\) 是这个组合的真实风险。也就是说,预测风险与实际风险之比约为 \(1-q\)。\(N=200\)、\(T=250\) 时这个比值只有 0.2。
第四,时变性。真实的协方差结构本身在变,危机中相关性上升(见第七节)。等权平均过去 252 天的估计,在最需要它的时候最不准。
收缩估计:把样本协方差拉向结构化目标
Ledoit & Wolf 的线性收缩把样本协方差和一个结构化目标 \(F\) 加权平均:
\[ \hat\Sigma_{\text{shrink}} = \delta F + (1 - \delta) \hat\Sigma, \quad \delta \in [0, 1] \]
收缩强度 \(\delta\) 按最小化 \(\mathbb{E}\|\hat\Sigma_{\text{shrink}} - \Sigma\|_F^2\) 的渐近最优公式估计。三篇论文用了三种目标:
- 单指数模型(Ledoit & Wolf 2003,Journal of Empirical Finance):\(F = \sigma_m^2 \beta \beta^\top + D\)。
- 常数相关阵(Ledoit & Wolf 2004,Journal of Portfolio Management):\(F_{ii} = \hat\sigma_i^2\),\(F_{ij} = \bar\rho\, \hat\sigma_i \hat\sigma_j\)。
- 单位阵的倍数(Ledoit & Wolf 2004,Journal of Multivariate Analysis):\(F = \mu I\),\(\mu = \operatorname{tr}(\hat\Sigma)/N\)。
sklearn.covariance.LedoitWolf 实现的是第 3
种。代码里常见”sklearn 的 LedoitWolf
用常数相关目标”的说法是错的。
import numpy as np
import pandas as pd
from sklearn.covariance import LedoitWolf


def sample_cov(returns: pd.DataFrame) -> np.ndarray:
    """样本协方差,作为基准"""
    return returns.cov().values


def ledoit_wolf_cov(returns: pd.DataFrame) -> tuple[np.ndarray, float]:
    """sklearn 的 Ledoit-Wolf 线性收缩,目标为 mu * I(Ledoit & Wolf 2004, JMVA)"""
    lw = LedoitWolf().fit(returns.values)
    return lw.covariance_, lw.shrinkage_
在一组 \(T=250\)、\(N=200\)
的三因子模拟收益上运行(risk_model_demo.py 第
[1] 段):
shrinkage intensity = 0.0781
cond(sample) = 3.72e+03, cond(LW) = 339
收缩强度不到 8%,条件数就降了一个数量级。线性收缩的代价是对所有特征值一视同仁地往均值拉,并且它优化的是 Frobenius 损失,而不是优化组合的风险偏差。Ledoit & Wolf 后来提出的非线性收缩(2017,Review of Financial Studies;2020,Annals of Statistics)对每个特征值单独收缩,目标直接对准组合选择。
因子模型:把维度从 N 降到 K
把每只股票的收益拆成因子部分和特异部分:
\[ r_i = \sum_{k=1}^{K} X_{ik} f_k + u_i \]
如果特异收益 \(u_i\) 互不相关且与因子无关,协方差矩阵为:
\[ \Sigma = X \Sigma_f X^\top + \Delta, \qquad \Delta = \operatorname{diag}(\delta_1^2, \dots, \delta_N^2) \]
需要估计的只有 \(K \times K\) 的 \(\Sigma_f\) 和 \(N\) 个特异方差。\(N=4000\)、\(K=43\) 时,参数从约 800 万降到 4946 个。更重要的是,样本误差决定的偏差比例从 \(N/T\) 变成了 \(K/T\):优化器能”钻空子”的方向只剩 \(K\) 个因子方向,加上对角的特异部分。
这个压缩依赖”特异收益互不相关”的假设。同一概念板块、同一产业链的股票,特异收益常常同向变动,行业因子只能吸收其中一部分。MSCI 的做法是把行业切细:USE4 有 60 个行业因子(Menchero, Orr & Wang 2011,Figure 3.2 图注),CNE5 有 32 个。剩余的跨股票相关会在第四节的残差检查中暴露出来。
模拟:样本、收缩、统计因子、基本面因子、eigenfactor 调整
下图用一个已知真实协方差的模拟市场比较五种估计量:真实模型为 5 因子加异质特异波动,\(N=200\)、\(T=250\)(\(q=0.8\)),高斯收益,重复 100 次;每次用估计出的协方差求全额投资的最小方差组合,比较预测波动与真实波动之比。
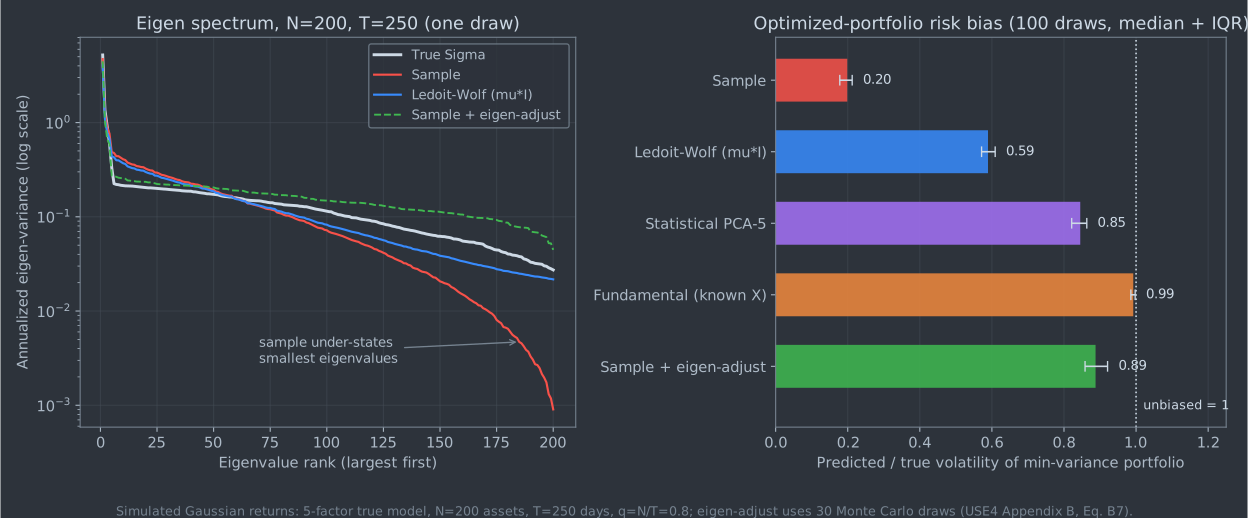
| 估计量 | 预测/真实波动(中位数) | 四分位区间 |
|---|---|---|
| 样本协方差 | 0.199 | [0.178, 0.212] |
| Ledoit-Wolf(\(\mu I\) 目标) | 0.589 | [0.571, 0.609] |
| 统计因子(PCA 前 5 个主成分 + 对角残差) | 0.845 | [0.821, 0.863] |
| 基本面因子(真实暴露 \(X\) 已知,逐日 OLS 估计 \(f_t\)) | 0.992 | [0.986, 0.997] |
| 样本 + eigenfactor 调整(USE4 附录 B 式 B7,30 次蒙特卡洛) | 0.888 | [0.858, 0.921] |
几点解读:
- 样本协方差的 0.199 与上面的理论值 \(1-q=0.200\) 一致。左图里红线(样本)的尾部比白线(真实)低一到两个数量级,优化器正是落在这些方向上。
- Ledoit-Wolf 把条件数压下来了,但偏差只修正了一半左右,原因是它的目标函数不是组合风险。
- 基本面因子接近无偏,是因为模拟里暴露 \(X\) 是真实的,有效维度 \(K/T = 0.02\)。现实中暴露本身有设定误差,这个结果是上界,不能当成”基本面模型几乎无偏”的证据。
- eigenfactor 调整只在样本协方差的特征基上放大小特征值,不需要知道真实结构,也能把偏差从 0.20 拉到 0.89。USE4 把它用在 \(K \times K\) 因子协方差上,第三节会讲它的流程。
估计细节:半衰期、Newey-West、两套权重
半衰期分开设。USE4 的做法是用较长的半衰期估相关、较短的半衰期估波动,再按 \(F_{ij} = \rho_{ij}\sigma_i\sigma_j\) 合成(Menchero, Orr & Wang 2011,式 4.1)。原因写在方法论文档里:对角元的采样误差对矩阵条件数影响很小,非对角元影响大,所以相关的半衰期必须足够长,保证有效样本数远大于因子数 \(K\)。USE4 表 4.1 的参数(单位:交易日):
| 模型 | 波动半衰期 | 波动 NW 滞后 | 相关半衰期 | 相关 NW 滞后 | VRA 半衰期 |
|---|---|---|---|---|---|
| USE4S | 84 | 5 | 504 | 2 | 42 |
| USE4L | 252 | 5 | 504 | 2 | 168 |
Newey-West 修正。USE4 的预测期是一个月,因子收益却是日频估计。日频收益若有序列相关,直接按 \(\sqrt{21}\) 放大会有偏差。USE4 用 Newey & West(1987,Econometrica)的滞后加权修正:
\[ \hat\Sigma_f^{NW} = \hat\Gamma(0) + \sum_{l=1}^{L} \left(1 - \frac{l}{L+1}\right) \left(\hat\Gamma(l) + \hat\Gamma(l)^\top\right), \qquad \hat\Gamma(l) = \sum_t w_t\, c_t c_{t-l}^\top \]
Bartlett 权重 \(1 - l/(L+1)\) 保证结果半正定。Newey-West 在因子检验中的另一种用法(Fama-MacBeth 斜率的 \(t\) 统计量)见 因子动物园 的单因子检验流水线。
相关与波动必须各用各的权重。常见的写法是”用相关权重算协方差、再除以波动权重算出来的标准差”。这样得到的矩阵对角线不是 1,非对角元可能超过 1,合成后的 \(\Sigma_f\) 也不保证半正定。正确的顺序是:先用相关权重得到完整的协方差并归一化成相关阵,再用波动权重得到的标准差缩放。
def ewma_weights(T: int, halflife: float) -> np.ndarray:
    w = 0.5 ** (np.arange(T)[::-1] / halflife)
    return w / w.sum()


def newey_west_cov(x: np.ndarray, weights: np.ndarray, lags: int) -> np.ndarray:
    """
    指数加权 + Newey-West 自相关修正:
        Gamma(l) = sum_t w_t c_t c_{t-l}^T
        Sigma = Gamma(0) + sum_{l=1..L} (1 - l/(L+1)) (Gamma(l) + Gamma(l)^T)
    """
    mean = weights @ x
    c = x - mean
    cov = (c * weights[:, None]).T @ c
    for lag in range(1, lags + 1):
        w = weights[lag:] / weights[lag:].sum()
        gamma = (c[lag:] * w[:, None]).T @ c[:-lag]
        cov += (1 - lag / (lags + 1)) * (gamma + gamma.T)
    return cov


def factor_model_cov(
    exposures: np.ndarray,
    factor_returns: pd.DataFrame,
    specific_var: np.ndarray,
    halflife_vol: int = 84,
    halflife_cor: int = 504,
    nw_lags_vol: int = 5,
    nw_lags_cor: int = 2,
) -> tuple[np.ndarray, np.ndarray]:
    """
    Barra 风格因子模型协方差:Sigma = X Sigma_f X^T + Delta
    - 相关性与波动率分别用不同半衰期与 Newey-West 滞后估计(参数取 USE4S 表 4.1)
    - 返回 (资产协方差, 因子协方差),单位与输入收益相同(日频)
    """
    fr = factor_returns.values
    T, _ = fr.shape

    cov_c = newey_west_cov(fr, ewma_weights(T, halflife_cor), nw_lags_cor)
    sd_c = np.sqrt(np.diag(cov_c))
    corr = cov_c / np.outer(sd_c, sd_c)

    cov_v = newey_west_cov(fr, ewma_weights(T, halflife_vol), nw_lags_vol)
    vol = np.sqrt(np.diag(cov_v))

    sigma_f = corr * np.outer(vol, vol)
    sigma = exposures @ sigma_f @ exposures.T + np.diag(specific_var)
    return (sigma + sigma.T) / 2, sigma_f
这段骨架没有包含 EM 算法补缺失值、eigenfactor 调整和波动率状态调整,后两者见第三节末尾。
三、Barra 多因子结构
从 Rosenberg 和 Fama-MacBeth 说起
Rosenberg(1974,Journal of Financial and Quantitative Analysis)给出了这套结构的起点:证券收益之间存在高度显著的”市场外协方差成分”(extra-market components of covariance),而且个股在这些因子上的载荷可以由可观测的公司特征决定,包括损益表和资产负债表数据、行业归属、历史收益行为。“暴露由公司特征给定,因子收益由横截面回归估计”,就是今天 Barra 式基本面因子模型的定义。
横截面回归的统计原型更早:Fama & MacBeth(1973,Journal of Political Economy)每期做一次横截面回归,再对斜率的时间序列做检验。两者的区别在于用途。Fama-MacBeth 关心斜率的均值是否显著(定价问题),风险模型关心斜率的协方差(风险问题)。同一个回归,前者产出因子溢价,后者产出 \(\Sigma_f\)。这也是 因子动物园 里的 alpha 因子和本文风险因子的分界:风险因子要求解释协方差,不要求有正溢价。
MSCI 公开的方法论文档记录了 Barra 模型的演进:初代全球模型 GEM 用月度横截面回归,GEM2 改为更高频观测并引入 World 因子,USE4 在 2011 年引入 eigenfactor 风险调整和波动率状态调整(Menchero, Orr & Wang 2011,第 1.2 节)。另一家主流厂商 Axioma 的美股模型 AXUS4 同时提供基本面版本(市场因子 + 风格因子 + 68 个 GICS 行业,平方根市值加权、带行业约束的 Huber 稳健回归)和统计版本(15 个统计因子,两步渐近主成分法)(Axioma AXUS4 factsheet)。两家公开文档的共同点是:国家或市场因子、行业因子、风格因子、特异收益四层结构,加上每日横截面回归。
国家因子
单一市场模型里,每只股票的国家暴露恒为 1。行业哑变量之和也恒为 1,与国家列完全共线,所以回归必须加一个约束(见下文)。USE4 选的约束让国家因子近似等于估计域的市值加权组合:方法论文档报告,1995 到 2011 年间 USE4 国家因子与估计域超额收益的时间序列相关约为 99.9%(Menchero, Orr & Wang 2011,Figure 3.1)。引入国家因子的另一个好处是行业间相关性的响应更快:两个行业通过共同的国家暴露联动,而国家因子的波动用的是较短的波动半衰期。
行业因子
行业暴露通常是 0/1 哑变量。USE4 和 CNE5 都以 GICS 为底,再按本地市场合并或拆分,选择标准是经济直觉、统计显著性、对解释力的增量,以及避免股票太少的”薄行业”(Menchero, Orr & Wang 2011,第 2.4 节)。
多元化经营的公司怎么处理?USE4 支持多行业暴露:在每个行业内用市值对资产(Assets)和销售额(Sales)做回归,据此把一家公司的暴露拆到多个行业(同上,第 2.5 节)。
行业的工程坑在行业切换。公司重组改行后,暴露会在某一天跳变。回测和归因必须用当时的行业分类,不能用今天的分类回填历史,这和 特征存储 讲的 point-in-time 原则是一回事。
风格因子
下表是 CNE5 的 10 个风格因子及其描述子权重,摘自 CNE5 Empirical Notes 附录 A(Orr, Mashtaler & Nagy 2012):
| 风格因子 | 描述子与权重 | 要点 |
|---|---|---|
| Size | 1.0 · LNCAP | 总市值的自然对数 |
| Beta | 1.0 · BETA | 对估计域市值加权超额收益的时序回归斜率,252 日窗口,半衰期 63 日 |
| Momentum | 1.0 · RSTR | 超额对数收益之和,504 日窗口,跳过最近 21 日,半衰期 126 日 |
| Residual Volatility | 0.74 · DASTD + 0.16 · CMRA + 0.10 · HSIGMA | 对 Beta 和 Size 正交化 |
| Non-linear Size | 1.0 · NLSIZE | 标准化 Size 的立方,对 Size 正交化后再缩尾、标准化 |
| Book-to-Price | 1.0 · BTOP | 最近一期普通股账面价值 / 当前市值 |
| Liquidity | 0.35 · STOM + 0.35 · STOQ + 0.30 · STOA | 1、3、12 个月换手率的对数;对 Size 正交化 |
| Earnings Yield | 0.68 · EPFWD + 0.21 · CETOP + 0.11 · ETOP | 分析师预测 12 个月远期 EP 权重最大 |
| Growth | 0.18 · EGRLF + 0.11 · EGRSF + 0.24 · EGRO + 0.47 · SGRO | 分析师长短期盈利增速预测 + 过去五年盈利和营收增长 |
| Leverage | 0.38 · MLEV + 0.35 · DTOA + 0.27 · BLEV | MLEV \(=(ME+PE+LD)/ME\),BLEV \(=(BE+PE+LD)/BE\),DTOA = 总负债 / 总资产 |
注意几点:USE4 的风格集合与 CNE5 不同,不要把这张表当成”Barra 通用十因子”;描述子权重是 MSCI 用优化算法”最大化模型解释力”得到的(USE4 第 2.3 节),自建模型需要在自己的样本上重新确定。
标准化约定。USE4 和 CNE5 都把描述子和风格暴露标准化为市值加权均值为 0、等权标准差为 1(USE4 式 2.4,CNE5 第 3.3 节)。用市值加权均值,是为了让市值加权的估计域对所有风格的暴露都约为 0;用等权标准差,是为了不让大盘股主导暴露的尺度。
共线性。Size、Beta、Residual Volatility、Liquidity 之间相关性高,所以 CNE5 对 Residual Volatility 做了 Beta 和 Size 正交化,对 Liquidity 做了 Size 正交化,Non-linear Size 对 Size 正交化。USE4 文档用方差膨胀因子(VIF)和因子稳定系数来筛查共线与不稳定的因子(第 2.1 节)。
横截面回归
每个交易日 \(t\) 在估计域内做一次回归:
\[ r_{n,t} = f_{c,t} + \sum_{j} X_{nj} f_{j,t} + \sum_{s} X_{ns} f_{s,t} + u_{n,t} \]
暴露 \(X\) 必须用 \(t-1\) 日收盘后可得的数据。用当日市值或当日动量解释当日收益,是典型的前视偏差(见 数据陷阱)。
回归权重。USE4 用加权最小二乘,假设特异收益的方差与总市值的平方根成反比(Menchero, Orr & Wang 2011,第 3.1 节)。按方差倒数加权,回归权重就是 \(v_n = \sqrt{\text{cap}_n}\)。CNE5 文档同样使用平方根市值加权。
约束。行业哑变量之和等于国家列,设计矩阵不满秩。USE4 的约束是行业因子收益的市值加权和为零:
\[ \sum_j w_j f_j = 0 \]
\(w_j\) 是估计域在行业 \(j\) 上的市值权重。方法论文档强调,约束的选择不影响拟合优度,只影响因子的解释:在这个约束下,国家因子近似为市值加权大盘,行业因子是”多该行业、空国家因子”的美元中性组合,风格因子是对该风格暴露为 1、对其他所有因子暴露为 0 的美元中性组合(USE4 第 3.1 节)。这里的”纯因子组合”解释与 Heston & Rouwenhorst(1994,Journal of Financial Economics)的做法同源:他们在分离国家效应和行业效应时,同样对哑变量系数施加了加权和为零的约束。
带约束的 WLS 可以写成 KKT 线性方程组:
\[ \begin{pmatrix} X^\top V X & R \\ R^\top & 0 \end{pmatrix} \begin{pmatrix} f \\ \lambda \end{pmatrix} = \begin{pmatrix} X^\top V r \\ 0 \end{pmatrix}, \qquad V = \operatorname{diag}(v_n) \]
\(R\) 在行业因子的位置上取行业市值权重,在其他位置取 0。
STYLE_FACTORS = [
    "size", "beta", "momentum", "residual_volatility", "non_linear_size",
    "book_to_price", "liquidity", "earnings_yield", "growth", "leverage",
]


def winsorize(x: pd.Series, n_std: float = 3.0) -> pd.Series:
    mu, sd = x.mean(), x.std()
    return x.clip(lower=mu - n_std * sd, upper=mu + n_std * sd)


def standardize(x: pd.Series, market_cap: pd.Series) -> pd.Series:
    """USE4 约定:市值加权均值为 0,等权标准差为 1"""
    w = market_cap / market_cap.sum()
    mu = (x * w).sum()
    return (x - mu) / (x.std(ddof=0) + 1e-12)


def build_exposure_matrix(
    descriptors: pd.DataFrame,
    industry: pd.Series,
    market_cap: pd.Series,
) -> tuple[pd.DataFrame, list[str], list[str]]:
    """一日的暴露矩阵 X = [country | industry dummies | standardized styles]"""
    style_block = pd.DataFrame(index=descriptors.index)
    for col in STYLE_FACTORS:
        x = winsorize(descriptors[col].astype(float))
        style_block[col] = standardize(x, market_cap)

    industry_block = pd.get_dummies(industry, prefix="ind").astype(float)
    country_block = pd.DataFrame({"country": 1.0}, index=descriptors.index)

    X = pd.concat([country_block, industry_block, style_block], axis=1)
    return X, list(industry_block.columns), STYLE_FACTORS


def cross_section_regression(
    returns: pd.Series,
    X: pd.DataFrame,
    market_cap: pd.Series,
    industry_cols: list[str],
) -> tuple[pd.Series, pd.Series]:
    """
    带约束的 WLS(回归权重 v_n = sqrt(cap_n)):
        min sum_n v_n (r_n - X_n f)^2
        s.t. sum_j w_j^{ind} f_j^{ind} = 0   (w^{ind} 为行业市值权重)
    用 KKT 线性方程组求解。
    """
    v = np.sqrt(market_cap.values)
    Xv = X.values
    rv = returns.values

    XtV = Xv.T * v
    AtA = XtV @ Xv
    Atb = XtV @ rv

    K = Xv.shape[1]
    ind_idx = [X.columns.get_loc(c) for c in industry_cols]
    ind_cap = X[industry_cols].T.values @ market_cap.values
    R = np.zeros(K)
    R[ind_idx] = ind_cap / ind_cap.sum()

    KKT = np.block([[AtA, R[:, None]], [R[None, :], np.zeros((1, 1))]])
    sol = np.linalg.solve(KKT, np.concatenate([Atb, [0.0]]))
    f = sol[:K]

    factor_returns = pd.Series(f, index=X.columns)
    residuals = pd.Series(rv - Xv @ f, index=returns.index)
    return factor_returns, residuals
两处实现细节值得对照检查。其一,回归权重是 \(v_n\)
本身,构造加权矩阵时不要再开一次方或平方:如果写成
A = diag(sqrt(cap)) @ X 再求
A.T @ A,实际权重就变成了 \(\text{cap}_n\),大盘股的影响被放大。其二,\(N=4000\) 时不要构造 \(N \times N\) 的对角矩阵,用广播
Xv.T * v 即可。
在 1000 只股票、10 个行业、10
个风格的模拟市场上跑一天(真实因子收益已按同一约束生成,risk_model_demo.py
第 [2] 段):
constraint sum_j w_j f_j = 1.98e-19
corr(f_hat, f_true) = 0.9717, max |f_hat - f_true| = 0.00425
cross-sectional R^2 = 0.255
             true      est
country  -0.01605 -0.01495
ind_00   -0.01008 -0.00921
size      0.00161  0.00147
momentum  0.00184  0.00222
约束在机器精度内成立,估计的因子收益与真值相关 0.97。单日的估计误差(这里最大 0.4%)来自特异收益噪声,这也是因子协方差要用几百天数据做指数加权的原因。
因子协方差的两项 USE4 修正
eigenfactor 风险调整。USE4 方法论文档第 4.2 节和附录 B 描述了流程:
- 对样本因子协方差 \(F_0\) 做特征分解 \(D_0 = U_0^\top F_0 U_0\),特征向量就是互不相关的”特征因子”组合。
- 假设 \(F_0\) 是真实协方差,模拟 \(M\) 组同样长度的因子收益,每组重新估计协方差 \(F_m\) 并分解得到 \(U_m, D_m\)。
- 计算模拟特征因子的真实方差 \(\tilde D_m = U_m^\top F_0 U_m\) 的对角元,得到偏差 \[v(k) = \sqrt{\frac{1}{M}\sum_m \frac{\tilde D_m(k)}{D_m(k)}}\]
- 把样本特征方差乘以 \(v^2(k)\) 再转回原坐标:\(\tilde F_0 = U_0 \operatorname{diag}(v^2 D_0) U_0^\top\)。
文档承认模拟假设正态和平稳,低估了真实偏差,于是在研究版本里对 \(v(k)\) 做抛物线拟合并按 \(v_S(k) = a\,[v_P(k) - 1] + 1\)、\(a = 1.4\) 放大;但这样会让单个纯因子出现小偏差,所以生产中的 USE4 采用较温和的未缩放版本(式 B7)。第二节模拟里的”样本 + eigenfactor 调整”用的就是式 B7 的做法。Menchero, Wang & Orr(2012,Financial Analysts Journal)给出了这一方法的完整分析。
波动率状态调整(Volatility Regime Adjustment,VRA)。用横截面信息判断整体风险预测是否偏低或偏高。定义每日的横截面偏差统计量
\[ B_t^F = \sqrt{\frac{1}{K}\sum_k \left(\frac{f_{kt}}{\sigma_{kt}}\right)^2} \]
如果预测准确,标准化收益的横截面标准差应接近 1。对 \((B_t^F)^2\) 做指数加权平均得到乘数 \(\lambda_F^2\),整个因子协方差矩阵乘以 \(\lambda_F^2\)(USE4 式 4.3 至 4.5)。它只改变波动的水平,不改变相关。文档报告,没有 VRA 时出现了”进入危机时低估风险、危机后高估风险”的典型形态,加入 VRA 后大部分样本期的平均偏差统计量更接近 1(第 4.3 节,Figure 4.7)。
因子收益怎么读
因子收益序列本身是市场结构的记录:哪段时间小盘占优、哪段时间价值风格轮动、低波动是否持续有溢价。A 股上各风格的方向与 regime 切换,因子动物园 第十二节有专门讨论,那里也说明了量级必须在自有 point-in-time 样本上复现。这里只强调一条:风险因子是为了解释协方差而设计的,它的收益方向不稳定是常态,不能直接拿来当选股信号。
四、特异风险与残差波动
横截面回归的残差 \(u_{n,t}\) 是特异收益,它的方差 \(\delta_n^2\) 是特异风险。分散化组合里特异风险占比小,但集中持仓、小盘股、跟踪误差预算里它往往是主角。
朴素估计的问题
最朴素的做法是对每只股票用过去 \(T\) 天残差的样本方差。问题有三个:
第一,停牌、新股、长期缺失让有效样本变短。连续停牌期内残差记为 0 会低估方差,正确的做法是剔除停牌日,并把复牌日的”补涨补跌”单独处理,因为它累积了停牌期间的市场变动,不是当日的特异收益。
第二,样本方差的抽样误差会被优化器放大。方差估计的标准误约为 \(\delta^2\sqrt{2/(T-1)}\),\(T=252\) 时相对误差约 9%。优化器偏爱特异风险看起来低的股票,而这些股票恰恰是被低估的那一批。USE4 用分位数检验确认了这种偏差:不做收缩时,模型倾向于低估低特异波动股票的风险、高估高特异波动股票的风险(Menchero, Orr & Wang 2011,Figure 5.1)。
第三,特异波动有共同的时变成分。市场整体进入高波动状态时,单只股票的时间序列看不出这个共同冲击。
USE4 的特异风险流程
USE4 第 5 节把特异风险估计拆成四步,CNE5 沿用同一方法:
1. 时间序列估计。用指数加权和 Newey-West 自相关修正估计每只股票的特异波动 \(\sigma_n^{TS}\)。USE4S 的参数是:特异波动半衰期 84 日,Newey-West 滞后 5 日,自相关半衰期 252 日(表 5.1)。
2. 结构化模型混合。对样本不足(缺失收益多)或尾部过厚的股票,时间序列估计不可靠。USE4 定义混合系数 \(\gamma_n \in [0, 1]\):缺失少且尾部不过厚时取 1,严重违反时取 0。用 \(\gamma_n = 1\) 的股票做横截面回归,把特异波动的对数回归到模型自身的因子暴露上:
\[ \ln \sigma_n^{TS} = \sum_k X_{nk} b_k + \epsilon_n, \qquad \sigma_n^{STR} = E_0 \exp\Big(\sum_k X_{nk} b_k\Big) \]
\(E_0\) 是略大于 1 的常数,用来修正指数化残差带来的偏差。最终 \(\hat\sigma_n = \gamma_n \sigma_n^{TS} + (1-\gamma_n)\sigma_n^{STR}\)。直觉是:特征相近的股票,特异波动也相近。文档说明大部分 USE4 股票 \(\gamma_n = 1\)。
3. 贝叶斯收缩。按市值十分位分组,把每只股票的估计向所在组的市值加权平均 \(\bar\sigma(s_n)\) 收缩:
\[ \sigma_n^{SH} = v_n \bar\sigma(s_n) + (1 - v_n)\hat\sigma_n, \qquad v_n = \frac{q\,|\hat\sigma_n - \bar\sigma(s_n)|}{\Delta_\sigma(s_n) + q\,|\hat\sigma_n - \bar\sigma(s_n)|} \]
\(\Delta_\sigma(s_n)\) 是组内特异波动的标准差,USE4 取 \(q = 0.1\)。偏离组均值越远,收缩越多。文档报告,收缩后各特异波动十分位的偏差统计量接近 1,且不再随波动水平单调变化(Figure 5.2)。
4. 特异波动率状态调整。与因子 VRA 同理,用特异收益的横截面偏差统计量计算乘数,USE4S 的 VRA 半衰期为 42 日。
时间序列部分也可以用 EWMA 的递推形式写:
\[ \hat\delta_{n,t}^2 = \lambda \hat\delta_{n,t-1}^2 + (1-\lambda) u_{n,t}^2 \]
J.P. Morgan/Reuters 的 RiskMetrics 技术文档(1996)对日频数据取 \(\lambda = 0.94\),对应半衰期 \(\ln 0.5 / \ln 0.94 \approx 11.2\) 天;\(\lambda = 0.97\) 对应约 22.8 天。GARCH(1,1)(Engle 1982;Bollerslev 1986)多了均值回复项,但参数要逐股票估计,对样本短的股票不稳定。
特异收益独立性的检查
“特异收益互不相关”是因子模型最脆弱的假设。残差里如果藏着一个未被模型覆盖的共同驱动(某个题材、某类资金流),所有暴露在它上面的股票残差会同向偏离,组合风险被低估。可执行的检查是对残差矩阵做主成分分析:如果前几个主成分解释的方差明显超出纯噪声下 Marčenko-Pastur 上界给出的水平,就说明残差还有结构。处理方式要么是加入新的行业或风格因子,要么在残差上叠加少量统计因子,这也是第九节”基本面 vs 统计因子”争论的工程落点。统计套利 里的 PCA 残差策略,用的是同一套分解,只是方向相反:它交易残差,风险模型要把残差解释干净。
五、风险归因
事前风险归因:边际贡献与组合贡献
组合预测方差:
\[ \sigma_p^2 = w^\top \Sigma w = b^\top \Sigma_f b + \sum_i w_i^2 \delta_i^2, \qquad b = X^\top w \]
只拆到”因子 vs 特异”还不够,还要知道具体哪个因子贡献最大。边际风险贡献(marginal contribution to risk,MCR)和组合风险贡献(component contribution to risk,CCR)定义为:
\[ \text{MCR}_k = \frac{\partial \sigma_p}{\partial b_k} = \frac{(\Sigma_f b)_k}{\sigma_p}, \qquad \text{CCR}_k = b_k \cdot \text{MCR}_k = \frac{b_k (\Sigma_f b)_k}{\sigma_p} \]
由于 \(\sigma_p\) 对 \((b, w)\) 是一次齐次函数,欧拉定理保证
\[ \sum_k \text{CCR}_k + \frac{\sum_i w_i^2 \delta_i^2}{\sigma_p} = \sigma_p \]
各项贡献加起来恰好等于组合波动。单个 CCR 可以为负,表示该因子在组合里起对冲作用。
def portfolio_risk_attribution(
    weights: pd.Series,
    exposures: pd.DataFrame,
    sigma_f: pd.DataFrame,
    specific_var: pd.Series,
) -> pd.DataFrame:
    """事前风险归因:每个因子与特异部分的方差贡献、波动贡献、占比(欧拉分解)"""
    w = weights.reindex(exposures.index).fillna(0).values
    X = exposures.values
    Sf = sigma_f.values
    delta = specific_var.reindex(exposures.index).fillna(0).values

    b = X.T @ w
    factor_ccr_var = b * (Sf @ b)
    specific_total = float((w ** 2 * delta).sum())
    total_var = float(factor_ccr_var.sum()) + specific_total
    sigma_p = np.sqrt(total_var)

    out = pd.DataFrame({
        "exposure": b,
        "var_contrib": factor_ccr_var,
        "vol_contrib": factor_ccr_var / sigma_p,
        "share": factor_ccr_var / total_var,
    }, index=exposures.columns)
    out.loc["specific"] = [np.nan, specific_total, specific_total / sigma_p,
                           specific_total / total_var]
    out.loc["TOTAL"] = [np.nan, total_var, sigma_p, 1.0]
    return out
risk_model_demo.py 第 [3]
段在第三节的模拟市场上连续跑 500 天横截面回归,用 USE4S
参数估计 \(\Sigma_f\),特异方差取残差平方的
84 日半衰期 EWMA,然后对”市值最小 30%
的股票等权”组合做归因:
min eigenvalue of asset Sigma = 4.162e-05 (PSD check)
country vol: est 0.165 vs true 0.190 (annualized)
small-cap equal-weight portfolio, variance share by group:
country     0.5270
industry   -0.0043
style       0.4634
specific    0.0139
annualized vol = 0.2257, sum of vol_contrib = 0.2257
                 exposure  var_contrib  vol_contrib     share
country          1.000000     0.000106     0.007492  0.527002
size            -2.391970     0.000049     0.003433  0.241482
non_linear_size -2.122424     0.000044     0.003082  0.216772
specific              NaN     0.000003     0.000197  0.013874
TOTAL                 NaN     0.000202     0.014216  1.000000
各项波动贡献之和等于组合波动(0.2257),欧拉分解闭合。这个”小盘等权”组合有 46% 的方差来自风格,几乎全部集中在 Size 和 Non-linear Size 两个因子上:标准化用的是市值加权均值,小盘股的 Size 暴露因此远低于 0(这里是 -2.39)。国家因子波动的估计值 16.5% 低于真值 19.0%,是 84 日半衰期下有效样本有限造成的抽样误差。
下图换一个参数完全指定的模拟风险模型(参数写在图注里),对比四种组合的风险结构:
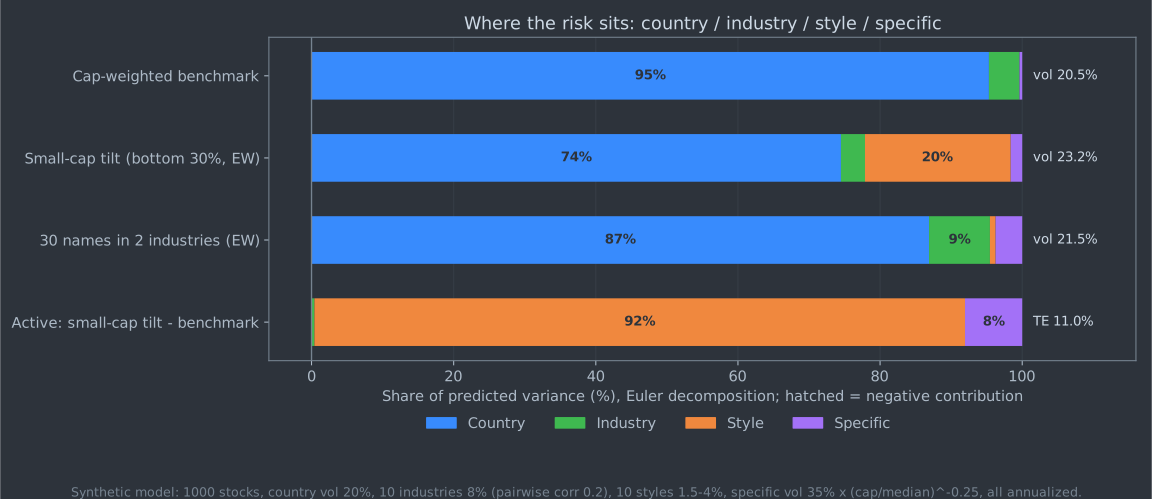
| 组合 | 国家 | 行业 | 风格 | 特异 | 年化波动 / 跟踪误差 |
|---|---|---|---|---|---|
| 市值加权基准 | 95.3% | 4.3% | 0.0% | 0.4% | 20.5% |
| 小盘倾斜(市值后 30% 等权) | 74.5% | 3.4% | 20.5% | 1.6% | 23.2% |
| 两个行业内 30 只股票等权 | 86.9% | 8.6% | 0.8% | 3.7% | 21.5% |
| 主动部分:小盘倾斜 − 基准 | 0.0% | 0.4% | 91.5% | 8.0% | 跟踪误差 11.0% |
两条结论。第一,多头组合的总风险里国家因子占绝对多数,所以要看主动部分的分解,主动风险才是基金经理真正做出的选择:这里 91.5% 的跟踪误差方差来自风格押注。第二,基准的风格暴露为 0,是市值加权均值标准化的直接结果,与第三节的约定一致。
事后收益归因:Brinson 与多因子
Brinson & Fachler(1985,Journal of Portfolio Management)把超额收益拆成行业配置和选股两部分:
\[ r_p - r_b = \underbrace{\sum_j (w^p_j - w^b_j)(r^b_j - r^b)}_{\text{配置}} + \underbrace{\sum_j w^p_j (r^p_j - r^b_j)}_{\text{选股(含交互项)}} \]
Brinson, Hood & Beebower(1986,Financial Analysts Journal)给出了配置、选股、交互三项的分解。Brinson 框架只到行业一层;多因子归因把风格也拆出来:
\[ r_p = \underbrace{\sum_k b_{p,k} f_k}_{\text{因子收益}} + \underbrace{\sum_i w_i u_i}_{\text{特异收益}} \]
def portfolio_return_attribution(
    weights: pd.Series,
    exposures: pd.DataFrame,
    factor_returns: pd.Series,
    asset_returns: pd.Series,
) -> pd.DataFrame:
    """事后收益归因:组合收益 = sum_k b_k f_k + sum_n w_n u_n"""
    w = weights.reindex(exposures.index).fillna(0).values
    X = exposures.values
    f = factor_returns.reindex(exposures.columns).fillna(0).values
    r = asset_returns.reindex(exposures.index).fillna(0).values

    b = X.T @ w
    specific = float(w @ (r - X @ f))
    out = pd.DataFrame({"exposure": b, "factor_return": f, "contribution": b * f},
                       index=exposures.columns)
    out.loc["specific"] = [np.nan, np.nan, specific]
    out.loc["TOTAL"] = [np.nan, np.nan, float(b @ f) + specific]
    return out
运行检查归因是否闭合:
return attribution closes: TOTAL -0.01239973 vs w'r -0.01239973归因的常见误用
把因子收益当 alpha。大部分收益来自 Size、Momentum 这类风格因子的组合,实质是风格暴露,换一个风格周期就会消失。事后绩效指标怎么剔除这部分,见 绩效指标。
归因不闭合。因子贡献加特异贡献必须等于组合收益(不考虑交易成本和现金)。不闭合通常意味着:暴露用错了日期(用了当日而非 \(t-1\))、因子收益与暴露版本不匹配、组合权重没用日初权重。
跨期累加。日度简单收益的贡献不能直接相加成月度贡献,因为简单收益是复利累乘的。Cariño(1999,Journal of Performance Measurement)提出的对数链接系数是常用的修正方法;直接加总在短区间、低收益时误差小,区间越长误差越大。
六、VaR 与 ES
定义
损失 \(L = -r_p\) 在置信水平 \(\alpha\) 下的风险价值(value at risk,VaR)和预期短缺(expected shortfall,ES)为:
\[ \text{VaR}_\alpha = \inf\{\ell : \Pr(L \le \ell) \ge \alpha\}, \qquad \text{ES}_\alpha = \frac{1}{1-\alpha}\int_\alpha^1 \text{VaR}_u \, du \]
对连续分布,\(\text{ES}_\alpha = \mathbb{E}[L \mid L \ge \text{VaR}_\alpha]\)。
三种估计法
参数法。假设组合收益正态、均值近似为 0,直接用第二节的 \(\Sigma\):
\[ \text{VaR}_\alpha(h) = z_\alpha \sigma_p \sqrt{h}, \qquad \text{ES}_\alpha(h) = \sigma_p \sqrt{h}\, \frac{\phi(z_\alpha)}{1-\alpha}, \qquad z_\alpha = \Phi^{-1}(\alpha) \]
\(\alpha = 0.99\) 时 \(z_\alpha \approx 2.326\)。快,能直接接因子模型,也能按因子做 VaR 归因;代价是忽略厚尾。\(\sqrt{h}\) 放大只在收益独立同分布时成立。
历史模拟法。把过去 \(T\) 天的组合收益(按当前持仓重估)当作经验分布,取分位数。不假设分布形式,能保留偏度和厚尾;代价是对 regime 切换反应慢,而且尾部样本很少:1000 个观测在 99% 水平只有 10 个尾部点。
Monte Carlo 法。从拟合的分布(多元 \(t\)、copula 等)采样路径,逐路径重定价。含期权等非线性头寸时基本只能用这种方法,代价是计算量和模型设定误差。
Hull-White 波动率调整。Hull & White(1998,Journal of Risk)把每个历史收益按”当前波动 / 当时波动”缩放后再做历史模拟,让历史分布的形状保留下来、尺度对齐到当前。
from scipy.stats import chi2, norm


def historical_var(returns: pd.Series, alpha: float = 0.99, horizon: int = 1) -> dict:
    """历史模拟 VaR / ES(正数表示损失);horizon>1 时用重叠窗口累加收益"""
    r = returns.dropna()
    if horizon > 1:
        r = r.rolling(horizon).sum().dropna()
    losses = -r.values
    var_q = float(np.quantile(losses, alpha))
    tail = losses[losses >= var_q]
    return {"VaR": var_q, "ES": float(tail.mean()), "n_obs": len(losses),
            "n_tail": len(tail)}


def historical_var_with_volatility_scaling(
    returns: pd.Series, alpha: float = 0.99, lam: float = 0.94
) -> dict:
    """
    Hull-White (1998) 波动率调整历史模拟:
    sigma_t^2 = lam * sigma_{t-1}^2 + (1 - lam) * r_{t-1}^2(只用 t 之前的信息)
    每个历史收益按 sigma_now / sigma_t 缩放后再取分位数
    """
    r = returns.dropna().values
    sig2 = np.empty(len(r) + 1)
    sig2[0] = r[:20].var()
    for t in range(1, len(r) + 1):
        sig2[t] = lam * sig2[t - 1] + (1 - lam) * r[t - 1] ** 2
    sigma_hist, sigma_now = np.sqrt(sig2[:-1]), np.sqrt(sig2[-1])
    losses = -r * (sigma_now / sigma_hist)
    var_q = float(np.quantile(losses, alpha))
    tail = losses[losses >= var_q]
    return {"VaR": var_q, "ES": float(tail.mean()), "sigma_now": float(sigma_now)}


def parametric_var(weights: np.ndarray, sigma: np.ndarray, alpha: float = 0.99,
                   horizon: int = 1) -> dict:
    """正态参数法(均值取 0):VaR = z * sigma_p * sqrt(h),ES = sigma_p * sqrt(h) * phi(z) / (1-alpha)"""
    sigma_p = float(np.sqrt(weights @ sigma @ weights)) * np.sqrt(horizon)
    z = norm.ppf(alpha)
    return {"VaR": z * sigma_p, "ES": sigma_p * norm.pdf(z) / (1 - alpha),
            "sigma_p": sigma_p}
risk_model_demo.py 第 [4] 段构造了一个有
regime 切换的序列:1000 天自由度为 4 的 \(t\)
分布收益(标准化为单位方差),前 750 天日波动 1%,最后 250
天升到 2%。当前 regime 下的真实 99% VaR 和 ES
可以解析算出,用来对照:
alpha=0.99: HS VaR 0.0364 ES 0.0536 | HW VaR 0.0725 ES 0.1091 | n_tail 10
alpha=0.975: HS VaR 0.0276 ES 0.0400 | HW VaR 0.0513 ES 0.0809 | n_tail 25
true current-regime t(4) 99%: VaR 0.0530 ES 0.0738
parametric (last 250d vol) 99%: VaR 0.0474 ES 0.0543
10-day HS VaR 99% (overlapping) = 0.1256
三种方法的误差方向各不相同。历史模拟(HS)把 750 天低波动样本混进来,VaR 0.0364 比真值 0.0530 低了三成。正态参数法用对了最近 250 天的波动,但正态尾部太薄,ES 0.0543 比真值 0.0738 低了 26%。Hull-White 在这一次实现里高估了(0.0725):结尾那段的 EWMA 波动 \(\sigma_{\text{now}}\) 恰好被几个大的 \(t\) 分布收益推高,而 \(\lambda=0.94\) 的有效窗口只有十几天。这个例子说明,没有哪种方法在所有 regime 下都占优,这也是生产中通常让几种方法并行、互相校验的原因。
工程对比
| 方法 | 相对速度 | 分布假设 | 厚尾 | 适用范围 | 主要陷阱 |
|---|---|---|---|---|---|
| 参数法 | 最快 | 正态或 \(t\) | 弱 | 线性头寸 | 尾部低估;\(\sqrt{h}\) 放大依赖独立同分布 |
| 历史模拟 | 快 | 无 | 保留历史尾部 | 线性头寸,或可快速全量重估的组合 | regime 切换时滞后;尾部样本少 |
| Hull-White | 快 | 历史分布形状不变 | 保留 | 同上 | 对 \(\lambda\) 和近期大收益敏感 |
| Monte Carlo | 最慢 | 任意可采样分布 | 取决于模型 | 含衍生品的组合 | 模型设定误差;计算成本 |
几种方法并行时,结果差异超过某个阈值就触发人工复核,阈值按组合类型校准,这是工程做法,不是监管要求。
为什么监管从 VaR 转向 ES
Artzner, Delbaen, Eber & Heath(1999,Mathematical Finance)提出一致性风险测度(coherent risk measure)的四条公理:单调性、次可加性、正齐次性、平移不变性。VaR 一般不满足次可加性:合并两个组合后的 VaR 可能大于各自 VaR 之和,与”分散化不应增加风险”相矛盾。Acerbi & Tasche(2002,Journal of Banking & Finance)证明了 ES 是一致性风险测度。VaR 也不区分超过分位数之后的损失有多大,两个分布在 99% 分位数相同、尾部长度不同,VaR 报同一个数,ES 能区分。
巴塞尔委员会的市场风险框架(BCBS 2016 年 1 月发布 d352,2019 年 1 月发布修订版 d457,现已并入 Basel Framework 的 MAR 章节)把内部模型法的核心度量从 VaR(99%)加压力 VaR 换成了压力期校准的 ES。MAR33.2 规定计算 ES 必须使用 97.5% 单尾置信水平;MAR33.3 至 MAR33.4 要求以 10 天为基准流动性期限,再按风险因子的流动性期限放大。d457 的发布页写明修订版自 2022 年 1 月 1 日生效,各司法辖区的实际落地时间不同。
回测:Kupiec、Christoffersen 与红绿灯
VaR 模型要回测:\(T\) 天里实际损失超过 VaR 的次数 \(x\) 应接近 \(T(1-\alpha)\)。Kupiec(1995,Journal of Derivatives)的失败比例检验(proportion of failures,POF):
\[ \text{LR}_{POF} = -2\ln\left[\frac{(1-\alpha)^x \alpha^{T-x}}{\hat p^{\,x} (1-\hat p)^{T-x}}\right], \qquad \hat p = x/T \]
原假设下渐近服从 \(\chi^2(1)\),5% 显著性水平的临界值为 3.84。Christoffersen(1998,International Economic Review)进一步检验例外是否在时间上独立(不扎堆),并把频率检验和独立性检验合成条件覆盖检验。
巴塞尔的红绿灯规则见 MAR32.9 表 1:对 250 个观测、99% VaR 的例外次数分区,绿区 0 到 4 次(乘数 1.50),黄区 5 到 9 次(乘数 1.70 至 1.92),红区 10 次及以上(乘数 2.00)。MAR32.14 规定,进入红区时监管会自动提高乘数,或者不再允许银行使用该模型。
def kupiec_pof(n_exceptions: int, n_obs: int, alpha: float = 0.99) -> dict:
    """Kupiec (1995) proportion-of-failures 似然比检验"""
    p, x, T = 1 - alpha, n_exceptions, n_obs
    phat = x / T
    ll0 = (T - x) * np.log(1 - p) + x * np.log(p)
    ll1 = (T - x) * np.log(1 - phat) + (x * np.log(phat) if x > 0 else 0.0)
    lr = -2 * (ll0 - ll1)
    return {"LR": float(lr), "p_value": float(1 - chi2.cdf(lr, df=1))}


def basel_traffic_light(n_exceptions: int) -> str:
    """BCBS MAR32.9:250 个观测、99% VaR 的例外次数分区"""
    if n_exceptions <= 4:
        return "green"
    return "amber" if n_exceptions <= 9 else "red"
对上面那个 regime 切换序列的最后 250
天做滚动回测(risk_model_demo.py 第 [5]
段):
HS: exceptions 5/250, Kupiec LR 1.96, p 0.1619, traffic light amber
Hull-White: exceptions 3/250, Kupiec LR 0.09, p 0.7580, traffic light green
滚动 250 日历史模拟出现 5 次例外,落入黄区,但 Kupiec 检验在 5% 水平上并不拒绝原假设(\(p = 0.16\))。原因是 250 个观测在 99% 水平下只期望 2.5 次例外,检验功效很低,这也是红绿灯规则需要用分区而不是单一 \(p\) 值的原因。
七、压力测试与情景分析
VaR 和 ES 都是从某个分布里估计出来的统计量,分布外的事件它们看不到。压力测试直接构造极端情景,按情景重新计算组合损失。两者是互补关系。

在因子模型下,情景就是一个因子冲击向量 \(\Delta f\) 加上个股特异冲击 \(\Delta u\),组合损失为:
\[ L_{\text{scen}} = -b^\top \Delta f - w^\top \Delta u \]
历史情景
从自有因子收益库里截取历史窗口的累计因子收益作为 \(\Delta f\),叠加到当前持仓上。下表是 A 股常用的候选窗口。本文不给出各窗口的指数跌幅:冲击向量应当用自己的因子库按窗口重算,口径不同,数字差异很大。
| 情景 | 窗口 | 需要刻画的冲击 |
|---|---|---|
| 全球金融危机 | 2008 年 9 月至 11 月 | 国家因子大幅下跌,相关性整体上升,流动性收缩 |
| A 股去杠杆 | 2015 年 6 月至 9 月 | 国家因子连续下跌,杠杆资金被动平仓,大面积跌停导致无法成交 |
| 熔断周 | 2016 年 1 月第一周 | 交易时间被截断,日内无法调仓 |
| 疫情首轮冲击 | 2020 年春节后首个交易日前后 | 单日跳空,随后快速修复 |
| 风格反转 | 2021 年 2 月起 | 大市值、高估值风格回撤,Size 因子方向切换 |
| 小盘急跌 | 2024 年 2 月上旬 | Size、Liquidity 等风格因子极端收益,小盘股流动性折价 |
历史情景的优点是真实发生过,缺点是下一次危机的细节不会重复。2016 年熔断这类事件主要冲击的是”能不能交易”,因子收益本身刻画不了,要和第八节的执行约束、运维与合规 里的熔断处置预案一起看。
假设情景
由风控人员手工构造联合冲击,例如:国家因子单日 -10%;动量 -3σ 同时价值 +3σ;单一行业 -25% 其他行业不变;利率 +200bp 或汇率 ±5% 通过行业暴露传导;冲击成本 ×3、可成交量 ×0.3。最后一类不改变因子收益,改变的是平仓成本,需要接 交易成本模型 里的冲击成本函数,把”按当前持仓在 N 天内平掉要付多少成本”加进情景损失。
假设情景的难点是”哪些因子同时动、动多少”。冲击之间不协调(例如国家因子大跌但所有行业不动)会得到一个在现有相关结构下几乎不可能的情景,下面的反向压力测试可以用来校验。
反向压力测试
给定目标损失 \(L^*\),求”最可能”导致该损失的因子冲击,即在因子分布下马氏距离最小的冲击:
\[ \min_{\Delta f}\ \frac{1}{2}\Delta f^\top \Sigma_f^{-1} \Delta f \quad \text{s.t.} \quad -b^\top \Delta f = L^* \]
拉格朗日条件给出闭式解:
\[ \Delta f^* = -\frac{L^*}{b^\top \Sigma_f b}\, \Sigma_f b \]
冲击方向是 \(\Sigma_f b\),即组合的因子风险贡献方向;所需的马氏距离为 \(L^*/\sqrt{b^\top \Sigma_f b}\),也就是”要亏 \(L^*\) 需要几个因子风险标准差”。这个闭式解假设损失对因子线性、因子收益近似正态,含期权的组合不适用。
def reverse_stress(b: np.ndarray, sigma_f: np.ndarray, target_loss: float) -> np.ndarray:
    """
    min 0.5 * df' Sigma_f^{-1} df  s.t.  -b' df = L*
    闭式解:df* = -L* Sigma_f b / (b' Sigma_f b)
    """
    sb = sigma_f @ b
    return -target_loss * sb / float(b @ sb)
对第五节那个小盘等权组合,用月度因子协方差(日协方差
×21)求 10%
损失的反向情景,并把冲击换算成各因子月度标准差的倍数(risk_model_demo.py
第 [6] 段):
loss check -b'df = 0.1000
largest shocks in monthly sigma units:
country           -1.12
size               0.76
non_linear_size    0.65
ind_03             0.28
结论可以直接读:这个组合亏 10% 最可能的路径是”大盘跌约 1.1 个月度标准差,同时大盘股跑赢小盘股约 0.7 个标准差”。如果风控的假设情景库里没有类似组合,就是一个缺口。
尾部相关性
压力情景还要面对相关性在尾部上升的问题。Longin & Solnik(2001,Journal of Finance)用极值理论研究国际股市,发现相关性在熊市尾部上升、在牛市尾部不上升;Ang & Chen(2002,Journal of Financial Economics)发现美股组合与市场之间的相关性在下跌时明显高于上涨时。正常时期估计的相关矩阵会高估危机中的分散化效果。
一种工程处理是在压力情景中把相关阵向全 1 矩阵 \(J\) 推:
\[ \rho^{\text{stress}} = (1-\kappa)\,\rho + \kappa J, \qquad \kappa \in [0, 1] \]
非对角元即 \(\rho_{ij} + \kappa(1-\rho_{ij})\)。因为 \(\rho\) 和 \(J\) 都半正定,凸组合仍然半正定,不需要额外修复。\(\kappa\) 的取值没有理论答案,应当用自己的历史危机窗口校准;更精细的做法是用 \(t\)-copula 或 Clayton copula 显式建模下尾相关。
监管框架
巴塞尔市场风险框架里,ES 要按压力期校准(d352 发布页称之为”a shift from value-at-risk to an expected shortfall measure of risk under stress”),交易台层面还要通过损益归属测试(P&L attribution test)和回测才能使用内部模型法,否则回退到标准法(MAR32)。资管机构受到的监管压力测试要求比银行少,但内部风控通常也会参照这套”ES + 情景库 + 回测”的结构搭建。
八、工程实现
每日刷新流水线
下面是一个按 A 股收盘时间设计的示例时间表,用来说明依赖顺序,不是某家机构的实际流程:
- 收盘后:等待收盘价、复权因子、行业分类、财务数据的 ETL 完成(数据管线见 行情与基本面数据管线)。
- 构造 \(t-1\) 期暴露矩阵 \(X\)。
- 横截面回归,得到当日因子收益 \(f_t\) 和残差 \(u_t\)。
- 更新因子协方差 \(\Sigma_f\)(含 Newey-West、eigenfactor 调整、VRA)和特异波动 \(\delta_i\)。
- 合成资产协方差或直接以因子形式落库。
- 对当前持仓跑风险归因、VaR / ES、压力测试,生成报告。
每一步都需要依赖管理、失败重试、版本号和回滚。调度通常交给 Airflow、Prefect、Dagster 这一类框架。
计算量:本机实测
用 risk_model_demo.py 第 [8] 段在 A
股量级上计时:\(N=4000\),1
个国家、32 个行业、10 个风格(\(K=43\)),每项运行 5
次取中位数,环境见开头说明。
| 步骤 | 规模 | 中位耗时(ms) |
|---|---|---|
build_exposure_matrix |
4000 × 10 个描述子 | 16.42 |
cross_section_regression |
4000 × 43,含 KKT 求解 | 1.26 |
factor_model_cov |
1000 天 × 43 因子,含 4000 × 4000 资产协方差合成 | 420.84 |
portfolio_risk_attribution |
单组合 | 1.50 |
historical_var |
1000 个观测 | 0.08 |
耗时大头是 \(4000 \times 4000\) 资产协方差的合成,单个矩阵就是 128 MB(float64)。实际系统通常只存 \(X\)、\(\Sigma_f\)、\(\delta^2\),需要组合风险时按 \(b = X^\top w\) 在因子空间里算,不物化完整的 \(\Sigma\)。按日存档时,这三样的体积也远小于完整协方差。
模型版本与回测一致性
风险模型会迭代:加因子、调权重、改估计方法。回测和归因必须用当时的模型版本,而不是最新版本:
- 每个版本的因子定义、行业分类、估计参数和每日快照都要存档,打上版本号;
- 跨版本对比时,在同一区间用两个版本各跑一遍,并解释差异;
- 用今天的定义回算历史因子收益,就是 回测陷阱 里讨论的前视偏差。
每个优化任务的输入快照都带哈希存档,“同样输入得到不同输出”就说明数据流或优化器存在非确定性问题:
import hashlib


class RiskModelSnapshot:
    def __init__(self, date: pd.Timestamp, version: str, exposures: pd.DataFrame,
                 factor_cov: pd.DataFrame, specific_var: pd.Series):
        self.date = date
        self.version = version
        self.exposures = exposures          # (N, K)
        self.factor_cov = factor_cov        # (K, K)
        self.specific_var = specific_var    # (N,)

    def asset_cov(self) -> np.ndarray:
        X = self.exposures.values
        S = X @ self.factor_cov.values @ X.T + np.diag(self.specific_var.values)
        return (S + S.T) / 2

    def hash(self) -> str:
        h = hashlib.sha256()
        h.update(self.date.isoformat().encode())
        h.update(self.version.encode())
        for arr in (self.exposures.values, self.factor_cov.values, self.specific_var.values):
            h.update(np.ascontiguousarray(arr, dtype=np.float64).tobytes())
        return h.hexdigest()[:16]
[7] snapshot hash 04622b15fca214da, asset cov symmetric Truenp.ascontiguousarray(..., dtype=np.float64)
不能省:pandas 返回的数组可能是非连续视图或不同 dtype,直接
tobytes() 会让同样的数值得到不同的哈希。
与组合优化器对接
在二次规划里显式使用风险模型:
\[ \max_w \quad \mu^\top w - \frac{\lambda}{2} w^\top \Sigma w \]
加上行业偏离、风格偏离、跟踪误差、单股上限等约束。因子形式可以把稠密的 \(N \times N\) 二次项拆开:引入辅助变量 \(y = X^\top w\),
\[ w^\top \Sigma w = y^\top \Sigma_f y + \sum_i \delta_i^2 w_i^2 \]
二次项变成 \(K \times K\) 稠密加对角,cvxpy、MOSEK 这类建模工具都能直接表达。\(\Sigma_f\) 半正定、\(\delta_i^2 > 0\) 时,整个二次型自然正定,不需要额外的 PSD 投影。约束互相矛盾时优化器会返回 infeasible,回测必须有降级策略(沿用上一日权重,或放松部分约束)。回测引擎如何在每个调仓日调用风险模型快照,见 回测引擎设计;同样的嵌入方式也用于 交易成本模型 第六节的成本项。
监控与告警
以下阈值是工程经验值,需要按自己的模型校准:
- 偏差统计量:标准化收益 \(f_{kt}/\sigma_{kt}\) 的滚动标准差长期偏离 1,说明波动预测有系统偏差(USE4 附录 A 用的就是这个统计量);
- 横截面 \(R^2\):突然大幅下降,通常是数据错误或市场结构突变;
- 特异波动分布:每日看分位数,分布漂移就告警;
- VaR 例外:滚动统计例外次数,用第六节的红绿灯分区;
- 因子协方差条件数:突然升高说明矩阵接近奇异,优化器会开始利用伪低风险方向。
九、谱系、争论与开放问题
谱系:今天的风险模型从哪里来
| 年份 | 工作 | 贡献 | 在本文中的位置 |
|---|---|---|---|
| 1967 | Marčenko & Pastur,Math. USSR-Sbornik | 随机矩阵特征值的极限谱 | 第二节:样本谱失真 |
| 1973 | Fama & MacBeth,JPE | 逐期横截面回归 + 斜率时序检验 | 第三节:横截面回归原型 |
| 1974 | Rosenberg,JFQA | 市场外协方差;载荷由公司特征决定 | 第三节:基本面因子模型 |
| 1986 | Connor & Korajczyk,JFE | 渐近主成分法 | 统计因子模型(Axioma 统计版用两步 APC) |
| 1987 | Newey & West,Econometrica | 半正定的 HAC 协方差 | 第二节:日频估计月度风险 |
| 1989 | Michaud,FAJ | 均值方差优化是”误差最大化” | 第二节 |
| 1999 | Laloux et al.,PRL | 经验相关矩阵的主体是噪声 | 第二节、争论二 |
| 1999 | Artzner et al.,Mathematical Finance | 一致性风险测度 | 第六节、争论三 |
| 2004 | Ledoit & Wolf,JMVA / JPM | 线性收缩估计 | 第二节 |
| 2010 | El Karoui,Annals of Statistics | 高维二次规划的风险低估 | 争论二 |
| 2011–2012 | Menchero, Orr & Wang(USE4 notes);Menchero, Wang & Orr,FAJ | eigenfactor 风险调整、波动率状态调整 | 第三、四节 |
| 2016 / 2019 | BCBS d352 / d457 | 以 97.5% ES 取代 99% VaR 作为内部模型核心度量 | 第六节 |
| 2017 / 2020 | Ledoit & Wolf,RFS / AoS;Bun, Bouchaud & Potters,Physics Reports | 非线性收缩、旋转不变估计 | 争论二、开放问题 |
演进的主线是:Rosenberg 和 Fama-MacBeth 定义了”暴露 × 因子收益 + 特异”的结构;随机矩阵理论和 Michaud 指出直接用样本协方差会被优化器利用;收缩估计和 eigenfactor 调整分别从统计学和厂商实践两条路去修正;VaR 的一致性缺陷推动了监管转向 ES。
争论一:基本面因子还是统计因子
基本面派。Connor(1995,Financial Analysts Journal)比较了宏观、统计、基本面三类因子模型对美股收益的解释力:统计模型和基本面模型都明显好于宏观模型,基本面模型还略好于统计模型。这有些反直觉,因为统计模型是按最大化解释力估计的;Connor 的解释是基本面模型用了大量外部数据,尤其是行业哑变量。他还发现,在基本面模型之上加入宏观因子,边际解释力为零。基本面模型的另一个优势是可解释:约束、归因、报告都要求因子有名字。
统计派。统计因子从收益本身提取,能捕捉到尚未命名的短期共同驱动(第四节残差检查里发现的那类结构),也不依赖财务数据的发布时滞。它的代价是可识别性:主成分的顺序和符号会随样本变化。Axioma 的 AXUS4 factsheet 专门说明它用一个专有算法”保持因子收益的顺序和符号随时间一致”,这正说明了这个问题在生产中真实存在。
模拟证据与边界。第二节的模拟里,统计 PCA-5 的预测/真实波动比为 0.845,已知真实暴露的基本面模型为 0.992。后者的暴露是真实的,所以这是基本面模型的理想上界;现实中两者的差距取决于基本面暴露的设定误差有多大。厂商的实际做法是两种都提供(Axioma 同时提供两类模型),用户按用途选择或对照。
争论二:高维协方差怎么”清洗”
几条路线的分歧在于优化目标:
- 特征值截断(clipping):Laloux et al.(1999)的思路,把落在 Marčenko-Pastur 噪声带内的特征值替换成平均值,保留噪声带外的信号特征值。
- 线性收缩:Ledoit & Wolf(2004)最小化 Frobenius 损失。第二节模拟里它把偏差比从 0.20 拉到 0.59,改善了但远未无偏,因为 Frobenius 损失并不等同于优化组合的风险偏差。
- 非线性收缩 / 旋转不变估计:Ledoit & Wolf(2017,2020)对每个特征值单独收缩,目标直接对准组合选择;Bun, Bouchaud & Potters(2017,Physics Reports)的综述系统整理了随机矩阵理论下的旋转不变估计(rotationally invariant estimator)。
- eigenfactor 调整:USE4 不追求整体矩阵最优,而是用蒙特卡洛估计每个特征因子的偏差,再按偏差缩放,评价标准是特征因子和优化组合的偏差统计量(Menchero, Wang & Orr 2012)。
理论上,El Karoui(2010,Annals of Statistics)证明了高维下由样本协方差求解的二次规划会系统性低估风险;Bouchaud & Potters 的综述给出了 \(R_{\text{in}} = R_{\text{out}}(1-q)\) 这一具体比例,并指出在多元 \(t\) 分布下低估会更严重。各方对”样本协方差在高维下低估最优组合风险”没有分歧,分歧在于哪种修正在非平稳、厚尾的真实数据上更稳。
争论三:ES 取代 VaR 之后怎么回测
ES 满足一致性(Artzner et al. 1999;Acerbi & Tasche 2002),但 Gneiting(2011,Journal of the American Statistical Association)证明了 ES 不具有可引出性(elicitability),即不存在一个评分函数使 ES 恰好是其期望损失的最小化者,而 VaR(分位数)具有可引出性。这一结果一度被解读为”ES 无法回测”。Acerbi & Székely(2014,Risk,MSCI 研究)反驳说,可引出性关系到模型比较,不是回测的必要条件,并给出了三种不依赖模型的 ES 回测方法;Fissler & Ziegel(2016,Annals of Statistics)证明了 VaR 与 ES 联合可引出。
监管的落地方式反映了这场争论的妥协:资本用 97.5% ES 计算(MAR33.2),回测仍然基于 VaR。银行整体层面按 250 个观测、99% VaR 的红绿灯分区(MAR32.9),交易台层面同时回测 97.5% 和 99% 两个水平的单日 VaR(MAR32.17)。
开放问题
- 特异收益相关的建模。行业切细能吸收多少跨股票相关,剩下的概念板块、产业链相关怎么在不引爆参数量的前提下进入模型?残差上叠加统计因子是一种做法,但它会和基本面因子的可解释性冲突。这个问题直接决定集中持仓和小盘组合的风险是否被低估。可读入口:Bun, Bouchaud & Potters(2017)综述中关于相关矩阵清洗的章节。
- 非平稳与厚尾下的偏差修正。eigenfactor 调整的模拟偏差假设正态、平稳,USE4 文档自己承认这样估出的偏差不够,需要经验缩放系数 \(a=1.4\);半衰期和 VRA 也都是启发式规则。能否有在 regime 切换下仍然有理论保证的修正,目前没有定论。可读入口:Menchero, Wang & Orr(2012);Ledoit & Wolf(2020)。
- 小样本下的 ES 回测功效。97.5% 水平下
1000 个观测只有 25 个尾部点(第六节输出中的
n_tail 25),250 个观测的 VaR 回测在 \(p=0.16\) 时就已进入黄区。ES 回测的统计功效、压力期窗口如何选取,都直接影响资本和限额。可读入口:Acerbi & Székely(2014);Fissler & Ziegel(2016)。
十、小结
- 维度是第一个问题。\(q = N/T\) 不可忽略时,样本协方差会让最小方差组合的预测风险只有真实风险的约 \(1-q\) 倍(模拟:0.199,理论:0.200)。因子模型把有效维度从 \(N\) 降到 \(K\)。
- 因子模型的结构有公开文档可查。国家 + 行业 + 风格 + 特异,平方根市值加权 WLS,行业市值加权和为零的约束,市值加权均值 / 等权标准差的标准化,这些都能在 USE4 和 CNE5 的方法论文档里逐条找到出处;Axioma 的基本面模型也采用了类似的结构。
- 协方差估计有三个关键选择:相关和波动用不同半衰期、Newey-West 修正、eigenfactor 调整加 VRA。相关与波动必须各用各的权重,否则矩阵不保证半正定。
- 归因要看主动部分。多头组合的总风险几乎都是国家因子;主动风险的分解才反映组合经理的选择。欧拉分解保证各项贡献相加闭合。
- 尾部要靠多种方法互相校验。历史模拟、参数法、Hull-White 在 regime 切换时的误差方向各不相同;监管已经用 97.5% ES 取代 99% VaR 作为资本度量,但回测仍然基于 VaR。
- 压力测试补的是分布之外的风险。反向压力测试的闭式解 \(\Delta f^* \propto \Sigma_f b\) 能直接说明”要亏 \(L^*\) 需要几个标准差”,可以用来检查假设情景库有没有缺口。
参考文献
规范与监管
- Basel Committee on Banking Supervision (2016). Minimum capital requirements for market risk, BCBS d352, January 2016. https://www.bis.org/bcbs/publ/d352.htm
- Basel Committee on Banking Supervision (2019). Minimum capital requirements for market risk, BCBS d457, January 2019(2019 年 2 月更正版). https://www.bis.org/bcbs/publ/d457.htm
- Basel Framework, MAR32 “Internal models approach: backtesting and P&L attribution test requirements”(32.9 表 1 红绿灯、32.14、32.17);MAR33 “Internal models approach: capital requirements calculation”(33.2 ES 97.5% 置信水平、33.3 至 33.4 流动性期限)。
厂商方法论文档
- Menchero, J., Orr, D. J., & Wang, J. (2011). The Barra US Equity Model (USE4) Methodology Notes. MSCI, August 2011.(第 2.3、2.5、3.1、4.1–4.3、5.1–5.3 节,表 4.1、5.1,附录 B)
- Orr, D. J., Mashtaler, I., & Nagy, A. (2012). The Barra China Equity Model (CNE5) Empirical Notes. MSCI, July 2012.(表 3.1 行业因子,第 3.3 节与附录 A 风格因子和描述子)
- Axioma (c. 2016). Axioma United States Equity Factor Risk Models (AXUS4) factsheet. https://cdn2.hubspot.net/hubfs/2174119/Return%20Downloads/Factsheet-AXUS4-1.pdf
- J.P. Morgan/Reuters (1996). RiskMetrics — Technical Document, 4th edition.
核心论文
- Rosenberg, B. (1974). “Extra-Market Components of Covariance in Security Returns.” Journal of Financial and Quantitative Analysis, 9(2), 263–274. doi:10.2307/2330104
- Fama, E. F., & MacBeth, J. D. (1973). “Risk, Return, and Equilibrium: Empirical Tests.” Journal of Political Economy, 81(3), 607–636. doi:10.1086/260061
- Ledoit, O., & Wolf, M. (2004). “A Well-Conditioned Estimator for Large-Dimensional Covariance Matrices.” Journal of Multivariate Analysis, 88(2), 365–411. doi:10.1016/S0047-259X(03)00096-4
- Laloux, L., Cizeau, P., Bouchaud, J.-P., & Potters, M. (1999). “Noise Dressing of Financial Correlation Matrices.” Physical Review Letters, 83(7), 1467–1470. doi:10.1103/PhysRevLett.83.1467
- Menchero, J., Wang, J., & Orr, D. J. (2012). “Improving Risk Forecasts for Optimized Portfolios.” Financial Analysts Journal, 68(3), 40–50. doi:10.2469/faj.v68.n3.5
- Artzner, P., Delbaen, F., Eber, J.-M., & Heath, D. (1999). “Coherent Measures of Risk.” Mathematical Finance, 9(3), 203–228. doi:10.1111/1467-9965.00068
- Newey, W. K., & West, K. D. (1987). “A Simple, Positive Semi-Definite, Heteroskedasticity and Autocorrelation Consistent Covariance Matrix.” Econometrica, 55(3), 703–708. doi:10.2307/1913610
- Gneiting, T. (2011). “Making and Evaluating Point Forecasts.” Journal of the American Statistical Association, 106(494), 746–762. doi:10.1198/jasa.2011.r10138
其他论文与书
- Marčenko, V. A., & Pastur, L. A. (1967). “Distribution of Eigenvalues for Some Sets of Random Matrices.” Mathematics of the USSR-Sbornik, 1(4), 457–483. doi:10.1070/SM1967v001n04ABEH001994
- Michaud, R. O. (1989). “The Markowitz Optimization Enigma: Is ‘Optimized’ Optimal?” Financial Analysts Journal, 45(1), 31–42. doi:10.2469/faj.v45.n1.31
- Ledoit, O., & Wolf, M. (2003). “Improved Estimation of the Covariance Matrix of Stock Returns with an Application to Portfolio Selection.” Journal of Empirical Finance, 10(5), 603–621. doi:10.1016/S0927-5398(03)00007-0
- Ledoit, O., & Wolf, M. (2004). “Honey, I Shrunk the Sample Covariance Matrix.” Journal of Portfolio Management, 30(4), 110–119. doi:10.3905/jpm.2004.110
- Ledoit, O., & Wolf, M. (2017). “Nonlinear Shrinkage of the Covariance Matrix for Portfolio Selection: Markowitz Meets Goldilocks.” Review of Financial Studies, 30(12), 4349–4388. doi:10.1093/rfs/hhx052
- Ledoit, O., & Wolf, M. (2020). “Analytical Nonlinear Shrinkage of Large-Dimensional Covariance Matrices.” Annals of Statistics, 48(5). doi:10.1214/19-AOS1921
- El Karoui, N. (2010). “High-Dimensionality Effects in the Markowitz Problem and Other Quadratic Programs with Linear Constraints: Risk Underestimation.” Annals of Statistics, 38(6). doi:10.1214/10-AOS795
- Bun, J., Bouchaud, J.-P., & Potters, M. (2017). “Cleaning Large Correlation Matrices: Tools from Random Matrix Theory.” Physics Reports, 666, 1–109. doi:10.1016/j.physrep.2016.10.005
- Bouchaud, J.-P., & Potters, M. (2009). “Financial Applications of Random Matrix Theory: A Short Review.” arXiv:0910.1205(预印本,未经同行评审;式 29)。
- Shepard, P. G. (2009). “Second Order Risk.” arXiv:0908.2455(预印本,未经同行评审;USE4 第 4.2 节引用)。
- Connor, G. (1995). “The Three Types of Factor Models: A Comparison of Their Explanatory Power.” Financial Analysts Journal, 51(3), 42–46. doi:10.2469/faj.v51.n3.1904
- Connor, G., & Korajczyk, R. A. (1986). “Performance Measurement with the Arbitrage Pricing Theory: A New Framework for Analysis.” Journal of Financial Economics, 15(3), 373–394. doi:10.1016/0304-405X(86)90027-9
- Heston, S. L., & Rouwenhorst, K. G. (1994). “Does Industrial Structure Explain the Benefits of International Diversification?” Journal of Financial Economics, 36(1), 3–27. doi:10.1016/0304-405X(94)90028-0
- Acerbi, C., & Tasche, D. (2002). “On the Coherence of Expected Shortfall.” Journal of Banking & Finance, 26(7), 1487–1503. doi:10.1016/S0378-4266(02)00283-2
- Acerbi, C., & Székely, B. (2014). “Backtesting Expected Shortfall.” Risk, December 2014(MSCI 研究)。
- Fissler, T., & Ziegel, J. F. (2016). “Higher Order Elicitability and Osband’s Principle.” Annals of Statistics, 44(4). doi:10.1214/16-AOS1439
- Kupiec, P. H. (1995). “Techniques for Verifying the Accuracy of Risk Measurement Models.” Journal of Derivatives, 3(2), 73–84. doi:10.3905/jod.1995.407942
- Christoffersen, P. F. (1998). “Evaluating Interval Forecasts.” International Economic Review, 39(4), 841–862. doi:10.2307/2527341
- Hull, J., & White, A. (1998). “Incorporating Volatility Updating into the Historical Simulation Method for Value-at-Risk.” Journal of Risk, 1(1), 5–19. doi:10.21314/JOR.1998.001
- Longin, F., & Solnik, B. (2001). “Extreme Correlation of International Equity Markets.” Journal of Finance, 56(2), 649–676. doi:10.1111/0022-1082.00340
- Ang, A., & Chen, J. (2002). “Asymmetric Correlations of Equity Portfolios.” Journal of Financial Economics, 63(3), 443–494. doi:10.1016/S0304-405X(02)00068-5
- Brinson, G. P., & Fachler, N. (1985). “Measuring Non-US Equity Portfolio Performance.” Journal of Portfolio Management, 11(3), 73–76. doi:10.3905/jpm.1985.409005
- Brinson, G. P., Hood, L. R., & Beebower, G. L. (1986). “Determinants of Portfolio Performance.” Financial Analysts Journal, 42(4), 39–44. doi:10.2469/faj.v42.n4.39
- Cariño, D. R. (1999). “Combining Attribution Effects Over Time.” Journal of Performance Measurement, 3(4), 5–14.
- Engle, R. F. (1982). “Autoregressive Conditional Heteroscedasticity with Estimates of the Variance of United Kingdom Inflation.” Econometrica, 50(4), 987–1007. doi:10.2307/1912773
- Bollerslev, T. (1986). “Generalized Autoregressive Conditional Heteroskedasticity.” Journal of Econometrics, 31(3), 307–327. doi:10.1016/0304-4076(86)90063-1
- Grinold, R. C., & Kahn, R. N. (1999). Active Portfolio Management, 2nd edition. McGraw-Hill.
实验与工具
risk_model_demo.py(本文同目录):正文全部代码与输出,python risk_model_demo.py复现。plot_risk_figures.py(本文同目录):生成images/eigen-spectrum-shrinkage.svg与images/risk-decomposition-stack.svg,python plot_risk_figures.py复现。- scikit-learn
sklearn.covariance.LedoitWolf(1.9.1):收缩目标为 \(\mu I\)。
系列导航
延伸阅读
- 因子动物园:价值、动量、质量、低波、规模:alpha 因子的构造与 Fama-MacBeth 检验,和本文的风险因子是同一回归的两种用法。
- 统计套利:协整、配对交易、PCA 残差:统计因子与残差的另一种用法。
- 头寸管理:Kelly、波动率目标、风险预算:拿到 \(\sigma_p\) 之后,杠杆和风险预算怎么定。
- 交易成本模型:冲击成本、滑点、Implementation Shortfall 与 TCA:流动性压力情景里的平仓成本。
- 回测陷阱:前视偏差、过拟合、数据窥视与 Deflated Sharpe:风险模型版本、point-in-time 与回测可信度。
- 运维与合规:监控、熔断、监管报送、复盘:风险指标如何接入熔断与报送。
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【量化交易】市场微结构:订单簿、价差、流动性、冲击
回测按中价成交,实盘却被价差、冲击和逆向选择吃掉收益。本文从限价订单簿出发拆解价差口径与分解、流动性四维、OFI、Kyle λ、VPIN 与 Hawkes,并用币安 LTCUSDT 真实数据验证:10 秒 OFI 解释约六成中价变化,有效价差三分之二以上表现为价格冲击。
【量化交易】交易成本模型:冲击成本、滑点、Implementation Shortfall 与 TCA
回测按收盘价成交,实盘却多付几十 bp。本文把交易成本拆成显性费用、滑点、冲击、机会成本四层,用平方根律标定、Almgren-Chriss 与 Implementation Shortfall 统一口径,附合成数据验证的 Python 代码和按 2026 年官方规则核对的四市场费率。
【量化交易】回测陷阱:前视偏差、过拟合、数据窥视与 Deflated Sharpe
回测 Sharpe 漂亮却上线失效,多半死于前视偏差、过拟合和数据窥视。本文给出前视偏差的三条机械自查规则,用可复现仿真说明零信号数据上挑出的最佳策略能通过 PSR 却被 DSR 拒掉,并附 Bonferroni、BH-FDR、DSR 的 Python 实现与 30 条上线前自检清单。
【量化交易】高频交易架构:低延迟、内核旁路、FPGA 概览
高频交易(HFT)的工程难点不在策略,而在「让一行代码以纳秒为单位稳定运行」。本文从延迟预算分解开始,依次走过 colocation 与微波链路、内核旁路(DPDK / Solarflare Onload / AF_XDP)、NUMA 与缓存调优、FPGA tick-to-trade、lock-free SPSC 队列、以及 Python 在这种系统中的合理边界。给出可运行的 numba 版 SPSC ring buffer 与 timeit 基准,用于演示热路径的设计思想。