数组长度为 \(n\),要在线交替执行”把 \(a_i\) 加上 \(d\)“和”求 \(a_l + \cdots + a_r\)“。前缀和数组查询 \(O(1)\) 但修改 \(O(n)\),原数组修改 \(O(1)\) 但查询 \(O(n)\);树状数组和线段树把两者都压到 \(O(\log n)\)。这两种结构的教程很多,常见的错误也不少:说懒标记的复杂度”要用势能法均摊”(实际上每次操作最坏就是 \(O(\log n)\));说线段树开 \(4n\) 是保守估计(递归写法实测需要 \(3.998n\));说树状数组”常数一定更小”(自底向上的线段树去掉分支后,在小规模上比它还快);还有把竞赛里的”线段树”和计算几何里的 segment tree 当成同一种结构。
本文按”代数前提 → 谱系 → 树状数组 → 线段树与懒标记 →
自底向上实现 → 实测”的顺序展开。文中的代码摘自同目录
reproduce/segfen.h,都经过
reproduce/test_segfen.c
对拍(和暴力数组逐次比较)以及 AddressSanitizer /
UndefinedBehaviorSanitizer 检查;所有访问次数和计时都来自
reproduce/bench_segfen.c(环境见第八节)。可持久化线段树放在下一篇。
一、问题与代数前提
操作接口
下文数组下标从 1 开始,操作记为:
- 点修改 \(\mathrm{add}(i, d)\):\(a_i \leftarrow a_i + d\);
- 区间修改 \(\mathrm{add}(l, r, d)\):对所有 \(l \le i \le r\),\(a_i \leftarrow a_i + d\);
- 区间查询 \(\mathrm{sum}(l, r) = \sum_{i=l}^{r} a_i\);前缀查询 \(\mathrm{prefix}(r) = \mathrm{sum}(1, r)\)。
| 结构 | 建立 | 点修改 | 区间修改 | 区间查询 | 额外空间 |
|---|---|---|---|---|---|
| 原数组 | \(O(n)\) | \(O(1)\) | \(O(n)\) | \(O(n)\) | \(0\) |
| 前缀和数组 | \(O(n)\) | \(O(n)\) | \(O(n)\) | \(O(1)\) | \(n\) |
| 树状数组 | \(O(n)\) | \(O(\log n)\) | \(O(\log n)\),需两棵 | \(O(\log n)\) | \(n\),区间修改 \(2n\) |
| 递归线段树 | \(O(n)\) | \(O(\log n)\) | \(O(\log n)\),需懒标记 | \(O(\log n)\) | \(< 4n\),懒标记再 \(< 4n\) |
| 自底向上线段树 | \(O(n)\) | \(O(\log n)\) | 需标记永久化等改写 | \(O(\log n)\) | \(2N\),\(N \ge n+2\) 为 2 的幂 |
表中都是最坏情况,没有均摊。
两种结构对运算的要求不同
把”求和”换成一般的二元运算 \(\oplus\),两种结构的适用范围就分开了:
- 线段树只要求 \(\oplus\) 满足结合律并有单位元,即幺半群(monoid)。区间 \([l, r]\) 被拆成若干个不相交的节点,按从左到右的顺序合并即可,因此 \(\max\)、\(\gcd\)、矩阵乘法都可以。
- 树状数组的前缀查询同样只需要幺半群;但区间查询依赖 \(\mathrm{sum}(l, r) = \mathrm{prefix}(r) - \mathrm{prefix}(l-1)\),要求每个元素有逆元,即群(group)。\(\max\) 没有逆元,所以树状数组不能直接做区间最大值;只做前缀最大值、并且值只增不减时仍然可用。
- 懒标记还要求更多:修改本身构成一个幺半群(可以复合),并且能直接作用在聚合值上而不必展开到叶子。区间加作用在区间和上是 \(s \mapsto s + d \cdot \mathrm{len}\),满足这个条件;第六节的”区间赋值加区间加”就是一个需要仔细定义复合顺序的例子。
二、名字与谱系
“segment tree”原本存的是区间
计算几何里的 segment tree 出自 Bentley 1977 年在卡内基梅隆大学的未发表笔记 Algorithms for Klee’s rectangle problems:沿 \(x\) 方向扫描矩形,在 \(y\) 方向上用 segment tree 维护当前被覆盖的区间,从而在 \(O(n \log n)\) 时间内求出矩形并的面积。Bentley 和 Wood 1980 年在 IEEE Transactions on Computers 上的矩形相交报告算法也以它为中间结构:插入、删除一条线段 \(O(\log n)\),查询时报告所有包含给定点的线段。
这种结构建立在端点坐标切出的”基本区间”上,每条线段被拆成 \(O(\log n)\) 个规范节点(canonical node),挂在节点上的是线段本身,查询是”哪些线段覆盖了点 \(x\)“。
竞赛和面试里说的”线段树”是另一回事:叶子是数组位置,每个节点存它管辖区间的聚合值(和、最大值),查询是”区间 \([l, r]\) 的聚合是多少”。两者共用”区间拆成 \(O(\log n)\) 个规范节点”这一骨架,但存储内容、支持的查询和空间都不同:Bentley 的结构总空间是 \(O(n \log n)\)(每条线段占 \(O(\log n)\) 个节点),聚合型线段树是 \(O(n)\)。读英文文献时遇到 segment tree,要先看它存的是区间还是聚合值。
树状数组:为算术编码维护累积频率
树状数组(Binary Indexed Tree,简称 BIT,也叫 Fenwick
tree)的最早出处是 Ryabko 1989 年的 A fast on-line
code(俄文版载于 Doklady Akademii Nauk SSSR
306(3),英译载于 Soviet Mathematics Doklady
39(3);Maple 的 FenwickTree
文档即把它列为首个出处,Fenwick 1994 列为其后的描述)。1992
年 Ryabko 又在 IEEE Transactions on Information
Theory 发表了 A fast on-line adaptive
code。
Fenwick 1994 年在 Software: Practice and Experience 发表 A new data structure for cumulative frequency tables,“binary indexed tree”这个名字出自这篇。按摘要,它要解决的是动态算术编码(dynamic arithmetic data compression)中累积频率的维护:把累积频率按下标的二进制表示分解,所有操作的访问时间是常数或与表长的对数成正比,并且特别适合大字母表。Fenwick 1996 年在同一期刊补了一篇改进”由频率找符号”操作的短文,Moffat 1999 年又在同一期刊提出了改进的累积概率表结构。第三节的”树上二分求第 \(k\) 小”,与算术解码时”由累积频率找符号”是同一个操作。
自底向上的线段树
竞赛圈把非递归、从叶子往上走的线段树称为 zkw 线段树,名字来自张昆玮的讲稿《统计的力量——线段树全接触》,这份讲稿在多个竞赛资料合集中流传,本文没有找到可核实的发表年份。第七节实现的是其中”叶子放在 \(N+i\)、用开区间 \((l-1, r+1)\) 往上爬”的写法。
下界:两种结构都已经最优
部分和问题(partial sums)在单元探测模型(cell-probe model)中有匹配的下界。Fredman 和 Saks(STOC 1989)证明了 \(\Omega(\log n / \log \log n)\);Pătraşcu 和 Demaine(SIAM Journal on Computing 35(4),2006)把它提高到每次操作均摊、随机化的 \(\Omega(\log n)\),并给出了按字长和单次更新幅度参数化的匹配上下界。这意味着在一般设定下,树状数组和线段树的 \(O(\log n)\) 在渐近意义上已经不能再改进,剩下能优化的只有常数:访问多少个单元、有没有分支、缓存行为如何。第八节测的就是这些。
三、树状数组:按 lowbit 切分前缀
lowbit
\(\mathrm{lowbit}(x)\) 是 \(x\) 的二进制表示中最低位的 1 所代表的值,例如 \(\mathrm{lowbit}(12) = \mathrm{lowbit}(1100_2) = 100_2 = 4\)。在补码下 \(-x = \lnot x + 1\):取反让最低位的 1 变成 0、它下面的 0 全变成 1,加 1 后进位恰好停在原来那一位。于是 \(x\) 与 \(-x\) 只在这一位上同为 1:
static inline int lowbit(int x) { return x & -x; }\(x\) 必须为正。\(\mathrm{lowbit}(0) = 0\),下面的点修改循环若从 \(i = 0\) 开始会原地打转、永不结束,这也是树状数组下标从 1 开始的原因。
每个节点管一段以自己结尾的区间
树状数组只有一个数组 \(c_1, \ldots, c_n\),其中
\[ c_i = \sum_{j = i - \mathrm{lowbit}(i) + 1}^{i} a_j , \]
即 \(c_i\) 管辖以 \(i\) 结尾、长度为 \(\mathrm{lowbit}(i)\) 的区间。
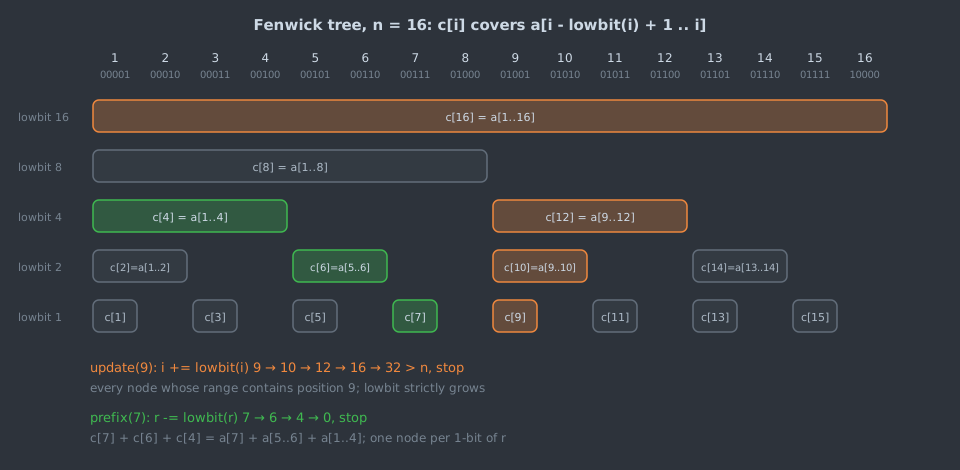
图中每一层是 lowbit 相同的节点,横条的长度等于 lowbit。两条路径都能从图上直接读出来:
- 前缀查询从 \(r\) 出发,每次 \(r \leftarrow r - \mathrm{lowbit}(r)\)。\(c_r\) 管辖 \((r - \mathrm{lowbit}(r), r]\),下一步的 \(c\) 管辖紧挨着它左边的一段,所以取到的区间首尾相接、不重不漏。每一步去掉 \(r\) 的最低位 1,循环次数等于 \(r\) 的二进制中 1 的个数,不超过 \(\lfloor \log_2 n \rfloor + 1\)。
- 点修改要更新所有管辖区间包含 \(i\) 的节点。节点 \(j\) 包含 \(i\) 当且仅当 \(j - \mathrm{lowbit}(j) < i \le j\)。从 \(i\) 出发,每次 \(i \leftarrow i + \mathrm{lowbit}(i)\):加上最低位的 1 会产生进位,新的最低位 1 严格更高,所以 lowbit 严格增大,最多 \(\lfloor \log_2 n \rfloor + 1\) 步。可以验证这条链上的节点恰好是所有包含 \(i\) 的节点,图中 9、10、12、16 就是例子。
/* reproduce/segfen.h */
static inline void fw_add(Fenwick *f, int i, ll d)
{
    for (; i <= f->n; i += lowbit(i)) f->c[i] += d;
}

static inline ll fw_prefix(const Fenwick *f, int r)
{
    ll s = 0;
    for (; r > 0; r -= lowbit(r)) s += f->c[r];
    return s;
}
(摘录删去了计数用的 touch++,下同。)\(n = 10^6\) 时对所有 \(i\) 穷举:点修改平均访问 10.10
个节点,最多 20 个(\(= \lfloor
\log_2 10^6 \rfloor + 1\));前缀查询平均 9.88
个,最多 19 个(不超过 \(10^6\) 的数最多有 19 个
1)。
\(O(n)\) 建树
逐个调用 \(\mathrm{add}\) 建树是 \(O(n \log n)\)。\(c_i\) 的父节点是 \(i + \mathrm{lowbit}(i)\),而 \(c_i\) 的所有子节点下标都小于 \(i\),所以按下标从小到大扫一遍,每个节点在自己算完后把值加给父节点,总共 \(n\) 次加法:
/* reproduce/segfen.h */
static inline void fw_build(Fenwick *f, const ll *a)
{
    for (int i = 1; i <= f->n; i++) f->c[i] = a[i];
    for (int i = 1; i <= f->n; i++) {
        int j = i + lowbit(i);
        if (j <= f->n) f->c[j] += f->c[i];
    }
}
对拍程序对每个测试规模都检查了它与 \(n\) 次 \(\mathrm{add}\) 的结果逐项相同。
树上二分:由累积值找位置
所有 \(a_i \ge 0\) 时,“最小的 \(i\) 使 \(\mathrm{prefix}(i) \ge k\)”不需要在外面套一层二分。从不超过 \(n\) 的最大 2 的幂开始,按位从高到低试探:若 \(c_{\mathrm{pos} + 2^j} < k\),说明答案在右边,把这一段吃掉。\(\mathrm{pos}\) 的低 \(j\) 位此时都是 0,所以 \(c_{\mathrm{pos}+2^j}\) 恰好管辖 \((\mathrm{pos}, \mathrm{pos}+2^j]\):
/* reproduce/segfen.h:返回最小的 i 使 prefix(i) >= k;不存在时返回 n+1 */
static inline int fw_lower_bound(const Fenwick *f, ll k)
{
    int pos = 0;
    int pw = 1;
    while (pw * 2 <= f->n) pw *= 2;
    for (; pw > 0; pw >>= 1) {
        if (pos + pw <= f->n && f->c[pos + pw] < k) {
            pos += pw;
            k -= f->c[pos];
        }
    }
    return pos + 1;
}
这正是 Fenwick 论文面向的场景:累积频率表里给定一个累积值,找到它落在哪个符号上。在值域上建树状数组、存每个值的出现次数,同样的函数就是”动态第 \(k\) 小”。
四、树状数组的区间修改
差分:区间加、单点查
设差分 \(d_j = a_j - a_{j-1}\)(\(a_0 = 0\)),则 \(a_x = \sum_{j \le x} d_j\)。区间 \([l, r]\) 加 \(v\) 只改动两个差分:\(d_l \mathrel{+}= v\),\(d_{r+1} \mathrel{-}= v\)。在 \(d\) 上建树状数组,区间加是两次点修改,单点查询是一次前缀查询。
两棵树:区间加、区间求和
对 \(a\) 求前缀和,交换求和次序:
\[ \sum_{i=1}^{x} a_i = \sum_{i=1}^{x} \sum_{j=1}^{i} d_j = \sum_{j=1}^{x} (x - j + 1)\, d_j = (x+1) \sum_{j=1}^{x} d_j - \sum_{j=1}^{x} j \, d_j . \]
右边是两个前缀和:一棵树状数组维护 \(d_j\),另一棵维护 \(j \cdot d_j\)。区间加 \(v\) 时,两棵树分别在 \(l\) 处加 \(v\)、\(l \cdot v\),在 \(r+1\) 处加 \(-v\)、\(-(r+1) \cdot v\):
/* reproduce/segfen.h */
static inline void rf_add_diff(RangeFenwick *r, int j, ll v)
{
    fw_add(&r->b1, j, v);
    fw_add(&r->b2, j, v * j);
}

static inline void rf_range_add(RangeFenwick *r, int l, int rr, ll v)
{
    rf_add_diff(r, l, v);
    if (rr + 1 <= r->b1.n) rf_add_diff(r, rr + 1, -v);
}

static inline ll rf_prefix(const RangeFenwick *r, int x)
{
    return (ll)(x + 1) * fw_prefix(&r->b1, x) - fw_prefix(&r->b2, x);
}溢出范围可以从公式直接读出:\(\sum_{j \le x} d_j = a_x\),所以 \((x+1) \cdot a_x\) 是中间结果里最大的一项,量级为 \(n \cdot \max_i |a_i|\),与前缀和本身同阶。用 64 位整数时只要 \(n \cdot \max|a_i|\) 远小于 \(2^{63}\) 就安全。
代价是每次区间加要改 4 条链、每次前缀查询要读 2 条链。\(n = 10^6\) 的随机区间上,区间加平均访问 40.37 个单元,区间查询平均 39.54 个(第八节)。
五、线段树:规范分解与空间
节点划分
递归线段树的根管辖 \([1, n]\);管辖 \([l, r]\)(\(l < r\))的节点取 \(m = l + \lfloor (r - l)/2 \rfloor\),左孩子管 \([l, m]\),右孩子管 \([m+1, r]\);叶子管单个位置。用堆式编号存储:根是 1,节点 \(p\) 的孩子是 \(2p\) 和 \(2p+1\),不存指针。
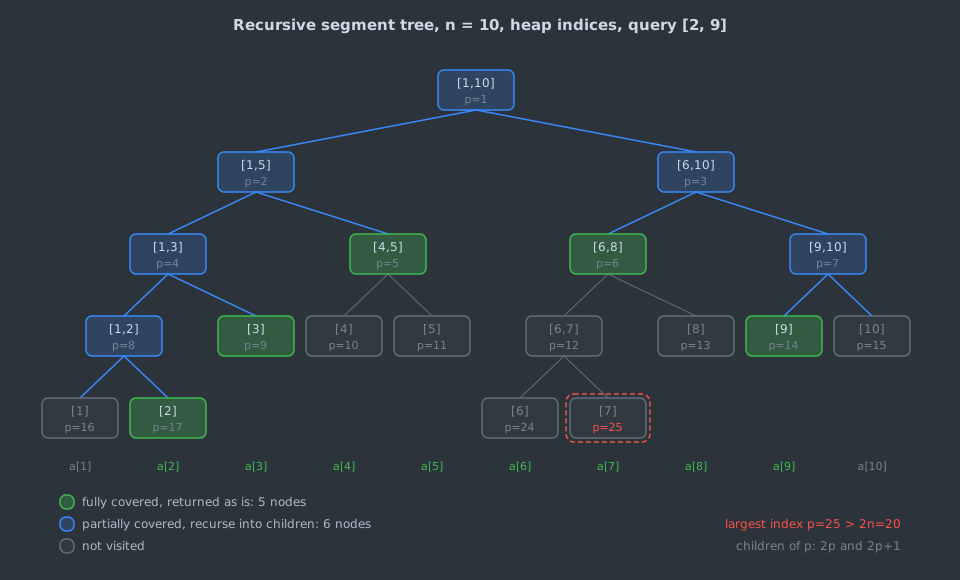
查询 \([2, 9]\) 从根开始递归:节点区间被查询完全包含就直接返回它的值(绿色,规范节点),部分重叠就往下走(蓝色),不相交就不进入。\([2, 9]\) 最终被拆成 \([2] \cup [3] \cup [4,5] \cup [6,8] \cup [9]\) 五段。
/* reproduce/segfen.h:无懒标记的区间求和 */
static inline ll seg_sum(const Seg *s, int p, int l, int r, int ql, int qr)
{
    if (ql <= l && r <= qr) return s->t[p];
    int m = l + (r - l) / 2;
    ll res = 0;
    if (ql <= m) res += seg_sum(s, 2 * p, l, m, ql, qr);
    if (qr > m) res += seg_sum(s, 2 * p + 1, m + 1, r, ql, qr);
    return res;
}
为什么每层最多访问 4 个节点
树高为 \(h = \lceil \log_2 n \rceil\)。同一层的节点两两不相交。一个节点被部分覆盖,说明它跨过了查询的某个端点:要么包含 \(q_l\) 且左端点小于 \(q_l\),要么包含 \(q_r\) 且右端点大于 \(q_r\)。同一层里包含 \(q_l\) 的节点只有一个,包含 \(q_r\) 的也只有一个,所以每层至多 2 个部分覆盖的节点。下一层被访问的节点都是这些节点的孩子,因此每层至多访问 4 个节点,其中至多 2 个成为规范节点。合起来,一次查询访问 \(O(4h)\) 个节点,区间被拆成至多 \(2h\) 段。
对 \(n = 1000\)(\(h = 10\))穷举全部 500,500 个区间:规范节点最多 17 个,访问节点最多 36 个,平均 23.95 个;\(n = 1024\) 时分别是 18、37、24.03。都在上面的界以内。
数组要开多大
叶子的深度不超过 \(h\),所以编号小于 \(2^{h+1}\)。由 \(2^{h-1} < n\) 得 \(2^{h+1} < 4n\),这就是”开 \(4n\)“的来源。这个界是紧的:
- 上图 \(n = 10\) 时最大编号是 25,已经超过 \(2n\)。原因是 \([6, 7]\) 这种长度为 2 的节点落在第 3 层,它的孩子在第 4 层,而第 4 层只用到了少数几个位置,编号却按满二叉树计算。
- 对 \(n \le 10^7\)
逐一计算最大编号(
bench_segfen count),比值最大为 \(3.9980\),出现在 \(n = 8{,}390{,}656 = 2^{23} + 2^{11}\) 时,最大编号 33,546,241。\(n = 10^6\) 时是 2,097,149,约 \(2.10n\)。
所以 \(2n\) 不够,\(4n\) 够用且几乎用满。如果想要 \(2n\) 以内的空间,可以换成第七节的自底向上布局,或者给节点按先序分配编号(左孩子是 \(p+1\)、右孩子是 \(p + 2(m - l + 1)\)),后者恰好用 \(2n - 1\) 个节点,本文没有实现。
六、懒标记:把区间修改推迟到必须时
不变量
区间加如果真的改到每个叶子,一次就是 \(O(n)\)。懒标记(lazy propagation)的做法是:修改遇到被完全覆盖的节点时,只更新这个节点的聚合值,并在节点上记一个标记”子树里每个元素都还欠 \(+v\)“,不再往下走。
要让它正确,只需维护一条不变量:
对每个节点 \(p\),把 \(p\) 的所有真祖先上的标记都作用到 \(p\) 之后,\(\mathrm{sum}[p]\) 等于 \(p\) 管辖区间的真实和;\(\mathrm{tag}[p]\) 是已经计入 \(\mathrm{sum}[p]\)、但还没有传给孩子的增量。
由此可以推出两条规则。第一,递归走到一个节点时,它的所有祖先都已经下推过,所以它自己的 \(\mathrm{sum}\) 是准确的,完全覆盖时可以直接返回。第二,要进入孩子之前,必须先把自己的标记推给孩子(push_down),否则孩子的 \(\mathrm{sum}\) 不准。
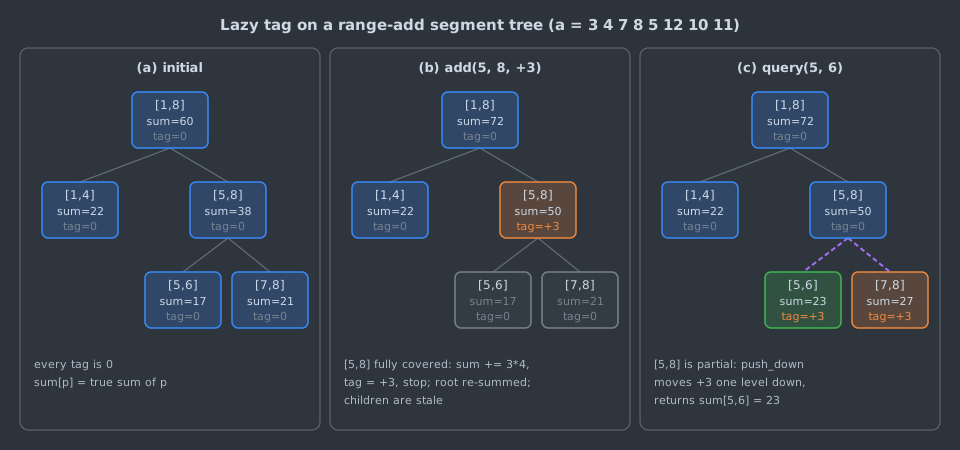
图 (b) 里 \([5,6]\) 和 \([7,8]\) 的 17、21 是”过期”的,但这不违反不变量:它们的祖先 \([5,8]\) 还带着 \(+3\),作用上去之后正是真实值。图 (c) 中查询需要进入 \([5,8]\) 的孩子,于是先下推:两个孩子的和各加上 \(3 \times 2\),标记移到它们身上;\([7,8]\) 这次没有被查询,它的标记继续挂着,等以后有操作需要进入它的孩子时再下推。
/* reproduce/segfen.h:区间加、区间求和 */
static inline void sa_apply(SegAdd *t, int p, int len, ll v)
{
    t->sum[p] += v * len;
    t->tag[p] += v;
}

static inline void sa_push(SegAdd *t, int p, int l, int r)
{
    if (t->tag[p]) {
        int m = l + (r - l) / 2;
        sa_apply(t, 2 * p, m - l + 1, t->tag[p]);
        sa_apply(t, 2 * p + 1, r - m, t->tag[p]);
        t->tag[p] = 0;
    }
}

static inline void sa_add(SegAdd *t, int p, int l, int r, int ql, int qr, ll v)
{
    if (ql <= l && r <= qr) { sa_apply(t, p, r - l + 1, v); return; }
    sa_push(t, p, l, r);
    int m = l + (r - l) / 2;
    if (ql <= m) sa_add(t, 2 * p, l, m, ql, qr, v);
    if (qr > m) sa_add(t, 2 * p + 1, m + 1, r, ql, qr, v);
    t->sum[p] = t->sum[2 * p] + t->sum[2 * p + 1];
}
查询 sa_sum 与第五节的 seg_sum
相同,只是在进入孩子前多一次 sa_push。
复杂度不需要均摊
区间修改访问的节点集合和区间查询完全一样(第五节的论证只依赖递归结构),下推只发生在部分覆盖的节点上,每次写两个孩子。所以每次修改或查询在最坏情况下就是 \(O(\log n)\),不需要势能法或均摊分析。区间赋值也一样,只要标记能在 \(O(1)\) 时间内复合、并直接作用到聚合值上。
\(n = 10^6\)、随机区间下,区间加平均访问 109.00 个节点,最多 139 个;区间求和平均 110.16 个,最多 140 个。这里的计数包括下推时写入的孩子,所以比无懒标记的查询(平均 53.85 个)高出一倍左右。
多种标记:复合顺序
同时支持区间赋值和区间加时,一个节点上的待办操作可以写成函数
\[ f(x) = \begin{cases} c + d, & \text{有赋值标记 } c \\ x + d, & \text{无赋值标记} \end{cases} \]
即”先赋值(如果有),再加 \(d\)“。新操作 \(g\) 到来时要算复合 \(g \circ f\):若 \(g\) 是赋值,它覆盖掉之前的一切,赋值标记改为新值、加法标记清零;若 \(g\) 是加 \(d'\),只把 \(d\) 改成 \(d + d'\)。下推时也必须按”先赋值、后加法”的顺序作用到孩子上。
对拍程序把三种典型写错的版本各跑一遍(修改
segfen.h
的临时副本):赋值时不清零加法标记,失败 57,285
次;下推时先加法后赋值,失败 40,830 次;查询前漏掉
push_down,失败 61,612
次。三种错误在小数组的手工样例上都很容易碰巧通过,所以懒标记的代码一定要和暴力实现对拍。
七、自底向上:zkw 线段树
布局
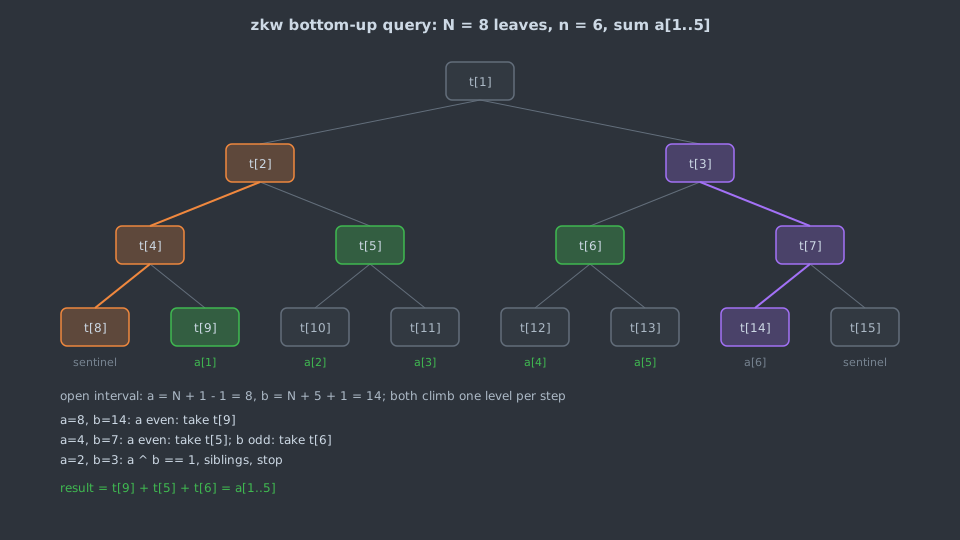
取 \(N\) 为不小于 \(n + 2\) 的最小 2 的幂,位置 \(i\) 的叶子放在 \(N + i\),节点 \(p\) 的父亲是 \(\lfloor p/2 \rfloor\)。位置 0 和 \(n+1\) 是哨兵,值为 0,让开区间的两个端点总是存在。建树从 \(N - 1\) 倒着算到 1,点修改从叶子一路加到根,恰好 \(\log_2 N + 1\) 次,没有递归,也没有依赖数据的分支。\(n = 10^6\) 时 \(N = 2^{20}\),点修改固定访问 21 个单元。
开区间往上爬
查询 \([l, r]\) 时,把指针放在开区间的两端:\(a = N + l - 1\),\(b = N + r + 1\)。两个指针每轮同时上升一层,直到成为兄弟(\(a \oplus b = 1\),这里 \(\oplus\) 指按位异或):
- \(a\) 是左孩子(偶数)时,它的右兄弟 \(a \oplus 1\) 整个落在开区间内部,加上;
- \(b\) 是右孩子(奇数)时,它的左兄弟 \(b \oplus 1\) 同理。
/* reproduce/segfen.h */
static inline ll zkw_sum(const Zkw *z, int l, int r)
{
    ll s = 0;
    for (int a = z->N + l - 1, b = z->N + r + 1; (a ^ b) != 1; a >>= 1, b >>= 1) {
        if (!(a & 1)) s += z->t[a ^ 1]; /* a is a left child: take its right sibling */
        if (b & 1) s += z->t[b ^ 1];    /* b is a right child: take its left sibling */
    }
    return s;
}
两点说明:
- 这段代码把左右两侧取到的节点加进同一个累加器,顺序是交错的,所以要求运算满足交换律。对矩阵乘法这类不可交换的运算,要分别维护左累加器(新节点从右边乘上去)和右累加器(新节点从左边乘上去),最后再合并。
- 区间修改在自底向上布局里通常用”标记永久化”:标记留在节点上不下推,查询沿路径把经过节点的标记累加进来。这种写法需要为每个节点记住它管辖的区间长度,本文没有实现和测试。
八、实测:访问次数与绑核计时
环境与口径
- CPU:Intel Core i9-12900K;WSL2,内核 6.6.87.2-microsoft-standard-WSL2;GCC 16.1.1。
- 编译运行:
cd reproduce
gcc -O2 -Wall -Wextra -o test_segfen test_segfen.c && ./test_segfen
gcc -O1 -g -fsanitize=address,undefined -fno-sanitize-recover=all -o test_san test_segfen.c && ./test_san
gcc -O2 -Wall -Wextra -o bench_segfen bench_segfen.c
./bench_segfen count
taskset -c 14 ./bench_segfen time 4096 5
taskset -c 14 ./bench_segfen time 1000000 5- 对拍:\(n = 1, \ldots,
300\) 每个规模 400 次随机操作,另加 \(n \in \{1000, 1023, 1024, 1025, 4097,
65537\}\) 各 3000
次,覆盖本文全部结构;
-O2版本和 ASan/UBSan 版本都输出306 sizes tested, 0 failures。 - 访问次数与时钟无关:每读或写一个树节点计 1 次,递归线段树每进入一个节点计 1 次。随机区间由固定种子的 splitmix64 生成,连续两次运行输出逐字节一致。
- 计时:机器上同时有其他任务,因此绑定到 CPU 14,每种操作连续执行 \(2 \times 10^6\) 次取单次平均,重复 5 次取中位数。计时只用来看相对趋势。
原始输出保存在 reproduce/results/。
访问次数
\(n = 10^6\),\(10^6\) 个随机区间(种子 42):
| 操作 | 结构 | 平均访问 | 最多访问 |
|---|---|---|---|
| 点修改 | 树状数组(穷举全部 \(i\)) | 10.10 | 20 |
| 点修改 | zkw | 21 | 21 |
| 点修改 | 递归线段树 | 至多 21 | 21 |
| 区间求和 | 树状数组(两次前缀查询) | 19.77 | 34 |
| 区间求和 | zkw | 17.85 | 33 |
| 区间求和 | 递归线段树 | 53.85 | 72 |
| 区间加 | 两棵树状数组 | 40.37 | 68 |
| 区间加 | 懒标记线段树 | 109.00 | 139 |
| 区间求和(区间加之后) | 两棵树状数组 | 39.54 | 68 |
| 区间求和(区间加之后) | 懒标记线段树 | 110.16 | 140 |
zkw 只访问真正被取用的节点,比两次前缀查询还少;递归线段树要访问所有部分覆盖的节点,而那些节点本身并不贡献结果,因此访问次数约为 zkw 的 3 倍。
计时
单位为 ns/次,中位数(5 次),绑定 CPU 14:
| 操作 | 结构 | \(n = 4096\) | \(n = 10^6\) |
|---|---|---|---|
| 点修改 | 树状数组 | 10.1 | 30.9 |
| 点修改 | 递归线段树 | 46.2 | 113.7 |
| 点修改 | zkw | 4.3 | 31.7 |
| 区间求和 | 树状数组 | 14.6 | 38.8 |
| 区间求和 | 递归线段树 | 100.5 | 298.2 |
| 区间求和 | zkw | 56.0 | 112.3 |
| 区间求和 | zkw 无分支版 | 12.0 | 136.7 |
| 区间加 | 两棵树状数组 | 27.3 | 145.5 |
| 区间加 | 懒标记线段树 | 174.6 | 661.0 |
| 区间求和(区间加之后) | 两棵树状数组 | 18.8 | 98.6 |
| 区间求和(区间加之后) | 懒标记线段树 | 110.7 | 372.9 |
\(n = 10^6\)
时又跑了一次 9
轮(results/time_1e6_r9.txt),机器负载更高,各项绝对值高出
20% 到
50%,最大、最小值相差也更大,但各结构的先后顺序与上表相同。点修改上树状数组与
zkw 在上表中只差 0.8 ns,在 9 轮那次差 14
ns,两者的差距不稳定,不能据此分出高下。
三点观察:
- 访问次数少不等于快。 zkw
区间求和访问的节点比树状数组少(上一张表,\(n = 10^6\)),但 \(n = 4096\) 时却慢了近 4
倍(56.0 对 14.6 ns)。zkw
每层有两个取决于数据的分支,随机区间下难以预测。把这两个分支改成掩码(
zkw_sum_branchless,每层无条件读两个兄弟,再用掩码决定是否计入)之后降到 12.0 ns,比树状数组还快。这说明小规模时 zkw 的瓶颈是分支预测失败。这个结论来自改写前后的对比,没有用硬件性能计数器直接测。 - 规模变大后,内存访问占主导。 \(n = 10^6\) 时无分支版反而更慢(136.7 对 112.3 ns),而且波动很大。它每层都读两个节点,不管用不用得到;有分支的版本只读需要的那个。数据放不进 L2 以后,多读的那些节点变成了实际的缓存未命中。
- 递归线段树在同类操作上比树状数组慢 3.7 到 7.7 倍,懒标记线段树比两棵树状数组慢 3.8 到 6.4 倍。 函数调用、多出一倍以上的节点访问、下推时的写入,三者叠加。只做区间加和区间求和时,两棵树状数组在两个规模上都更快。
九、选型与扩展
| 需求 | 选择 | 理由 |
|---|---|---|
| 点修改 + 区间求和(可逆运算) | 树状数组 | 代码最短,本文两个规模下都最快或接近最快 |
| 区间加 + 区间求和 | 两棵树状数组 | 第四节推导;本文测得比懒标记线段树快 3.8 到 6.4 倍(第八节) |
| 区间最值、\(\gcd\) 等不可逆运算 | 线段树 | 树状数组的区间查询依赖逆元 |
| 区间赋值,或多种修改混合 | 懒标记线段树 | 需要定义标记复合(第六节) |
| 只读查询很多,且对延迟敏感 | zkw,小规模时用无分支版 | 第八节:规模小时分支预测是瓶颈 |
| 按累积值找位置(第 \(k\) 小、算术解码) | 树状数组树上二分 | 第三节,\(O(\log n)\),不需要外层二分 |
| 查询历史版本 | 可持久化线段树 | 路径复制,见下一篇 |
几个本文没有展开的扩展:
- 多维:树状数组嵌套一层即可做二维点修改、矩形求和,复杂度 \(O(\log^2 n)\);两棵树状数组的区间修改技巧在二维需要四棵。
- 归并排序树:每个线段树节点存区间内元素排好序的副本,空间 \(O(n \log n)\),统计”\([l, r]\) 中不超过 \(x\) 的元素个数”时,在 \(O(\log n)\) 个规范节点上各做一次二分,共 \(O(\log^2 n)\);用 Chazelle 和 Guibas(Algorithmica 1986)的分散层叠(fractional cascading)可以省掉每个节点上的二分,降到 \(O(\log n)\)。
- 区间存储型 segment tree:第二节所说的 Bentley 结构,用于扫描线求矩形并面积、矩形相交报告,节点上挂的是线段列表或覆盖计数。
十、争论与开放问题
术语:segment tree 指哪一种结构
计算几何文献(Bentley 1977;Bentley 和 Wood 1980)里的 segment tree 存线段、回答”哪些线段包含点 \(x\)“,空间 \(O(n \log n)\)。竞赛资料里的线段树存聚合值、回答区间聚合,空间 \(O(n)\)。两种说法今天都在用:计算几何教材沿用前者,竞赛资料沿用后者,前者做的”扫描线加覆盖计数”又是后者的经典应用,所以混用很常见。本文的做法是只把 Bentley 的结构叫”区间存储型”,其余都指聚合型。
“树状数组常数更小”是否成立
第八节的数据既支持也反驳这句话:递归线段树确实比树状数组慢 3.7 到 7.7 倍,但 zkw 无分支版在 \(n = 4096\) 时比树状数组快,\(n = 10^6\) 时又被反超。常数取决于实现方式(递归还是迭代、有没有依赖数据的分支)和数据规模(能否放进缓存),不取决于”树状数组”还是”线段树”这个名字。本文的测量只覆盖一台机器、两个规模和均匀随机的区间,换成有局部性的查询序列,结论可能不同。
开放问题
- 下界在什么条件下能突破。 Pătraşcu 和 Demaine 的 \(\Omega(\log n)\) 下界针对的是一般字长和一般更新幅度;他们在同一篇论文中给出了按字长与更新幅度参数化、上下界匹配的结果。这些参数化的结构在实践中是否比树状数组快,本文没有找到实测对比。
- 大规模下的内存布局。 树状数组在 \(n\) 很大时,前缀查询依次访问 \(r\)、\(r - \mathrm{lowbit}(r)\)……下标间隔是 2 的幂;线段树的堆式布局在深层也是跨度越来越大的访问。改用缓存友好的布局能否在这两种结构上带来稳定收益,以及收益随规模怎样变化,第八节的两个规模不足以回答。
十一、参考资料
核心论文
- B. Ya. Ryabko, “A fast on-line code”, Doklady Akademii Nauk SSSR 306(3):548–552, 1989;英译 Soviet Mathematics Doklady 39(3):533–537。
- B. Ya. Ryabko, “A fast on-line adaptive code”, IEEE Transactions on Information Theory 38(4):1400–1404, 1992.
- P. M. Fenwick, “A new data structure for cumulative frequency tables”, Software: Practice and Experience 24(3):327–336, 1994.
- J. L. Bentley, “Algorithms for Klee’s rectangle problems”, unpublished notes, Computer Science Department, Carnegie Mellon University, 1977.
- J. L. Bentley, D. Wood, “An optimal worst case algorithm for reporting intersections of rectangles”, IEEE Transactions on Computers C-29(7):571–577, 1980.
- M. L. Fredman, M. E. Saks, “The cell probe complexity of dynamic data structures”, STOC 1989, pp. 345–354.
- M. Pătraşcu, E. D. Demaine, “Logarithmic lower bounds in the cell-probe model”, SIAM Journal on Computing 35(4):932–963, 2006.
其他论文
- P. M. Fenwick, “A new data structure for cumulative probability tables: an improved frequency-to-symbol algorithm”, Software: Practice and Experience 26(4):489–490, 1996.
- A. Moffat, “An improved data structure for cumulative probability tables”, Software: Practice and Experience 29(7):647–659, 1999.
- B. Chazelle, L. J. Guibas, “Fractional cascading: I. A data structuring technique”, Algorithmica 1:133–162, 1986;“II. Applications”, Algorithmica 1:163–191, 1986.
工程资料
- 张昆玮,《统计的力量——线段树全接触》,竞赛讲稿(收录于多个竞赛资料合集,发表年份未核实)。
- J. Erickson, “Klee’s Measure Problem”,UIUC 开放问题页面,对 Bentley 扫描线算法的说明。
- Maplesoft, Maple 帮助文档
FenwickTree,参考文献部分列出 Ryabko 1989 与 Fenwick 1994。
实验
reproduce/segfen.h:本文全部结构的实现。reproduce/test_segfen.c:与暴力数组对拍,含 ASan/UBSan 构建命令。reproduce/bench_segfen.c:第五、八节的访问次数、堆式编号上界和计时;结果在reproduce/results/。reproduce/draw_figures.py:生成本文四张 SVG。
系列导航: - 上一篇:Treap 与跳表 - 下一篇:持久化数据结构
相关阅读: - 无分支编程与分支预测失败的代价 - 缓存无关算法与 van Emde Boas 布局
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
扫描线算法:从线段交到矩形面积并
扫描线是计算几何中最通用的算法范式——用一条虚拟的线从左到右扫过平面,将二维问题降维为一维动态问题。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。
基数排序:绕开比较下界的代价,从 LSD、American flag sort 到 ska_sort
比较下界只约束比较模型,基数排序把代价转移到键长和内存访问上。本文推导代价模型,用缓存模拟与绑核实测解释位宽为何停在 8 到 11 位,并对照 ska_sort、ClickHouse、DuckDB 与 IPS²Ra 说明它何时赢、何时输。