Merkle 树(Merkle tree)要解决的问题是:数据存放在不可信的一方,验证者手里只有一个可信的短哈希(根),不可信方怎样逐条证明”这条数据在集合里”“这个集合只追加过、没有被改写”。常见的描述是”把哈希两两拼接,一路哈希到根”。这句话省掉的细节恰好都出过事:Bitcoin 在奇数层复制最后一个哈希,使两个不同的交易列表得到同一个根(CVE-2012-2459);叶子和内部节点用同一种哈希,使 64 字节的”叶子”可以冒充内部节点,Bitcoin 为此在 2025 年提出了软分叉提案 BIP 54。另一个常见误解是”分支越多,树越矮,证明越短”:哈希树的证明要带上每层的全部兄弟,本文第六节的实测里,16 叉 trie 的证明约是二叉的 3.5 倍。
本文以 RFC 9162(Certificate Transparency 第 2
版)为规范文本。第二到四节给出树哈希、包含证明和一致性证明的定义、验证算法和逐步推演,实现在
reproduce/merkle.c,用 transparency-dev/merkle
的测试向量和 RFC 自带的 7
叶例子校验。第五节复现两类构造缺陷。第六节讨论键值映射(稀疏
Merkle 树、以太坊
MPT),并实测分支数对证明大小的影响。第七节说明 Git 为什么是
Merkle DAG 而不是 Merkle 树。第八、九节讨论 Verkle
树与二叉状态树之争,以及 CT 的 split view 等未解决问题。基于
Merkle 树的签名(XMSS、SPHINCS+)不在本文范围内,见 哈希基签名:从
Lamport 到 SPHINCS+。
一、认证数据结构:模型与谱系
三方模型
Tamassia 在 ESA 2003 的特邀报告中,把认证数据结构(authenticated data structure,ADS)归结为三方模型:
- 数据源(source)可信,维护数据集,发布签名过的摘要;
- 应答方(responder,也叫 directory)不可信,保存数据副本并回答查询,每个回答附带一份证明;
- 用户(user)只信任数据源的签名,用摘要和证明检查回答。
好的 ADS 要同时让三个量都小:证明大小、验证时间、数据源更新摘要的代价。Merkle 树在静态列表上三者都是 \(O(\log n)\)。
安全性归约到哈希函数的抗碰撞性(collision resistance)。设验证者从叶子 \(x\) 出发,按证明逐层计算 \(v_0 = \mathrm{H}_{\text{leaf}}(x), v_{i+1} = \mathrm{H}_{\text{node}}(\cdot)\),最终得到可信根 \(r\)。如果应答方为一个不在集合中的 \(x' \ne x\) 也给出了能通过验证的证明,那么诚实路径与伪造路径在根处汇合、在叶子处不同,自下而上必有第一个位置,两个不同的哈希输入得到相同输出,也就是找到了一次碰撞。这个论证有两个隐含前提:同一个值不能既被解释成叶子又被解释成内部节点,树的形状(叶子数、位置)由验证者可信地掌握。第五节的两类缺陷恰好各破坏了一个前提。
谱系
flowchart LR
  subgraph found["Foundations"]
    M79["Merkle 1979<br/>tree authentication<br/>thesis + patent"]
    M89["Merkle CRYPTO 87 / 89"]
  end
  subgraph ads["Authenticated data structures"]
    NN98["Naor-Nissim 1998<br/>authenticated 2-3 tree"]
    T03["Tamassia 2003<br/>three-party model"]
    MH14["Miller et al. 2014<br/>ADS generically"]
  end
  subgraph logs["Append-only logs"]
    CW09["Crosby-Wallach 2009<br/>history tree"]
    CT13["RFC 6962, 2013"]
    CT21["RFC 9162, 2021"]
  end
  subgraph maps["Key-value maps"]
    SMT["Laurie-Kasper 2012<br/>sparse Merkle tree"]
    D16["Dahlberg et al. 2016"]
    MPT["Ethereum MPT"]
    VK["Kuszmaul 2018<br/>Verkle tree"]
    E68["EIP-6800, 2023"]
    E78["EIP-7864, 2025<br/>binary tree"]
  end
  BTC["Bitcoin 2008<br/>SPV"]
  M79 --> M89
  M89 --> NN98 --> T03 --> MH14
  M89 --> CW09 --> CT13 --> CT21
  M89 --> BTC
  CT13 --> SMT --> D16
  MPT --> E68
VK --> E68 --> E78Merkle(1979)。Ralph Merkle 1979 年 6 月在斯坦福大学完成博士论文《Secrecy, Authentication, and Public Key Systems》,其中第五章”认证数字签名”按他的说法构思于 1977 年夏。同年 9 月 5 日,斯坦福为这项工作申请了美国专利 US 4,309,569(1982 年 1 月 5 日授权),专利把方法称为”树认证”(tree authentication):一次性签名方案每个公钥 \(Y_i\) 只能用一次,用一棵树把 \(Y_1,\dots,Y_n\) 汇总成一个根 \(R\),只需可信地发布 \(R\)。专利里的定义是
\[ H(i,i,Y) = F(Y_i), \qquad H(i,j,Y) = F\bigl(H(i,\tfrac{i+j-1}{2},Y),\ H(\tfrac{i+j+1}{2},j,Y)\bigr), \]
按区间中点二分,叶子和内部节点用同一个单向函数 \(F\),输出取 100 位。论文形式的发表是 CRYPTO ’87 的 “A Digital Signature Based on a Conventional Encryption Function” 和 CRYPTO ’89 的 “A Certified Digital Signature”;后者的副标题就是 “That Antique Paper from 1979”。
认证字典(1998–2014)。Naor 与 Nissim(USENIX Security 1998)用哈希化的 2-3 树维护已吊销证书序列号的有序集合,把 Merkle 树从静态列表推广到支持插入删除、并能证明”不在集合中”的动态字典。Tamassia(2003)给出了上面的三方模型。Miller、Hicks、Katz、Shi(POPL 2014)走得更远:在语言层面加一个”已认证”类型标注,编译器自动为任意数据结构生成证明代码。
只追加日志(2009–2021)。Crosby 与
Wallach(USENIX Security 2009)提出历史树(history
tree),要求日志服务器能给出两类证明:成员证明(某事件在日志中)和增量证明(新版本是旧版本的扩展),两者都是对数大小。摘要里的例子是
8000 万条事件的日志:哈希链证明一条事件需要约 800 MB
数据,他们的原型只需约 3 KB。2011 年 8 月 28 日,荷兰 CA
DigiNotar 误签的 google.com
通配符证书被用于在伊朗实施中间人攻击(Laurie,ACM Queue
2014),Google 的 Laurie、Langley、Kasper
随后把只追加日志用于证书,2013 年发布 RFC 6962。2021 年的
RFC 9162 取代了它,并在 2.1.1 节注明,其树”本质上与
Crosby–Wallach 的历史树相同,只是对非满树的处理不同”。
键值映射(2012 至今)。Laurie 与 Kasper 2012 年在吊销透明(Revocation Transparency)提案中提出稀疏 Merkle 树(sparse Merkle tree),Dahlberg、Pulls、Peeters(NordSec 2016)给出了完整的递归定义与缓存策略。以太坊用 Merkle Patricia Trie 承诺全局状态;Kuszmaul(MIT PRIMES 2018)提出用向量承诺替代哈希的 Verkle 树;以太坊社区先后提出 EIP-6800(Verkle)与 EIP-7864(二叉哈希树)两种替换方案,第八节展开。
二、RFC 9162 的树哈希
定义
RFC 9162 第 2.1.1 节对有序输入列表 \(D_n = \{d_0, \dots, d_{n-1}\}\) 定义 Merkle 树哈希(Merkle Tree Hash,MTH):
\[ \mathrm{MTH}(\{\}) = \mathrm{HASH}(), \qquad \mathrm{MTH}(\{d_0\}) = \mathrm{HASH}(\mathtt{0x00} \,\|\, d_0), \]
\[ \mathrm{MTH}(D_n) = \mathrm{HASH}\bigl(\mathtt{0x01} \,\|\, \mathrm{MTH}(D[0{:}k]) \,\|\, \mathrm{MTH}(D[k{:}n])\bigr), \qquad k < n \le 2k,\ k = 2^t, \]
其中 \(k\) 是小于 \(n\) 的最大 2 的幂,\(\|\) 是字节拼接,\(D[a{:}b]\) 是下标 \(a\) 到 \(b-1\) 的子列表。RFC 6962 第 2.1 节的定义与此逐字相同(哈希固定为 SHA-256),所以本文所有证明对两版都适用。
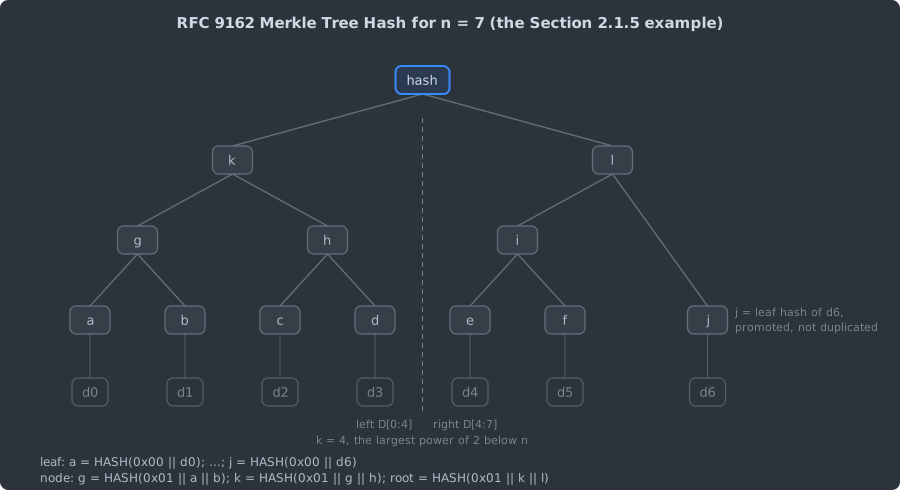
这个定义有三个后果:
- 树形只由 \(n\) 决定。左子树总是恰好 \(k\) 个叶子的满二叉树,所有”不齐”都集中在右边界上。图中 \(n=7\),\(k=4\),右边 3 个叶子再按 \(k=2\) 切分,最后剩下的 \(d_6\) 单独成为子树,它的叶哈希 \(j\) 直接挂到 \(l\) 下面,不补零、不复制。
- 叶子和内部节点哈希的输入空间不相交。叶子输入以
0x00开头,内部节点以0x01开头,RFC 原文说这一域分离(domain separation)“is required to give second preimage resistance”。第五节会演示去掉前缀后的后果。 - 可以流式计算。第 2.1.2
节给出一个栈算法:第 \(i\)
个叶哈希入栈后,合并次数等于 \(i\) 的二进制末尾连续 1
的个数,全部入栈后再从栈顶两两合并到只剩一个元素。栈深不超过
\(\lceil \log_2 n \rceil +
1\),日志服务器不必把整棵树放在内存里。
reproduce/merkle.c对 \(n = 1,\dots,1000\) 检查了栈算法与递归定义的结果相同。
实现与校验
下面是 reproduce/merkle.c
中与定义一一对应的部分(删去了哈希上下文的管理代码):
/* largest power of two strictly smaller than n (n >= 2) */
static size_t split_point(size_t n)
{
    size_t k = 1;
    while (k << 1 < n) k <<= 1;
    return k;
}

static hash_t mth(const entry_t *d, size_t n)
{
    if (n == 0) { hash_t h; sha256_parts(NULL, NULL, 0, &h); return h; }
    if (n == 1) return leaf_hash(&d[0]);          /* SHA-256(0x00 || d) */
    size_t k = split_point(n);
    hash_t l = mth(d, k), r = mth(d + k, n - k);
    return node_hash(&l, &r);                     /* SHA-256(0x01 || l || r) */
}
校验用了两组外部数据:
- transparency-dev/merkle v0.0.2(CT 风格 Merkle 树的 Go
实现)
testonly/constants.go中的 8 个叶子输入与大小 0 到 8 的全部根哈希,以及proof/verify_test.go中的 4 个包含证明和 4 个一致性证明,逐字节一致; - RFC 9162 第 2.1.5 节的 7 叶例子:程序按图中的名字 a 到 l
自行计算每个节点,检查 RFC 列出的 4 个包含证明和 3
个一致性证明都由这些节点按所列顺序组成。用上述 8
个测试输入的前 7 个,7 叶树的根是
ddb89be403809e325750d3d263cd78929c2942b7942a34b77e122c9594a74c8c,与 transparency-dev 的向量相同。
编译运行:
cd reproduce
gcc -O2 -Wall -Wextra -std=c11 -o merkle merkle.c -lcrypto
./merkle
程序也在 -fsanitize=address,undefined
下跑过,没有报告。完整输出在
reproduce/results/merkle.txt。
三、包含证明
定义
叶子 \(d_m\)(\(0 \le m < n\))的包含证明(inclusion proof,RFC 6962 叫 audit path)按第 2.1.3.1 节递归定义:
\[ \mathrm{PATH}(m, D_n) = \begin{cases} \mathrm{PATH}(m, D[0{:}k]) : \mathrm{MTH}(D[k{:}n]) & m < k, \\ \mathrm{PATH}(m-k, D[k{:}n]) : \mathrm{MTH}(D[0{:}k]) & m \ge k, \end{cases} \qquad \mathrm{PATH}(0, \{d_0\}) = \{\}, \]
其中 \(:\) 表示列表拼接。证明按自底向上的顺序列出路径上每个节点的兄弟。
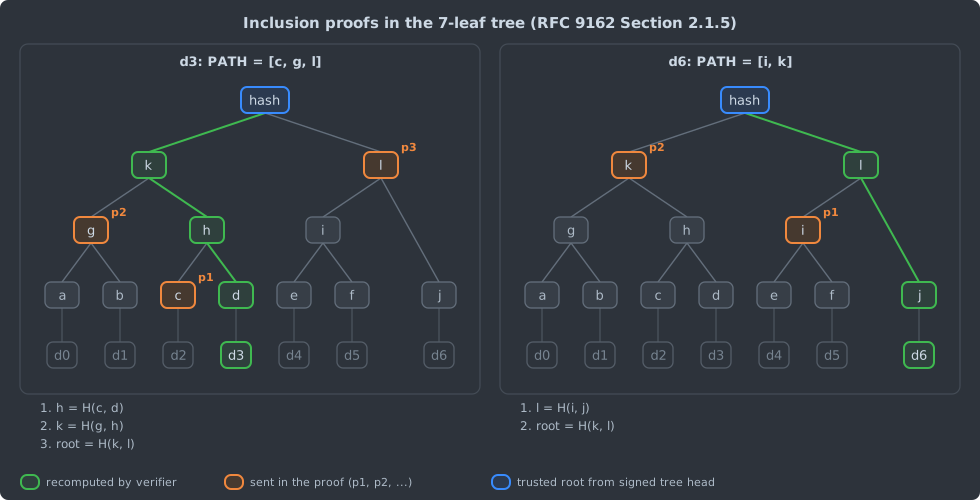
图中两个例子都来自 RFC 9162 第 2.1.5 节。\(d_3\) 在左侧满子树里,证明有 3 个哈希;\(d_6\) 在右边界上,它的叶哈希 \(j\) 被直接提升到第二层,所以证明只有 \(i\) 和 \(k\) 两个哈希。
验证算法
验证者要知道叶子下标 \(m\) 和树大小 \(n\),才能判断每个兄弟在左边还是右边。第
2.1.3.2 节的算法用两个游标:\(f_n\) 从 \(m\) 开始,\(s_n\) 从 \(n-1\)
开始,二者每上升一层同时右移一位。\(f_n\) 的最低位为 1
说明当前节点是右孩子,兄弟在左;\(f_n = s_n\)
说明当前节点在右边界上且没有右兄弟,这时它会被一直提升,直到它成为某个节点的右孩子。实现如下(摘自
reproduce/merkle.c):
static int verify_inclusion(uint64_t leaf_index, uint64_t tree_size,
                            const hash_t *leaf, const hash_t *proof, size_t plen,
                            const hash_t *root)
{
    if (leaf_index >= tree_size) return 0;
    uint64_t fn = leaf_index, sn = tree_size - 1;
    hash_t r = *leaf;
    for (size_t i = 0; i < plen; i++) {
        if (sn == 0) return 0;                 /* proof longer than the path */
        if ((fn & 1) || fn == sn) {
            r = node_hash(&proof[i], &r);      /* sibling on the left */
            while (!(fn & 1) && fn != 0) { fn >>= 1; sn >>= 1; }
        } else {
            r = node_hash(&r, &proof[i]);      /* sibling on the right */
        }
        fn >>= 1; sn >>= 1;
    }
    return sn == 0 && heq(&r, root);           /* proof not shorter than the path */
}
以 \(d_6\)(\(m=6\),\(n=7\))为例,逐步执行:
| 步骤 | 证明元素 | 执行前 \(f_n\) / \(s_n\) | 判断 | 计算 | 执行后 \(f_n\) / \(s_n\) |
|---|---|---|---|---|---|
| 1 | \(i\) | 6 / 6 | \(f_n = s_n\),兄弟在左 | \(r = \mathrm{H}(i, j) = l\);\(f_n\) 最低位为 0,同时右移到 3 / 3,再右移一次 | 1 / 1 |
| 2 | \(k\) | 1 / 1 | \(f_n\) 最低位为 1,兄弟在左 | \(r = \mathrm{H}(k, l)\) | 0 / 0 |
结束时 \(s_n =
0\),\(r\)
与根相等,验证通过。结尾的 \(s_n =
0\) 检查与循环里的 \(s_n
\ne 0\)
检查分别拒绝过短和过长的证明,下标或树大小填错时路径形状对不上,验证失败。reproduce/merkle.c
对 \(n \le 128\) 的全部
8,256 个包含证明和 8,128
个一致性证明做了穷举:正确证明全部通过;对每个证明元素翻转一位、把下标加一、把树大小加一,共构造
130,496 个篡改证明,全部被拒绝。
证明长度
路径上每层最多一个兄弟,所以证明长度不超过 \(\lceil \log_2 n \rceil\)。精确长度有闭式:令 \(L = \operatorname{bitlen}(m \oplus (n-1))\),则
\[ \lvert \mathrm{PATH}(m, D_n) \rvert = L + \operatorname{popcount}(m \gg L). \]
transparency-dev/merkle 的 proof/verify.go
用 decompInclProof()
按这个式子预先检查证明长度。直观解释是:\(m\) 与 \(n-1\) 的最高 \(64-L\) 位相同,这些层上 \(m\)
的祖先落在右边界上;再往下,\(m\) 在一棵 \(2^L\)
叶的满子树里,每层恰好一个兄弟,共 \(L\) 个。右边界上的某层,如果
\(m\) 的对应位是
1,祖先是右孩子,左边有一棵满子树,贡献一个哈希;如果是
0,祖先是左孩子,而 \(n-1\)
的对应位也是
0,说明右兄弟不存在,节点被提升,不贡献哈希。程序对 \(n \le 4096\) 的全部 8,390,656
个 \((m, n)\)
组合检查了闭式与递归定义一致。
对全部叶子统计证明长度(SHA-256,每个哈希 32 字节):
| \(n\) | \(\lceil \log_2 n \rceil\) | 最短 | 最长 | 平均 | 最长证明字节数 |
|---|---|---|---|---|---|
| 7 | 3 | 2 | 3 | 2.857 | 96 |
| 1,000 | 10 | 8 | 10 | 9.984 | 320 |
| 1,024 | 10 | 10 | 10 | 10.000 | 320 |
| 1,025 | 11 | 1 | 11 | 10.990 | 352 |
| 1,000,000 | 20 | 12 | 20 | 19.981 | 640 |
| 1,000,000,000 | 30 | 21 | 30 | 29.936 | 960 |
\(n = 1025\) 的最短证明只有 1 个哈希:最后一个叶子单独构成右子树,证明只需要左边 1024 叶满子树的根。十亿条记录中任意一条的证明不超过 960 字节,验证需要 30 次内部节点哈希加 1 次叶哈希。
四、一致性证明
定义
一致性证明(consistency proof)回答另一个问题:日志之前公布过大小为 \(m\) 的根,现在公布大小为 \(n\) 的根,新树的前 \(m\) 个叶子是否与旧树完全相同。第 2.1.4.1 节的定义是 \(\mathrm{PROOF}(m, D_n) = \mathrm{SUBPROOF}(m, D_n, \text{true})\),其中
\[ \mathrm{SUBPROOF}(m, D_n, b) = \begin{cases} \{\} & m = n,\ b = \text{true}, \\ \{\mathrm{MTH}(D_m)\} & m = n,\ b = \text{false}, \\ \mathrm{SUBPROOF}(m, D[0{:}k], b) : \mathrm{MTH}(D[k{:}n]) & m \le k, \\ \mathrm{SUBPROOF}(m-k, D[k{:}n], \text{false}) : \mathrm{MTH}(D[0{:}k]) & m > k. \end{cases} \]
布尔量 \(b\) 表示”前 \(m\) 个叶子构成的子树是否恰好是新树的一棵完整子树”。是的话,旧根本身就是这棵子树的哈希,验证者已经有了,不必再发。RFC 给出的上界是 \(\lceil \log_2 n \rceil + 1\) 个哈希。
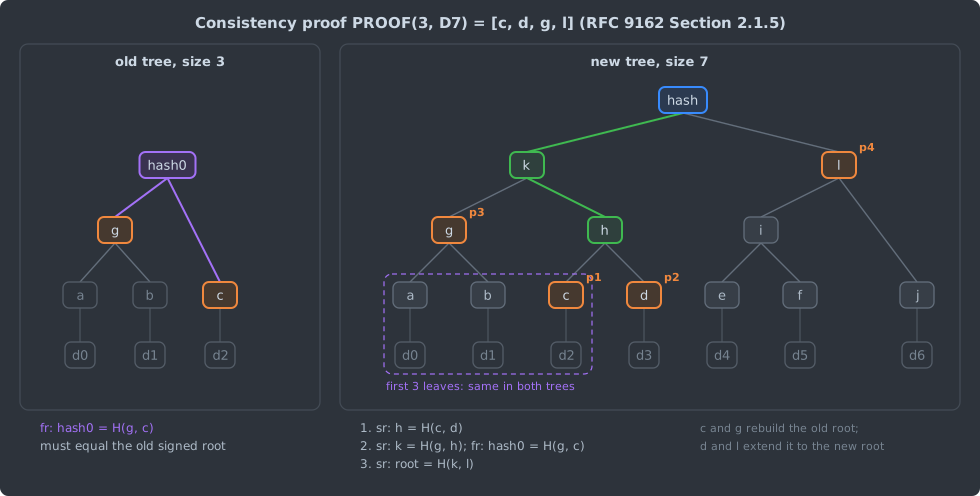
图中的例子来自 RFC 9162 第 2.1.5 节。旧树大小 3,它的根 \(\mathit{hash0} = \mathrm{H}(g, c)\) 在新树里并不是某个节点的哈希(新树里 \(c\) 的父节点是 \(h = \mathrm{H}(c, d)\)),所以证明必须把 \(c\) 和 \(g\) 交给验证者,让它先重建旧根,再用 \(d\) 和 \(l\) 走到新根。同一个 \(c\)、\(g\) 同时出现在两条计算链里,这正是”旧树是新树前缀”的证据:由抗碰撞性,旧根与新根都覆盖了同样的前 3 个叶子。
验证算法
第 2.1.4.2 节的验证算法同时维护两个值:\(f_r\) 重建旧根,\(s_r\) 重建新根。若 \(m\) 恰好是 2 的幂,先把旧根本身放到证明最前面;\(f_n = m-1\) 与 \(s_n = n-1\) 的作用与包含证明相同,先把 \(f_n\) 末尾的连续 1 右移掉。之后每个证明元素 \(c\):若兄弟在左(\(f_n\) 最低位为 1 或 \(f_n = s_n\)),\(f_r\) 与 \(s_r\) 都与它合并;否则只有 \(s_r\) 与它合并,因为右侧的节点只属于新树。\(\mathrm{PROOF}(3, D_7)\) 的执行过程:
| 步骤 | 证明元素 | 执行前 \(f_n\) / \(s_n\) | 判断 | 计算 | 执行后 \(f_n\) / \(s_n\) |
|---|---|---|---|---|---|
| 初始 | \(c\) | 2 / 6 | 3 不是 2 的幂;\(f_n\) 最低位为 0,不右移 | \(f_r = s_r = c\) | 2 / 6 |
| 1 | \(d\) | 2 / 6 | 兄弟在右,只属于新树 | \(s_r = \mathrm{H}(c, d) = h\) | 1 / 3 |
| 2 | \(g\) | 1 / 3 | 兄弟在左,两树共有 | \(f_r = \mathrm{H}(g, c) = \mathit{hash0}\),\(s_r = \mathrm{H}(g, h) = k\) | 0 / 1 |
| 3 | \(l\) | 0 / 1 | 兄弟在右,只属于新树 | \(s_r = \mathrm{H}(k, l) = \mathit{root}\) | 0 / 0 |
最后检查 \(f_r\) 等于旧根、\(s_r\) 等于新根、\(s_n = 0\)。
长度与用途
程序对 \(0 < m < n \le 4096\) 的全部 8,386,560 对检查了 \(\lvert \mathrm{PROOF}(m, D_n) \rvert \le \lceil \log_2 n \rceil + 1\),这个上界是紧的:有 3,724,179 对(约 44%)恰好达到它。\(n = 10^6\) 时,对所有旧大小 \(m\),证明长度在 1 到 21 之间,平均 19.98 个哈希。最短的情形是 \(m\) 恰好等于切分点 \(k\),例如 RFC 例子里的 \(\mathrm{PROOF}(4, D_7) = [l]\)。
在 CT 里,这两种证明由不同的角色使用。RFC 6962 定义了
get-proof-by-hash(第 4.5 节)和
get-sth-consistency(第 4.4
节)两个接口:监视者(monitor)和审计者(auditor)定期取回新的签名树头(signed
tree
head,STH),用一致性证明确认日志只追加;持有某张证书的一方用包含证明确认证书确实进了日志。第九节会说明,浏览器在
TLS 握手中并不做这两种验证。
五、两类构造缺陷
缺少域分离:一棵树有一个更矮的孪生
把前缀去掉,令叶哈希为 \(\mathrm{H}(d)\)、内部节点为 \(\mathrm{H}(L \,\|\, R)\)。4 叶列表 \([d_0, d_1, d_2, d_3]\) 的根是
\[ R = \mathrm{H}\bigl(\mathrm{H}(L_0 \| L_1) \,\|\, \mathrm{H}(L_2 \| L_3)\bigr), \qquad L_i = \mathrm{H}(d_i). \]
构造两个 64 字节的”叶子” \(x_0 = L_0 \| L_1\)、\(x_1 = L_2 \| L_3\),2 叶列表 \([x_0, x_1]\) 的根是 \(\mathrm{H}(\mathrm{H}(x_0) \| \mathrm{H}(x_1)) = R\),与原列表相同。
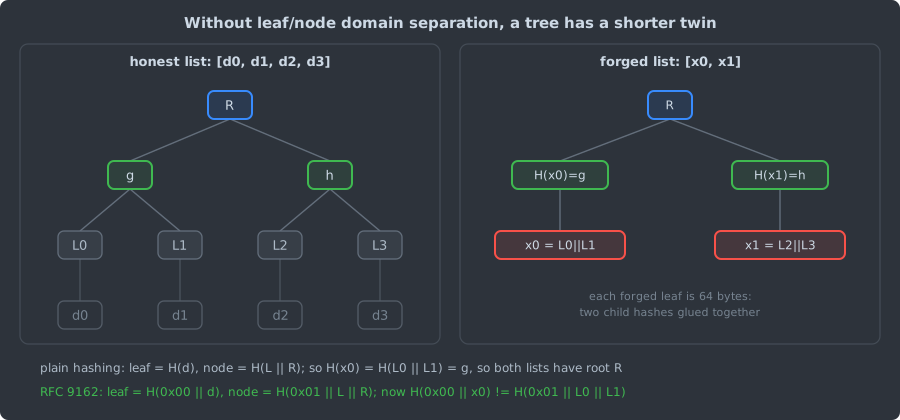
这不是哈希函数的第二原像,而是”列表到根”这个映射的第二原像:任何一个内部节点的
64
字节原像都可以被当作叶子提交,并附上一份能通过验证的包含证明。reproduce/merkle.c
复现了这一点:无前缀时两个列表的根相同,把 \(x_0\) 当作”大小为 2 的树中第 0
个叶子”、以 \([h]\)
为证明也能通过验证;换成 RFC 9162 的前缀后两个根不同。
攻击能否落地取决于验证者是否可信地知道树大小。CT 的 STH
签了 tree_size,而验证算法要求路径形状与 \(n\)
吻合,单靠形状就会拒绝上面的伪造;前缀让安全性不再依赖这个前提。Merkle
1979 年的专利对叶子和内部节点用的是同一个 \(F\),这一细节在当时的一次性签名场景下不构成问题,因为叶子个数是签名者自己定的。
Bitcoin:复制最后一个哈希(CVE-2012-2459)
Bitcoin 区块头承诺交易列表的 Merkle 根,叶子是交易
ID(交易序列化的双重 SHA-256),内部节点是 \(\mathrm{SHA256d}(L \|
R)\),没有前缀。某层节点数为奇数时,复制最后一个再配对。Bitcoin
Core v28.0 的 src/consensus/merkle.cpp 在
ComputeMerkleRoot()
上方用一整段注释警告后来者:
uint256 ComputeMerkleRoot(std::vector<uint256> hashes, bool* mutated) {
    bool mutation = false;
    while (hashes.size() > 1) {
        if (mutated) {
            for (size_t pos = 0; pos + 1 < hashes.size(); pos += 2) {
                if (hashes[pos] == hashes[pos + 1]) mutation = true;
            }
        }
        if (hashes.size() & 1) {
            hashes.push_back(hashes.back());
        }
        SHA256D64(hashes[0].begin(), hashes[0].begin(), hashes.size() / 2);
        hashes.resize(hashes.size() / 2);
    }
    if (mutated) *mutated = mutation;
    if (hashes.size() == 0) return uint256();
    return hashes[0];
}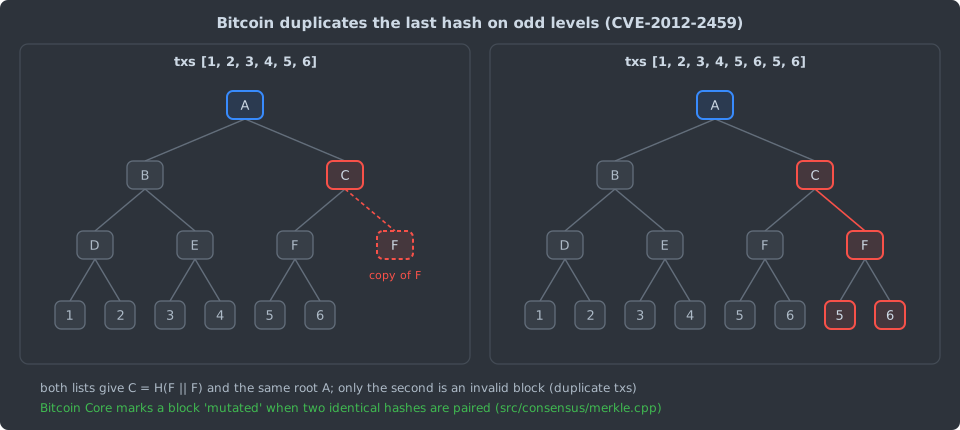
注释里的例子是交易列表 \([1,2,3,4,5,6]\) 与 \([1,2,3,4,5,6,5,6]\):第二层分别是
\([D, E, F]\) 和 \([D, E, F, F]\),前者复制 \(F\)
后与后者完全相同,所以两个列表的根相同,区块头哈希也相同。后一个列表含重复交易,区块无效。注释描述的攻击是:攻击者把这个无效变体转发给节点,节点如果因此把这个区块哈希永久标记为无效,之后就不会再接受同一哈希下的合法区块。防御是上面代码里的
mutated
标志:只要某层出现两个相同的哈希配对,就按 Merkle
根无效处理。注释的结论是,在双重 SHA-256
不出现碰撞的前提下,这能检测所有已知的”改交易不改根”的方法。reproduce/merkle.c
用同样的规则复现:两个列表的根相同,mutated
标志分别为 0 和 1;同样的交易 ID 放进 RFC 9162
的树,两个根不同,因为 RFC 的树形由 \(n\) 决定,6 叶与 8
叶的树形不同。
Bitcoin:64 字节交易与争论
Bitcoin 也没有叶子与内部节点的域分离,于是第一小节的问题同样存在:非见证部分恰好 64 字节的交易,既可以被解释成叶子,也可以被解释成一个内部节点的两个子哈希。BIP 54(Consensus Cleanup,Poinsot 与 Corallo,2025 年 4 月分配编号)在动机一节写道,这使攻击者可以骗过 SPV 验证者,让它接受一个并不在区块里的交易的包含证明。与 CT 不同,区块头没有承诺交易数,SPV 客户端无法从头部得知树的深度。
BIP 54 的方案是把非见证序列化恰好 64
字节的交易定为无效。它同时记录了反对意见和替代方案:有人认为给
Merkle
证明使用者带来的改进太小,不值得在合法交易大小中挖出一个”空洞”;替代方案包括在区块头的
version
字段里承诺树深、把能解析成合法交易的内部节点定为无效;SPV
侧也有三种变通办法,例如额外请求 coinbase
交易的证明来推断树深(Sergio Lerner 2018
年的文章给出了细节)。BIP 作者的理由是从根源上修复,并指出
64 字节交易自 2019 年起已不是标准交易、2016
年以后没有再被使用过。在现有共识规则下,Bitcoin Core v28.0
的
IsBlockMutated()(src/validation.cpp)只对没有
coinbase 交易、本来就无效的区块检查 64
字节交易,注释明确说明这不是共识变更。
六、从列表到键值映射
RFC 9162 的树承诺的是一个有序列表,能证明”第 \(m\) 条是 \(x\)“,却无法直接证明”键 \(k\) 不存在”,也无法高效地修改中间元素。承诺键值映射有两条路:一是让叶子按键排序,用相邻两个叶子夹住缺失的键(Naor–Nissim 的 2-3 树就是这样),二是让叶子的位置由键本身决定。
稀疏 Merkle 树
稀疏 Merkle 树把键哈希成 \(d\) 位的串(通常 \(d = 256\)),位置就是这个串,整棵树有 \(2^d\) 个叶子,绝大多数为空。空子树的哈希只与高度有关,可以预先算出默认摘要:
\[ D_0 = \mathrm{H}(\varnothing), \qquad D_{i+1} = \mathrm{H}(D_i \,\|\, D_i). \]
存在性证明和不存在性证明走同一条路:从键对应的位置出发,给出 \(d\) 个兄弟,验证者从该位置的值(不存在时就是 \(D_0\))算到根。
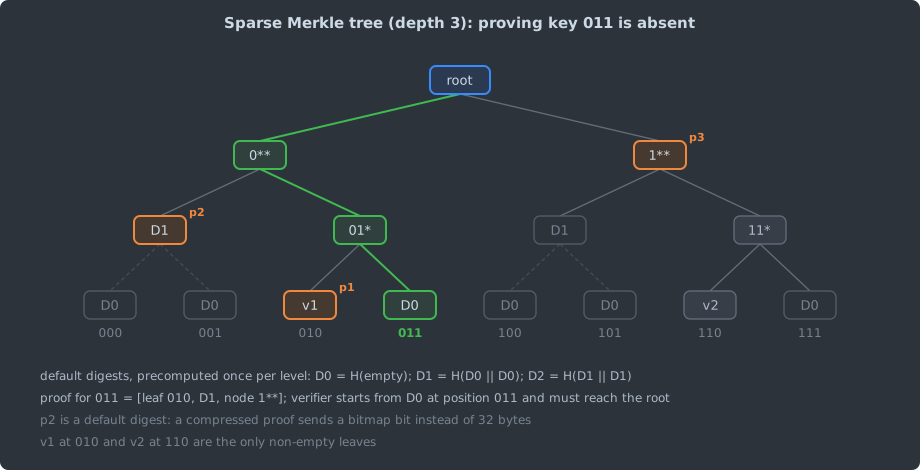
由于路径上大部分兄弟都是默认摘要,证明可以用一个 \(d\) 位的位图标出哪些层是默认值,只发送非默认的兄弟,平均长度回到 \(O(\log N)\)(\(N\) 为非空键数)。代价在存储侧:朴素实现要为每次更新重算 \(d\) 个节点。Dahlberg、Pulls、Peeters 2016 年的论文给出了只缓存非空分支的递归定义,并给出了(非)成员证明的安全性论证。
以太坊的 Merkle Patricia Trie
以太坊没有用稀疏 Merkle 树,而是用 Merkle Patricia Trie(MPT),定义在黄皮书附录 D。它是 16 叉的 Patricia trie(键按 4 位的 nibble 分支,单孩子链被压缩),按黄皮书只有三种节点:
- 叶子节点:2 项,剩余键 nibble 的 hex-prefix 编码(标志 \(t = 1\))和值;
- 扩展节点:2 项,共享的 nibble 前缀(标志 \(t = 0\))和子节点引用;
- 分支节点:17 项,16 个子节点引用加上一个值槽,值槽用于某个键恰好在此结束的情况。
空树不是节点类型,它的编码是空字节序列。子节点引用的规则是:节点的
RLP 编码短于 32 字节就直接内联,否则引用它的 Keccak-256
哈希;根哈希是根节点 RLP 编码的 Keccak-256。go-ethereum
v1.16.9 的实现与此一致:trie/node.go 中
fullNode 是
Children [17]node,叶子和扩展节点共用
shortNode,解码时用 hasTerm(key)
判断键尾是否带终止符来区分;trie/hasher.go 对
len(enc) < 32 的节点不做哈希。
下面用 4 个 7 位 nibble
键演示结构(值省略):a711355、a77d337、a7f9365、a77d397。
flowchart TD
  R["extension: a7"] --> B1["branch<br/>slots 1, 7, f"]
  B1 -- "1" --> L1["leaf: 1355"]
  B1 -- "7" --> E2["extension: d3"]
  B1 -- "f" --> L3["leaf: 9365"]
  E2 --> B2["branch<br/>slots 3, 9"]
  B2 -- "3" --> L4["leaf: 7<br/>key a77d337"]
  B2 -- "9" --> L5["leaf: 7<br/>key a77d397"]
四个键共享前缀
a7,被一个扩展节点吸收;第三个 nibble 分出
1、7、f
三支;a77d337 与 a77d397 再共享
d3,在第六个 nibble 分开。
以太坊的世界状态以 \(\mathrm{KEC}(a)\)(地址的
Keccak-256)为键,而不是 160 位的地址本身,值是 \(\mathrm{RLP}(\mathit{nonce},
\mathit{balance}, \mathit{storageRoot},
\mathit{codeHash})\)。键经过哈希后近似均匀分布,trie
的深度接近 \(\log_{16}
N\);geth 的 trie/secure_trie.go
在读写前对地址做
crypto.Keccak256。每个合约的存储是另一棵
MPT,根放在账户的 storageRoot
里,所以状态是”树中之树”。区块头里还有交易、收据和提款三棵
trie 的根(geth core/types/block.go 中的
TxHash、ReceiptHash、WithdrawalsHash,JSON
字段为
transactionsRoot、receiptsRoot、withdrawalsRoot)。
分支数与证明大小:实测
MPT 的包含证明要带上路径上每个分支节点的全部内容。16 叉分支节点里,除了路径本身的那个孩子,最多还有 15 个 32 字节的兄弟引用。EIP-7864 给出估计:\(N\) 个元素、每个节点 \(k\) 个孩子时,一条分支平均约为
\[ 32 \cdot (k-1) \cdot \frac{\log N}{\log k} \ \text{字节}, \]
\(k = 2\) 时最小,并列出 \(N = 2^{24}\) 时 \(k = 2\) 为 768 字节、\(k = 16\) 为 2,880 字节,同时说”由于分布不均,实际分支长度可能略大”。
reproduce/trie_siblings.c
实测这个估计。它生成 \(N\)
个均匀随机的 64 位键(模拟键先哈希的做法),建一棵路径压缩的
\(k\) 叉 trie(与 MPT
一样,单孩子链不占层),对每个键统计路径上非空兄弟的个数,即哈希型证明需要的哈希数。结果只依赖键的分布,与机器速度无关;3
个随机种子的结果在 \(N =
2^{24}\) 时平均值相差不超过 0.03。节选种子 1
的结果:
| \(k\) | \(N\) | 平均兄弟数 | p99 | 最大 | 估计 \((k-1)\log_k N\) | 实测 / 估计 | 平均字节数 |
|---|---|---|---|---|---|---|---|
| 2 | \(2^{20}\) | 20.33 | 23 | 25 | 20.0 | 1.017 | 651 |
| 2 | \(2^{24}\) | 24.33 | 27 | 30 | 24.0 | 1.014 | 779 |
| 4 | \(2^{24}\) | 35.75 | 39 | 43 | 36.0 | 0.993 | 1,144 |
| 16 | \(2^{20}\) | 70.45 | 75 | 79 | 75.0 | 0.939 | 2,254 |
| 16 | \(2^{24}\) | 85.45 | 90 | 96 | 90.0 | 0.949 | 2,734 |
| 256 | \(2^{20}\) | 525.52 | 535 | 543 | 637.5 | 0.824 | 16,817 |
| 256 | \(2^{24}\) | 672.18 | 690 | 705 | 765.0 | 0.879 | 21,510 |
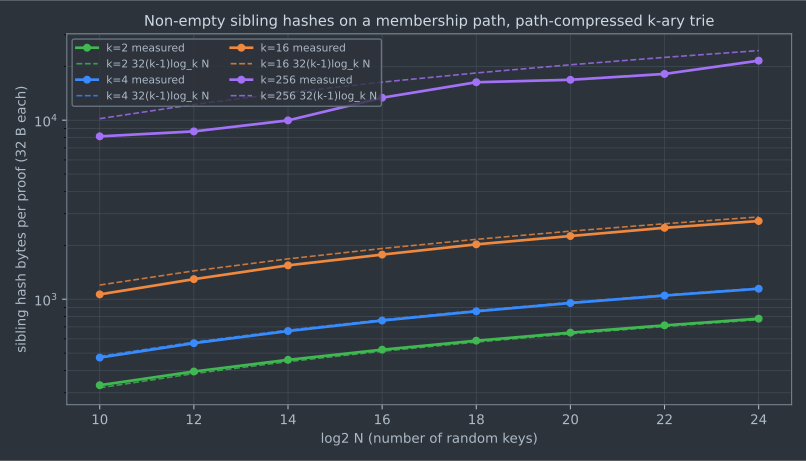
在 \(N = 2^{10}\) 到 \(2^{24}\) 的 8 个规模上,实测与估计之比:\(k = 2\) 为 1.014 到 1.034,\(k = 4\) 为 0.983 到 0.993,\(k = 16\) 为 0.884 到 0.949,\(k = 256\) 为 0.699 到 0.887。EIP-7864 说的”实际略大”只在 \(k = 2\) 时成立:路径压缩的二叉 trie 平均深度约为 \(\log_2 N + 0.33\),比估计多约三分之一层。\(k \ge 16\) 时估计偏大,因为最底层的分支节点通常只有少数几个孩子,不到 \(k-1\) 个兄弟。不过估计偏大并不改变结论:\(N = 2^{24}\) 时,16 叉的平均证明是二叉的 \(85.45 / 24.33 \approx 3.5\) 倍。
这个实验只统计兄弟哈希数。真实的 MPT 证明发送的是路径上每个节点的完整 RLP 编码,还包含路径上的孩子、编码开销和叶子里的值;EIP-7864 的二叉树在底部还有 256 个值的 stem 子树,这些都没有建模。实验的作用是检验 \((k-1)\log_k N\) 这个量级估计,不代表以太坊实际见证的字节数。
七、Git:Merkle DAG 而非 Merkle 树
Git 的对象模型常被称为”Merkle 树”,更准确的说法是 Merkle
DAG(有向无环图)。每个对象的 ID 是
<type> <size>\0<content>
的哈希(默认 SHA-1):
$ printf 'hello world' | git hash-object --stdin
95d09f2b10159347eece71399a7e2e907ea3df4f
$ printf 'blob 11\0hello world' | sha1sum
95d09f2b10159347eece71399a7e2e907ea3df4f  -
tree 对象的内容是若干条
<mode> <name>\0<20 字节二进制 ID>,commit
对象的内容引用一个 tree 和零到多个父
commit。在一个演示仓库里(Git
2.54.0,固定作者和时间),根目录有
README,子目录 src 里有
copy.txt 和 main.c,其中
copy.txt 与 README 内容相同:
$ git cat-file -p HEAD
tree 2adde63c77831bf23df2703dad07cc659db9d837
author ltl <ltl@example.com> 1714000000 +0800
committer ltl <ltl@example.com> 1714000000 +0800

first
$ git cat-file -p HEAD^{tree}
100644 blob 95d09f2b10159347eece71399a7e2e907ea3df4f    README
040000 tree 1d17eb8f262b4b11723cb95205c05dba7e501383    src
$ git cat-file -p HEAD^{tree}:src
100644 blob 95d09f2b10159347eece71399a7e2e907ea3df4f    copy.txt
100644 blob f7e582f82533be28c5813e8ea91918eb7fa61cdc    main.c
$ t=$(git rev-parse HEAD^{tree})
$ (printf "tree %d\0" $(git cat-file -s $t); git cat-file tree $t) | sha1sum
2adde63c77831bf23df2703dad07cc659db9d837  -
最后一条命令从原始 tree 内容重新算出了 tree
ID。cat-file -p 把目录模式显示成
040000,原始字节里其实是
40000,这是计算 tree 哈希时必须注意的细节。
flowchart TD
  C["commit 3647fb3"] --> T0["tree 2adde63<br/>root directory"]
  T0 -- "README" --> B1["blob 95d09f2<br/>hello world"]
  T0 -- "src" --> T1["tree 1d17eb8"]
  T1 -- "copy.txt" --> B1
  T1 -- "main.c" --> B2["blob f7e582f"]
它不是树,原因有三:同一个 blob 被两个 tree 引用(图中的
95d09f2),内容相同的子目录在不同 commit
之间共享同一个 tree 对象,合并 commit
有多个父节点。内容寻址保证无环:一个对象的 ID
依赖它引用的所有对象,不可能引用自己的后代。
这种结构提供的完整性保证与 Merkle 树相同:commit ID
传递地承诺了整个快照和全部历史,git fsck
按哈希逐一重算。但它没有对数大小的包含证明。要向只知道
commit ID 的人证明某个文件的内容,需要交出路径上每一个完整的
tree
对象,大小随目录宽度线性增长,而不是每层一个兄弟哈希。树形也不由某个固定规则决定,而是由目录结构决定。
SHA-1 的抗碰撞性已被 2017 年 2 月 23 日公布的 SHAttered
攻击打破,Git 从 v2.13.0 起默认使用能检测此类碰撞的 hardened
SHA-1,并支持 SHA-256
对象格式(git init --object-format=sha256)。在
SHA-256 仓库里,同一个 hello world blob 的 ID
是
fee53a18d32820613c0527aa79be5cb30173c823a9b448fa4817767cc84c6f03。对象格式的细节见
Git
内部:对象图。
八、向量承诺、Verkle 树与二叉树之争
第六节的实测说明,在哈希树里加宽分支会让证明变大,原因是每层要交出 \(k-1\) 个兄弟。向量承诺(vector commitment)去掉了这个因子:Catalano 与 Fiore(PKC 2013)把它形式化为对一个长度为 \(k\) 的向量做承诺,可以单独打开任意位置 \(i\),打开证明的大小与 \(k\) 无关,且在计算假设下无法把同一位置打开成两个不同的值。Kate、Zaverucha、Goldberg(ASIACRYPT 2010)的多项式承诺(KZG)是一种构造:把向量看作多项式在 \(k\) 个点上的取值,打开证明只有一个群元素。多项式承诺的原理见 承诺方案:Pedersen 承诺、向量承诺与多项式承诺。
Kuszmaul 2018 年在 MIT PRIMES 项目中提出 Verkle 树(“vector commitment” 与 “Merkle” 的合成词):把 Merkle 树每个节点的哈希换成对其 \(k\) 个孩子的向量承诺。构造代价是 \(O(kn)\),证明大小是 \(O(\log_k n)\),没有 \((k-1)\) 因子,所以 \(k\) 可以取得很大。
以太坊社区围绕这一取舍先后提出了两个方案,两份 EIP 的 10 位作者相同:
- EIP-6800(2023 年 3 月创建,现为 Stagnant):宽度 256 的 Verkle 树,承诺是 Bandersnatch 曲线上的 Pedersen 向量承诺。动机一节的数据是:当前 16 叉 Patricia 树中访问一个账户的见证平均接近 3 kB,最坏约为三倍;按每块最多 6000 次访问计,最坏见证约 18 MB,无法在 12 秒的时隙内安全广播;Verkle 树把平均值降到每个账户约 200 字节。
- EIP-7864(2025 年 1 月创建,现为 Draft):改用二叉哈希树,账户数据、代码和存储合并进一棵树,底部每 256 个值组成一个 stem 子树。哈希函数尚未确定,参考实现用 BLAKE3,候选还有 Keccak 和 Poseidon2,其中 Poseidon2 的安全性分析仍在以太坊基金会的密码学项目中进行。
EIP-7864 的 Rationale 一节直接回应了 Verkle 方案。第一是后量子安全:Verkle 树依赖椭圆曲线,而文中认为量子计算机可能在 2030 年代出现,并引述 NIST 建议到 2030 年停止使用椭圆曲线密码;二叉哈希树只依赖哈希函数。第二是证明系统的进展:文中写道,Verkle 树的主要优势是证明小且生成快,而证明系统的进展表明可能已接近足够快地生成状态证明的性能,届时见证可以用有效性证明(validity proof,即 SNARK 一类证明)整体压缩,二叉树结构简单,在电路里更容易证明。第三,Verkle 树终究需要再被后量子方案替换,二叉树”可能是最终的状态树”。
这场争论没有结束。两个 EIP 都未进入最终状态;二叉树方案的见证大小(按第六节只计兄弟哈希的模型,\(2^{24}\) 个键时每条分支约 780 字节)仍明显大于 Verkle 的约 200 字节,它依赖的前提是 SNARK 证明足够快,以及最终选定的哈希函数(例如 Poseidon2)经得起分析,这两点在 EIP 里都写作未决。
九、工程间隙与开放问题
浏览器检查的是承诺,不是证明
CT 的 Merkle 证明很少出现在 TLS 握手里。日志收到证书后立即返回签名证书时间戳(signed certificate timestamp,SCT),这是一个签名承诺:在最大合并延迟(maximum merge delay,MMD)内把证书并入树中。MMD 是每个日志自己公布的参数,RFC 没有规定固定值。Chrome 的 CT 政策按 SCT 定义合规:有效期不超过 180 天的证书需要 2 个 SCT,超过 180 天需要 3 个,并要求来自不同的日志运营者。Firefox 135(2025 年 2 月 4 日)起在桌面版强制执行 CT。
包含证明的验证被推到了异步环节。RFC 9162 第 11.3
节写道,违反 MMD 承诺要靠客户端对每个见到的 SCT
请求包含证明来发现,检查可以异步进行;第 8.1.4 节则提醒,TLS
客户端直接向日志要证明会把”它访问了哪个网站”泄露给日志。于是实践中真正调用
get-proof-by-hash 与
get-sth-consistency
的主要是监视者和审计者,而普通 TLS 客户端只检查 SCT
的签名。
split view:一致性证明管不到的攻击
一致性证明只能说明”日志给我看的两个版本前后一致”,不能说明”日志给所有人看的是同一棵树”。一个恶意日志可以对不同的客户端维护两条各自自洽的分叉。RFC 9162 第 1 节承认,审计机制可以被向不同客户端展示不同视图的日志绕过,因此”必须把每个日志当作可信第三方”,而解决机制”不在本文档范围内”。第 11.3 节把比较各自 STH 的做法称为 gossip,并说它”is an active area of research and not defined here”。Laurie 在 ACM Queue 2014 年的文章里同样把 gossip 列为尚未解决的问题。
这个问题的学术和工程方向是见证(witness):Syta 等人(IEEE S&P 2016)提出分散式见证联署(witness cosigning),权威每次发布声明前都要收集一批独立见证者的联合签名,见证者可以拒绝为分叉的历史签名。C2SP 的 tlog-witness 协议把它落实到透明日志上:日志生成新的 checkpoint 时附上一致性证明请求见证者签名,见证者核对它与自己上次记录的状态一致后才返回签名,这样一份带足够联署的包含证明可以离线验证。但见证者由谁担任、需要多少、TLS 客户端是否以及如何要求联署,这些都还没有标准答案;RFC 9162 本身也没有定义这些机制。
规范版本与部署
RFC 9162 取代了 RFC 6962,但生产中的 CT 生态仍以 RFC 6962
为接口基础:C2SP 的 static-ct-api 规范在保留 RFC 6962
提交接口、产生 RFC 6962 签名的前提下,把读取接口从
get-proof-by-hash 这类动态接口换成静态的 tile
文件,从而可以放在对象存储和 CDN
上。对本文的内容来说,这个差别不影响结论:两版 RFC 的
MTH、PATH、PROOF
定义逐字相同,第三、四节的证明在两版中都成立。
十、参考资料
规范与文档
- B. Laurie, A. Langley, E. Kasper, “Certificate
Transparency”, RFC 6962, June 2013. 第 2.1 节(Merkle
树)、第 4.4 与 4.5
节(
get-sth-consistency、get-proof-by-hash)。 - B. Laurie, E. Messeri, R. Stradling, “Certificate Transparency Version 2.0”, RFC 9162, December 2021. 第 1 节、第 2.1 节(2.1.1 至 2.1.5)、第 8.1.4 节、第 11.3 节。
- C2SP, “Static Certificate Transparency API”,
static-ct-api.md, c2sp.org/static-ct-api. - C2SP, “tlog-witness”,
tlog-witness.md(commit 2f3eec0), c2sp.org/tlog-witness. - A. Poinsot, M. Corallo, “Consensus Cleanup”, BIP 54(bitcoin/bips commit e8987d3), github.com/bitcoin/bips/blob/master/bip-0054.md.
- V. Buterin, D. Feist, K. Wedderburn, G. Ballet et al., “Ethereum state using a unified verkle tree”, EIP-6800, 2023, eips.ethereum.org/EIPS/eip-6800.
- V. Buterin, G. Ballet, D. Feist, I. Hagopian et al., “Ethereum state using a unified binary tree”, EIP-7864, 2025, eips.ethereum.org/EIPS/eip-7864.
- G. Wood, “Ethereum: A Secure Decentralised Generalised Transaction Ledger”, Shanghai version(ethereum/yellowpaper commit efc5f9a, 2025-02-04),附录 D。
- Google Chrome, “Chrome Certificate Transparency Policy”, googlechrome.github.io/CertificateTransparency/ct_policy.html.
- Git 文档, “hash-function-transition”, git-scm.com/docs/hash-function-transition.
源码
- transparency-dev/merkle
v0.0.2:
testonly/constants.go(叶子输入与根哈希)、proof/verify.go(decompInclProof())、proof/verify_test.go(包含与一致性证明向量)。 - Bitcoin Core
v28.0:
src/consensus/merkle.cpp(ComputeMerkleRoot()及 CVE-2012-2459 注释)、src/validation.cpp(IsBlockMutated())。 - go-ethereum
v1.16.9:
trie/node.go、trie/hasher.go、trie/secure_trie.go、core/types/block.go。
核心论文
- R. C. Merkle, Secrecy, Authentication, and Public Key Systems, Ph.D. thesis, Stanford University, June 1979(Technical Report 1979-1).
- R. C. Merkle, US Patent 4,309,569, filed 1979-09-05, granted 1982-01-05.
- R. C. Merkle, “A Digital Signature Based on a Conventional Encryption Function”, CRYPTO ’87, LNCS 293, 1988, 369–378.
- R. C. Merkle, “A Certified Digital Signature”, CRYPTO ’89, LNCS 435, 1990, 218–238.
- M. Naor, K. Nissim, “Certificate Revocation and Certificate Update”, USENIX Security 1998; IEEE Journal on Selected Areas in Communications 18(4), 2000, 561–570.
- R. Tamassia, “Authenticated Data Structures”, ESA 2003, LNCS 2832, 2003, 2–5.
- S. A. Crosby, D. S. Wallach, “Efficient Data Structures for Tamper-Evident Logging”, USENIX Security 2009.
其他论文
- A. Miller, M. Hicks, J. Katz, E. Shi, “Authenticated Data Structures, Generically”, POPL 2014, 411–423.
- B. Laurie, E. Kasper, “Revocation Transparency”, 2012.
- R. Dahlberg, T. Pulls, R. Peeters, “Efficient Sparse Merkle Trees: Caching Strategies and Secure (Non-)Membership Proofs”, NordSec 2016, LNCS 10014, 199–215.
- J. Kuszmaul, “Verkle Trees”, MIT PRIMES, 2018.
- D. Catalano, D. Fiore, “Vector Commitments and Their Applications”, PKC 2013, 55–72.
- A. Kate, G. M. Zaverucha, I. Goldberg, “Constant-Size Commitments to Polynomials and Their Applications”, ASIACRYPT 2010, 177–194.
- E. Syta et al., “Keeping Authorities ‘Honest or Bust’ with Decentralized Witness Cosigning”, IEEE S&P 2016, 526–545.
- S. Nakamoto, “Bitcoin: A Peer-to-Peer Electronic Cash System”, 2008. 第 7、8 节。
工程资料
- B. Laurie, “Certificate Transparency”, ACM Queue 12(8), 2014, 10–19.
- S. D. Lerner, “Leaf-Node weakness in Bitcoin Merkle Tree Design”, bitslog, 2018-06-09, bitslog.com/2018/06/09/leaf-node-weakness-in-bitcoin-merkle-tree-design.
- Mozilla, Firefox 135 release notes, 2025-02-04(桌面版强制执行 Certificate Transparency)。
实验
reproduce/merkle.c:RFC 9162 的 MTH、PATH、PROOF 与两种验证算法,外部测试向量、RFC 2.1.5 例子、栈算法、\(n \le 128\) 穷举与篡改测试、证明长度统计,以及域分离缺失和 Bitcoin 复制规则两个缺陷演示。reproduce/trie_siblings.c:\(k\) 叉路径压缩 trie 的兄弟哈希数统计。reproduce/run.sh:sh run.sh 5编译并运行两个程序,结果写入reproduce/results/;环境为 Intel Core i9-12900K、WSL2(Linux 6.6.87.2)、GCC 16.1.1、OpenSSL 3.6.2。所有数字与时钟无关。reproduce/plot_trie.py:取 3 个种子的中位数生成trie-proof-size.svg(需要 matplotlib);reproduce/draw_figures.py:生成其余 6 张示意图(仅用 Python 标准库)。
系列导航: - 上一篇:van Emde Boas 树:整数前驱查询的递归结构、空间代价与下界 - 下一篇:后缀数组:倍增、SA-IS、LCP 与增强后缀数组
相关阅读: - 持久化数据结构:路径复制、节点复制与宽分支 trie - 密码学哈希与非密码学哈希:安全定义、迭代构造与哈希洪泛 - 【密码学百科】哈希基签名:从 Lamport 到 SPHINCS+ 的无状态后量子签名 - 【密码学百科】承诺方案:Pedersen 承诺、向量承诺与多项式承诺 - 【Git 内部】对象图:tree、commit、tag 的链式结构
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
素性测试与素数生成:Miller-Rabin、BPSW 与 OpenSSL/FIPS 186-5
用可复现实验核对 Miller-Rabin 的 1/4 界、平均情况误判率和 64 位确定性底数,梳理 BPSW 与 AKS 的谱系,并对照 OpenSSL 3.6.2 源码与 FIPS 186-5 说明 RSA 素数实际做几轮测试、为什么够用。
密码学哈希与非密码学哈希:安全定义、迭代构造与哈希洪泛
区分非密码学哈希、带密钥 PRF 与密码学哈希三种契约;用可复现实验演示 SHA-256 长度扩展、雪崩测试的局限、DJBX33A 与带种子 MurmurHash3 的哈希洪泛,并对照 CPython、Rust、Go、Abseil 源码说明各自默认哈希。
持久化数据结构:路径复制、节点复制与宽分支 trie
保留全部历史版本要多少代价?从 DSST 1989 的胖节点、节点复制出发,对照路径复制、Okasaki 的惰性队列、Clojure/Scala 的 32 路 trie、HAMT/CHAMP 与 Git 对象模型,用可复现程序测量每次更新复制的节点和字节。
【密码学百科】PKI 与数字证书:信任链的构建与崩塌
PKI 是互联网信任的基础设施——本文从 X.509 证书结构深入到信任链验证,剖析 CA 失败案例、证书透明度机制,以及 Let's Encrypt 如何改变了证书生态