PageRank 常被压缩成一句话:被重要页面链接的页面更重要。这句话只讲了直觉,没有讲清三个会让实现出错的问题:原始论文里的公式为什么写成 \((1-d)\) 而现代教材常写成 \((1-d)/N\);没有出链的页面到底把概率质量给谁;幂迭代收敛慢时,应该改阻尼因子、换迭代器,还是改成局部近似。
本文把 PageRank 写成一个带重启的马尔可夫链(Markov
chain)。所有实验数据来自同目录
reproduce/pagerank_experiment.py:脚本在固定种子的合成有向图上统计迭代次数、\(L_1\) 残差、push
次数、采样步数和相对稠密线性方程精确解的误差,并用 NetworkX
3.3 源码实现做结果对照。Google
当今搜索排序只写公开文档能支撑的事实,不把泄露材料或 SEO
传闻写成结论。

一、从随机游走到 PageRank 方程
设有向图 \(G=(V,E)\),\(N=|V|\)。若页面 \(j\) 有出链集合 \(\text{Out}(j)\),普通随机游走的列随机转移矩阵 \(P\) 可写成:
\[ P_{ij}=\begin{cases} 1/|\text{Out}(j)|,& (j,i)\in E,\\ 0,& \text{otherwise}. \end{cases} \]
若 \(\boldsymbol{x}^{(t)}\) 是第 \(t\) 步停在各页面的概率分布,则
\[ \boldsymbol{x}^{(t+1)} = P\boldsymbol{x}^{(t)}. \]
这个模型在真实 Web 图上有两个坏边界:图可能不是强连通,随机游走会被困在没有外链的强连通分量;还可能存在悬挂节点(dangling node),也就是没有出链的页面,此时 \(P\) 的对应列全为 0,概率质量会泄漏。
PageRank 加了重启:每一步以概率 \(d\) 继续沿链接走,以概率 \(1-d\) 按偏好向量 \(\boldsymbol{v}\) 跳转。\(\boldsymbol{v}\) 是概率分布,标准 PageRank 常取均匀分布 \(\boldsymbol{v}=\boldsymbol{1}/N\)。把悬挂节点也按同一个分布重启,方程是:
\[ \boldsymbol{r}=d\left(P + \boldsymbol{v}\boldsymbol{a}^{\mathsf T}\right)\boldsymbol{r} + (1-d)\boldsymbol{v}, \]
其中 \(a_j=1\) 表示 \(j\) 是悬挂节点,否则为 0。矩阵
\[ G=d\left(P + \boldsymbol{v}\boldsymbol{a}^{\mathsf T}\right)+(1-d)\boldsymbol{v}\boldsymbol{1}^{\mathsf T} \]
叫 Google 矩阵;\(\boldsymbol{r}\) 是 \(G\) 的平稳分布,满足 \(\boldsymbol{r}=G\boldsymbol{r}\) 且 \(\sum_i r_i=1\)。
原始公式里的尺度差异
Brin 和 Page 1998 年 WWW7 / Computer Networks and ISDN Systems 论文的 HTML 版第 2.1.1 节写的是:
\[ PR(A)=(1-d)+d\left(\frac{PR(T_1)}{C(T_1)}+\cdots+\frac{PR(T_n)}{C(T_n)}\right), \]
同一段又说 PageRank 之和为 1。若把 \(PR\) 当作概率分布,上式右侧常数项不能同时保持 \((1-d)\);若保留 \((1-d)\),固定点的总和会按 \(N\) 放大。这是 1998 年 Anatomy HTML 版公式尺度与文字说明之间的矛盾。
Page、Brin、Motwani、Winograd 1999 年 Stanford 技术报告没有简单把常数项改写成 \((1-d)/N\)。它改用 rank source 向量 \(E\) 和归一化常数 \(c\) 表述:
\[ R'(u)=c\sum_{v\in B_u}\frac{R'(v)}{N_v}+cE(u),\qquad \|R'\|_1=1. \]
报告第 6 节做实验时取均匀的 \(E\),且 \(\|E\|_1=0.15\)。在这个口径下,\(E(u)=0.15/N\),再把 \(c\) 吸收到阻尼参数里,才得到后来教材和库常用的等价标准化写法 \((1-d)/N\)。Langville–Meyer 综述和 NetworkX 这类实现默认采用这种概率分布尺度;Spark GraphX 的固定迭代接口则历史上使用“总和约为顶点数”的尺度,后文会单独列出。
尺度不影响同一图内的排序,但会影响残差阈值、跨图比较和与库实现的对照。本文统一使用 \(\sum_i r_i=1\) 的概率分布写法。
二、悬挂节点、重启向量与收敛速度
阻尼因子 \(d\) 有两个作用:让链不可约、非周期,从而有唯一平稳分布;同时把非主特征值压到半径 \(d\) 以内。Haveliwala 与 Kamvar 的 2003 年 Stanford 技术报告证明,对形如 \(G=dP+(1-d)\boldsymbol{e}\boldsymbol{v}^{\mathsf T}\) 的 Google 矩阵,第二特征值的模满足 \(|\lambda_2|\le d\),而真实 Web 图存在多个 closed irreducible subsets 时可以达到等号。直观上,\(d\) 越接近 1,链接结构越“纯”,收敛越慢。
悬挂节点没有唯一的“正确”处理,选择取决于随机游走模型:
| 处理方式 | 方程含义 | 影响 |
|---|---|---|
| 按均匀分布重启 | 到达 sink 后随机跳到任意页面 | 标准教材写法,结果是概率分布 |
| 按 personalization 重启 | sink 与普通 teleport 使用同一偏好向量 | NetworkX 3.3 默认;PPR 中常见 |
| 删除悬挂节点后回填 | 先在非悬挂核心上求解,再把质量传播回来 | 早期大规模计算可减少矩阵规模,但实现复杂 |
| 不处理,只做归一化 | 迭代中丢失质量,最后再缩放 | 排名可能偏向非 sink 区域;只适合明确知道代价时使用 |
幂迭代(power iteration)每轮做一次稀疏矩阵-向量乘法:
x = initial_distribution
while True:
    dangling_mass = sum(x[j] for j in dangling_nodes)
    y = (1 - d) * v + d * dangling_mass * v
    for j, i in edges:
        y[i] += d * x[j] / out_degree[j]
    if l1_norm(y - x) < tolerance:
        break
    x = y
每轮工作量是 \(O(|E|+|V|)\),内存是边表加两个长度为 \(N\) 的向量。若初始向量与真实解的分解中第二特征向量成分不为 0,误差主项近似按 \(|\lambda_2|^k\) 衰减;因此 \(d=0.95\) 往往比 \(d=0.85\) 需要更多轮。实际图上是否接近上界,要看图的谱结构,而不是只看节点数。
Gauss-Seidel 迭代把本轮已经更新过的坐标立即用于后续坐标,常能减少轮数,但一轮内部存在顺序依赖,不像 Jacobi 式幂迭代那样容易并行。本文脚本把每轮开始时的悬挂质量固定,然后按顶点编号原地更新并归一化,因此它是一个工程近似迭代器,不是 Spark / NetworkX 的默认接口。
三、个性化 PageRank、局部 push 与 Monte Carlo
把均匀重启向量换成任意概率分布 \(\boldsymbol{v}\),就得到个性化 PageRank(personalized PageRank, PPR):
\[ \boldsymbol{r}_s=dP\boldsymbol{r}_s+(1-d)\boldsymbol{e}_s \]
是单源 PPR 的常见写法。它不再回答“全局哪个页面重要”,而是回答“从源点 \(s\) 周围出发,哪些点更容易被带重启的随机游走访问”。Jeh 与 Widom 2003 年 WWW 论文研究了可扩展的 personalized web search;Haveliwala 2002 年 WWW / 2003 年 TKDE 的 Topic-Sensitive PageRank 则预计算多个主题向量,查询时线性组合。
Andersen、Chung、Lang 在 FOCS 2006 用 PPR 向量做局部图划分。它的 push 算法维护两个向量:已确定的估计 \(\boldsymbol{p}\) 与残差 \(\boldsymbol{r}\)。当某个点 \(u\) 的残差密度 \(r(u)/\deg(u)\) 高于阈值 \(\epsilon\) 时,把 \((1-d)r(u)\) 留在 \(p(u)\),其余 \(dr(u)\) 沿边推给邻居;所有点残差密度都低于阈值后停止。工作量用 push 次数衡量,通常只和源点附近的低导通区域有关,而不是整图规模。
Monte Carlo 方法从另一端近似 PageRank:重复模拟随机游走,统计停点频率。若每条 walk 从均匀起点出发,并以概率 \(1-d\) 停止、以概率 \(d\) 走一条出边,则停点分布就是标准 PageRank。Avrachenkov、Litvak、Nemirovsky、Osipova 2007 年 SIAM J. Numer. Anal. 论文系统分析了 PageRank 的 Monte Carlo 估计。它的优点是天然并行、可以在线更新;缺点是低 rank 节点需要大量样本才能稳定。
四、生产实现:同名 PageRank 不一定同尺度
版本相关的默认值必须钉源码,否则很容易把两个实现的结果错当成同一口径。
| 项目与版本 | 入口 | 默认阻尼 / 重启 | 停止条件与归一化 | 悬挂节点处理 |
|---|---|---|---|---|
| NetworkX 3.3 | networkx/algorithms/link_analysis/pagerank_alg.py::pagerank |
alpha=0.85 |
max_iter=100,tol=1e-6,实际判断
err < N * tol |
dangling=None 时使用
personalization,默认均匀 |
| Spark GraphX 3.5.3 | graphx/.../lib/PageRank.scala |
参数名 resetProb=0.15,即继续走边概率 \(0.85\) |
固定迭代
run;runUntilConvergence 用 Pregel
delta;runWithOptions 自 3.2 可
normalized=true |
sink 会造成 rank sum 偏差,源码注释
SPARK-18847 后调用
normalizeRankSum |
| igraph C 0.10.13 | src/centrality/prpack.cpp |
damping 由调用者给出 |
PRPACK 解线性系统,容差
1e-10;返回特征值固定为 1 |
reset 向量先归一;sink restart 与 damping restart 默认同一分布 |
NetworkX 的 google_matrix
文档还提醒:若要唯一收敛,转移矩阵需要不可约;dangling
字典最好和 personalization 一致。GraphX
源码顶部的注释明确写着早期算法不是 normalized
PageRank,且“没有入链的页面 rank 为
alpha”;这和概率分布尺度不同。跨库比较前应先统一三件事:阻尼参数含义、rank
总和、dangling 目标分布。
五、可复现实验:阻尼、迭代器与近似误差
实验脚本只依赖 Python、NumPy 和 matplotlib;若要额外对照
NetworkX 3.3,可把环境变量 NETWORKX_SRC
指向对应源码目录,否则脚本会尝试使用已安装的
networkx,不可用时跳过对照:
cd <repo-root>
taskset -c 14 python3 \
  post/algorithms/49-pagerank/reproduce/pagerank_experiment.py \
  --n 360 --seed 7 --tol 1e-10
环境记录:Linux 6.6.87.2-microsoft-standard-WSL2,Intel
Core i9-12900K,taskset -c 14,NumPy
2.5.3,matplotlib 3.11.2。合成图是固定 seed 的 directed
BA-like 图:\(N=360\),\(|E|=1360\),其中 33
个节点被设为悬挂节点。本次复核把 NETWORKX_SRC
指向 NetworkX 3.3 源码,并调用其纯 Python PageRank
实现;与本文幂迭代在 \(d=0.85\) 下的 \(L_1\) 差异为 \(1.25\times 10^{-10}\)。
阻尼因子与迭代次数
| 方法 | \(d\) | 迭代次数 | 最终 \(L_1\) 残差 | 相对稠密精确解的 \(L_1\) 误差 |
|---|---|---|---|---|
| power | 0.50 | 21 | \(4.29\times 10^{-11}\) | \(1.35\times 10^{-11}\) |
| power | 0.70 | 30 | \(8.85\times 10^{-11}\) | \(3.07\times 10^{-11}\) |
| power | 0.85 | 42 | \(7.22\times 10^{-11}\) | \(2.74\times 10^{-11}\) |
| power | 0.90 | 47 | \(8.70\times 10^{-11}\) | \(3.43\times 10^{-11}\) |
| power | 0.95 | 54 | \(7.34\times 10^{-11}\) | \(2.96\times 10^{-11}\) |
| Gauss-Seidel | 0.85 | 24 | \(7.61\times 10^{-11}\) | \(4.82\times 10^{-11}\) |
这张图不是最坏情况图,所以 \(d=0.95\) 只比 \(d=0.85\) 多 12 轮;但趋势仍然清楚:阻尼越大,残差下降越慢。Gauss-Seidel 在同一阈值下轮数更少,代价是单轮更新顺序更难并行。
局部 push 与 Monte Carlo 的误差—工作量曲线
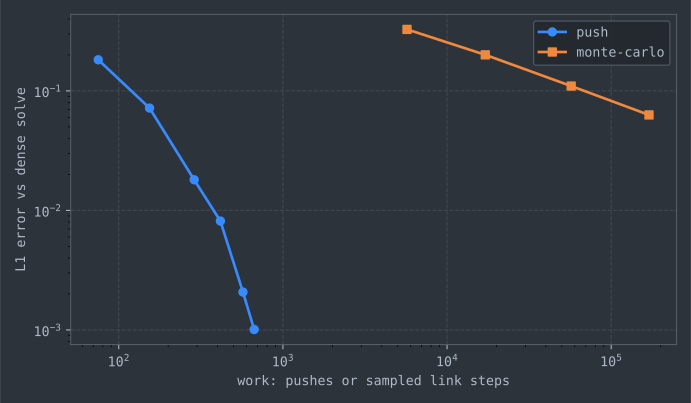
| 方法 | 参数 | 工作量 | 相对精确解的 \(L_1\) 误差 |
|---|---|---|---|
| push | \(\epsilon=3\times10^{-3}\) | 75 pushes | 0.1821 |
| push | \(\epsilon=10^{-3}\) | 154 pushes | 0.0718 |
| push | \(\epsilon=3\times10^{-4}\) | 288 pushes | 0.0180 |
| push | \(\epsilon=10^{-4}\) | 416 pushes | 0.0081 |
| push | \(\epsilon=3\times10^{-5}\) | 571 pushes | 0.0021 |
| push | \(\epsilon=10^{-5}\) | 668 pushes | 0.0010 |
| Monte Carlo | 1,000 walks,3 seeds 中位数 | 5,700 sampled link steps | 0.3269 |
| Monte Carlo | 3,000 walks,3 seeds 中位数 | 17,092 sampled link steps | 0.2002 |
| Monte Carlo | 10,000 walks,3 seeds 中位数 | 57,014 sampled link steps | 0.1097 |
| Monte Carlo | 30,000 walks,3 seeds 中位数 | 169,876 sampled link steps | 0.0629 |
push 表里误差几乎等于剩余残差总量,这是算法不变量的体现;阈值降到 \(10^{-5}\) 时,几百次局部 push 已经把单源 PPR 的 \(L_1\) 误差压到 \(10^{-3}\) 量级。Monte Carlo 的误差随样本数增加下降,但在这个小图上要用远多于 push 的 sampled link steps 才接近同一误差。它并不“差”,只是服务不同场景:采样适合高度并行、流式更新和只关心高 rank 节点的估计。
SNAP 的 web-Google 数据集页面给出 875,713
个节点、5,105,039 条边,下载地址是
https://snap.stanford.edu/data/web-Google.txt.gz。可用
curl -L -o web-Google.txt.gz https://snap.stanford.edu/data/web-Google.txt.gz && sha256sum web-Google.txt.gz
下载并记录校验值;当前网络在 30 秒内下载超时,因此本文不报告
web-Google 实测数字,避免把不完整数据写成 benchmark。
六、谱系:PageRank 不是孤立发明
PageRank 属于谱排序和链接分析的一条长线。Katz 1953 年在 sociometric analysis 中提出的 status index 已经把“从重要节点收到连接会提高自身分数”写成线性方程;Kleinberg 的 HITS 在 1999 年 JACM 论文中把网页分成 authority 与 hub 两个互相强化的分数,并在查询相关子图上计算主特征向量。PageRank 的工程分叉点是把查询无关的全图随机游走预先算好,并用重启机制解决 sink 与不可约性。
Langville 与 Meyer 2005 年 SIAM Review 综述把 HITS、PageRank、SALSA 等方法统一到特征向量计算框架;他们 2006 年的书 Google’s PageRank and Beyond 系统讨论了线性系统、幂法、外推、块结构与 spam 问题。今天的 Personalized PageRank、局部聚类、图推荐和随机游走 embedding 都可以看成这条谱系的不同取舍:全局稳定性、局部性、可解释性和计算成本之间没有免费午餐。
关于 Google 当今排序中的 PageRank,只能说公开资料支持的有限结论。Google Search Central 的 ranking systems guide 写明:Google 有多种理解页面链接关系的系统,PageRank 是 Google 初创时使用的核心 ranking systems 之一,工作方式已经演化很多,并且仍然是 core ranking systems 的一部分。这个说法不能推出“PageRank 仍占某个权重”或“某次泄露字段等于真实排序公式”。2024 年 API 文档泄露报道最多只能作为 C 级线索,不能支撑本文的算法结论。
七、实现时最容易踩的坑
- 把行随机和列随机混用。本文公式用列随机矩阵,代码若用
x @ A就是在行随机约定下左乘;两者都可以,但边方向、dangling 列和转置必须一致。 - 忽略尺度。\((1-d)\) 与 \((1-d)/N\) 只差一个总量尺度,但停止条件、误差和跨库比较都会受影响。
- dangling 与 personalization 不一致。标准 PageRank 用均匀重启,PPR 常用源点重启;把 sink 均匀分配会改变局部 PPR 的含义。
- 把残差阈值当排名误差。
||x_{k+1}-x_k||_1是迭代残差,不等于相对精确解的误差;本文表格同时列出两者,是为了避免这个混淆。 - 重复边和权重没有定义清楚。NetworkX 对 weighted 图会先做随机化归一;MultiDiGraph 的多条边相当于权重求和。爬虫数据是否去重会直接改变投票强度。
- 分布式结果不完全可复现。浮点加法不满足结合律;GraphX 这类分布式聚合在分区和消息顺序变化时可能出现最后几位差异,应比较容差内的向量或 top-k 稳定性。
PageRank 的价值不在于“搜索引擎的唯一秘密”,而在于它给了一个可检查的工程范式:先把局部链接规则写成随机过程,再用矩阵和残差定义全局结果,最后把尺度、边界节点和误差口径钉到代码里。
八、参考资料
论文与书
- Sergey Brin, Lawrence Page, “The anatomy of a
large-scale hypertextual Web search engine,” Computer
Networks and ISDN Systems, 30(1-7):107-117, 1998. DOI:
10.1016/S0169-7552(98)00110-X。 - Lawrence Page, Sergey Brin, Rajeev Motwani, Terry Winograd, “The PageRank Citation Ranking: Bringing Order to the Web,” Stanford InfoLab Technical Report 1999-66 / SIDL-WP-1999-0120, 1999。
- Taher H. Haveliwala, “Topic-sensitive PageRank,”
Proceedings of WWW 2002, pp.517-526. DOI:
10.1145/511446.511513。 - Taher H. Haveliwala, Sepandar D. Kamvar, “The Second Eigenvalue of the Google Matrix,” Stanford Technical Report, 2003。
- Amy N. Langville, Carl D. Meyer, “A Survey of
Eigenvector Methods for Web Information Retrieval,” SIAM
Review, 47(1):135-161, 2005. DOI:
10.1137/S0036144503424786。 - Amy N. Langville, Carl D. Meyer, Google’s PageRank and Beyond: The Science of Search Engine Rankings, Princeton University Press, 2006。
- Reid Andersen, Fan Chung, Kevin Lang, “Local Graph
Partitioning using PageRank Vectors,” FOCS 2006,
pp.475-486. DOI:
10.1109/FOCS.2006.44。 - K. Avrachenkov, N. Litvak, D. Nemirovsky, N. Osipova,
“Monte Carlo methods in PageRank computation: When one
iteration is sufficient,” SIAM Journal on Numerical
Analysis, 45(2):890-904, 2007. DOI:
10.1137/050643799。 - Jon M. Kleinberg, “Authoritative Sources in a Hyperlinked Environment,” Journal of the ACM, 46(5):604-632, 1999。
- Leo Katz, “A new status index derived from sociometric analysis,” Psychometrika, 18:39-43, 1953。
源码与文档
- NetworkX 3.3,
networkx/algorithms/link_analysis/pagerank_alg.py,pagerank、google_matrix、_pagerank_scipy。 - Apache Spark 3.5.3 GraphX,
graphx/src/main/scala/org/apache/spark/graphx/lib/PageRank.scala。 - igraph 0.10.13,
src/centrality/prpack.cpp,igraph_i_personalized_pagerank_prpack。 - Google Search Central, “A guide to Google Search ranking systems,” section “Link analysis systems and PageRank”。
- SNAP, “Google web graph,”
https://snap.stanford.edu/data/web-Google.html。
实验
post/algorithms/49-pagerank/reproduce/pagerank_experiment.py:生成合成图,运行幂迭代、Gauss-Seidel、ACL 风格 push、Monte Carlo,并生成power-iteration.svg、work-error.svg与reproduce/results/*.csv。
上一篇:拓扑排序:依赖解析的顺序与环 下一篇:图着色与寄存器分配:从 DSatur 到 Chaitin-Briggs 相关阅读: - 最小生成树:割性质、Kruskal/Prim/Borůvka 与线性时间开放问题 - 竞争分析与在线算法 - HNSW:分层小世界图的近似近邻搜索
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。
基数排序:绕开比较下界的代价,从 LSD、American flag sort 到 ska_sort
比较下界只约束比较模型,基数排序把代价转移到键长和内存访问上。本文推导代价模型,用缓存模拟与绑核实测解释位宽为何停在 8 到 11 位,并对照 ska_sort、ClickHouse、DuckDB 与 IPS²Ra 说明它何时赢、何时输。