关于 Join 算法,常见的说法有四种:“Grace hash join 的代价是 \(3(M+N)\)”、“hash join 总比 sort-merge 快”、“sort-merge 有最坏情况保证”、“内存里做 radix 分区能快好几倍”。每一句都要加条件才成立。\(3(M+N)\) 只在内存刚好够分区时成立,内存再多,hybrid hash 就能把代价一路降到 \(M+N\)。Shapiro(1986)证明 hybrid 在他的模型里优于 sort-merge,但 Graefe 等人(1994)的结论是两者差的是百分比,不是倍数。sort-merge 碰上大量重复键会退化成嵌套循环。radix 分区的收益则取决于哈希表比末级缓存大多少,而且在完整系统里很少兑现(Bandle et al. 2021)。
本文先用一个真正执行连接、同时统计页读写次数的模拟器,把几种经典算法的 I/O 代价放在同一组参数下比较;再用图讲清 build/probe、分区、hybrid 的内存布局和溢出递归;然后对照 PostgreSQL 17(REL_17_9)与 MySQL 8.4(8.4.9)源码,看工业实现在哪些地方偏离教科书;最后复现内存中 hash join 的”分区还是不分区”之争。多路连接与 worst-case optimal join、分布式 shuffle 以及连接顺序选择不在本文范围内,连接顺序见下一篇查询优化器。
一、问题与代价模型
符号与记账口径
讨论等值连接(equi-join)\(R \bowtie_{R.a = S.b} S\),约定 \(R\) 是较小的一侧,也就是哈希连接的构建侧(build side),\(S\) 是探测侧(probe side)。
| 符号 | 含义 |
|---|---|
| \(b_R, b_S\) | \(R\)、\(S\) 占用的页数(Shapiro 记作 \(\lvert R\rvert, \lvert S\rvert\)) |
| \(n_R, n_S\) | 元组数 |
| \(M\) | 分给连接算子的内存页数(Shapiro 记作 \(\lvert M\rvert\)) |
| \(F\) | 哈希表相对原始数据的膨胀系数(fudge factor),Shapiro 取 \(1.4\) |
代价只数页 I/O。这里有一个容易混淆的口径差异:Shapiro(1986)和 DeWitt 等人(1984)的公式不计 \(R\)、\(S\) 的初始读取,也不计结果输出,因为这两项对所有算法都一样;数据库教科书(例如 Ramakrishnan & Gehrke)通常计入初始读取。同一个 Grace hash join,在前一种口径下是 \(2(b_R+b_S)\),在后一种口径下是 \(3(b_R+b_S)\)。本文采用教科书口径,所有公式和模拟结果都包含初始读取、不含结果输出;换成 Shapiro 的口径,减去 \(b_R+b_S\) 即可。
模拟器
reproduce/join_io_sim.c
把每个算法完整实现一遍,真正算出连接结果,并与不限内存的哈希连接逐一核对结果条数和校验和;同时用一个简单的”磁盘”计数页读写:
- 一个关系或临时文件有 \(t\) 个元组,就占 \(\lceil t/P \rceil\) 页,\(P=32\);每个临时文件通过自己的 1 页输出缓冲写出。
- \(M\) 页内存不含 1 页输入缓冲;\(x\) 页数据建成哈希表需要 \(F x\) 页。
- 负载:\(b_R = 1000\)、\(b_S = 4000\)。\(R\) 的连接键是打乱后的 \(0..n_R-1\)(主键),\(S\) 的连接键在 \([0, n_R)\) 上均匀随机(外键),结果 128,000 行。
cd reproduce
gcc -O2 -Wall -Wextra -o join_io_sim join_io_sim.c -lm
./join_io_sim              # 下表与第五节倾斜实验
./join_io_sim csv > io.csv # M = 20, 30, ..., 1450 的密集扫描
/tmp/mplenv/bin/python plot_io.py io.csv ../join-io-vs-memory.svg
模拟器使用固定随机种子:连续运行 3 次,以及用
-fsanitize=address,undefined
编译后运行,输出逐字节一致。
二、嵌套循环:元组、块与索引
元组与页嵌套循环
最直接的嵌套循环连接(Nested Loop Join,NLJ)对 \(R\) 的每个元组扫一遍 \(S\),代价 \(b_R + n_R\, b_S\);按页而不是按元组驱动内层扫描,代价降为 \(b_R + b_R\, b_S\)。它唯一的优点是对连接条件没有任何要求:不等值条件、函数条件都能算。
块嵌套循环
块嵌套循环(Block Nested Loop Join,BNLJ)一次把 \(R\) 的 \(M\) 页读进内存,然后扫一遍 \(S\):
\[ \mathrm{cost}_{\mathrm{BNLJ}} = b_R + \left\lceil \frac{b_R}{M} \right\rceil b_S . \]
外层必须是小表:\(S\) 被扫描的次数由 \(b_R/M\) 决定。模拟器里的两种变体都属于这一类:朴素 BNLJ 的块就是 \(M\) 页原始元组,块内逐对比较;“哈希块”变体给块建一张哈希表,CPU 代价低得多,但每块只能装 \(M/F\) 页,\(S\) 要多扫几次。\(M=200\) 时朴素 BNLJ 是 21,000 次页 I/O,哈希块是 33,000 次。\(M \ge b_R\) 时 BNLJ 退化成一次读完两张表,5,000 次,这时它就是内存中的经典哈希连接。
索引嵌套循环
索引嵌套循环(Index Nested Loop Join,INLJ)在内层连接列有索引时,对外层每个元组做一次索引查找:
\[ \mathrm{cost}_{\mathrm{INLJ}} = b_R + n_R \cdot C_{\mathrm{probe}} . \]
\(C_{\mathrm{probe}}\) 取决于 B+ 树高度、索引是否聚簇、匹配行数和缓冲池命中率,不存在通用常数。INLJ 的价值在于它与 \(b_S\) 无关:外层经过过滤只剩几十行时,它比任何需要完整扫描 \(S\) 的算法都便宜,这也是 OLTP 查询计划里最常见的连接方式,PostgreSQL 规划器如何在它和另外两种方式之间选择,见PG 内核:Join 顺序与路径生成。
三、排序归并连接
外部排序与最后一趟归并合并
排序归并连接(Sort-Merge Join,SMJ)先把两边按连接键排序,再同步扫描。排序阶段就是外部排序:先生成有序段(run),再多路归并。关键的优化是不把排好的结果写回磁盘:两边的最后一趟归并同时进行,归并出来的元组直接送去比较。这要求两边剩下的有序段加起来不超过内存页数。
用”读满 \(M\) 页、排序、写出”的方法生成有序段,每段 \(M\) 页,条件是
\[ \left\lceil \frac{b_R}{M} \right\rceil + \left\lceil \frac{b_S}{M} \right\rceil \le M \quad\Longleftrightarrow\quad M \gtrsim \sqrt{b_R + b_S} . \]
用置换选择(replacement selection)生成的有序段平均长 \(2M\),条件放宽到 \(M \gtrsim \sqrt{(b_R+b_S)/2}\);因为 \(b_S \ge b_R\),这不超过 \(\sqrt{b_S}\),Shapiro 的前提”\(\lvert M\rvert \ge \sqrt{\lvert S\rvert}\)“就是这么来的。满足条件时
\[ \mathrm{cost}_{\mathrm{SMJ}} = 3(b_R + b_S), \]
即读一遍、写有序段、读有序段;每多一趟中间归并,被归并的那张表再加 \(2b\)。模拟器用前一种生成方法,阈值是 \(\sqrt{5000} \approx 70.7\):\(M=71\) 时 \(R\) 有 15 段、\(S\) 有 57 段,共 72 段,多出一段就要多一趟归并,代价从 15,000 跳到 23,000。
PostgreSQL
在代价估算里专门照顾了这一点。final_cost_mergejoin()(src/backend/optimizer/path/costsize.c)的注释写道,如果内层排序预计会溢出到磁盘,就强制在它上面加
Material 节点,“because the final merge pass can be done
on-the-fly if it doesn’t have to support
mark/restore”:内层要支持回退(见下一小节),而实时归并的输出无法回退。
重复键与 mark/restore
归并阶段遇到两边都有重复键时,外层每出现一个相同的键,内层就要回到这组相同键的开头重新扫一遍。PostgreSQL
17 的 src/backend/executor/nodeMergejoin.c 用
11
个状态实现这个过程,文件头注释给出了骨架:SKIP_TEST
在两边键相等时对内层
ExecMarkPos(),JOINTUPLES/NEXTINNER
输出这一组,NEXTOUTER 之后由
TESTOUTER
判断新的外层键是否等于标记处的键,是就
ExecRestrPos() 回到标记。
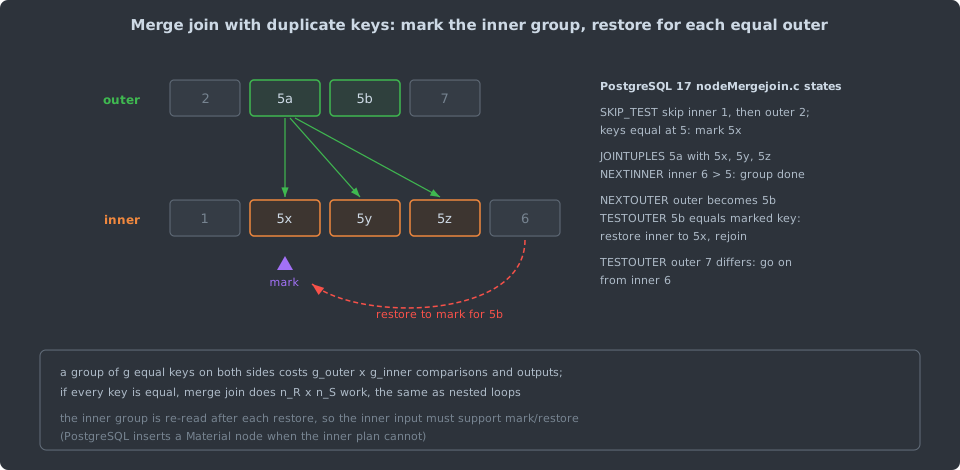
一组有 \(g_R\) 个和 \(g_S\) 个相同键时,这一组的比较和输出都是 \(g_R\, g_S\)。极端情况下所有键都相同,SMJ 就做了 \(n_R\, n_S\) 次比较,和嵌套循环一样。“SMJ 有最坏情况保证”只对排序阶段成立;Shapiro 的分析也明确假设”\(S\) 的一个元组最多与 \(R\) 的一个块匹配”。回退要求内层能重新读,内层计划节点本身不支持 mark/restore 时,PostgreSQL 必须插入 Material 节点(同一函数里的注释:“materialization is required for correctness in this case”)。
SMJ 的另一个价值是输出有序。System R(Selinger et
al. 1979)把这类对后续算子有用的顺序称为 interesting
order:后面的 ORDER BY、GROUP BY
或下一个归并连接都能复用,这在选择计划时会抵消一部分排序代价。
四、哈希连接:经典、Grace 与 Hybrid
经典哈希连接
经典哈希连接分两个阶段:用小表 \(R\) 建哈希表(build),再把 \(S\) 流过去逐个探测(probe)。
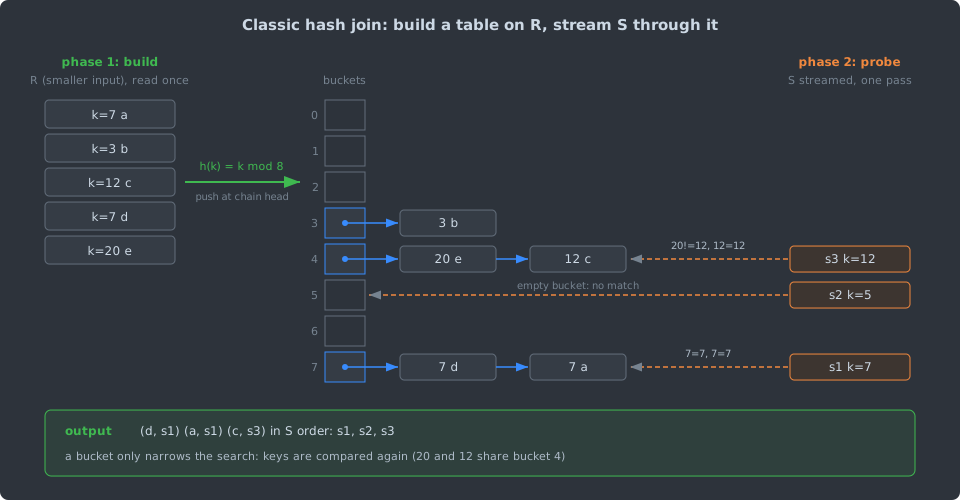
图中要注意两点。第一,同一个桶里可能有不同的键(20 和 12 都落在桶 4),探测时必须再比较完整的键。第二,输出顺序跟随探测侧,所以哈希连接能以流水线方式输出,但不保留构建侧的任何顺序。只要 \(F b_R \le M\),代价就是 \(b_R + b_S\),任何算法都不可能更少。
Grace 哈希连接
构建侧放不下时,先用哈希函数 \(h_1\) 把两边都切成 \(k\) 个分区,保证匹配的元组落在编号相同的分区里,再对每一对 \((R_i, S_i)\) 做经典哈希连接,这时要换一个与 \(h_1\) 无关的哈希函数 \(h_2\) 建表。
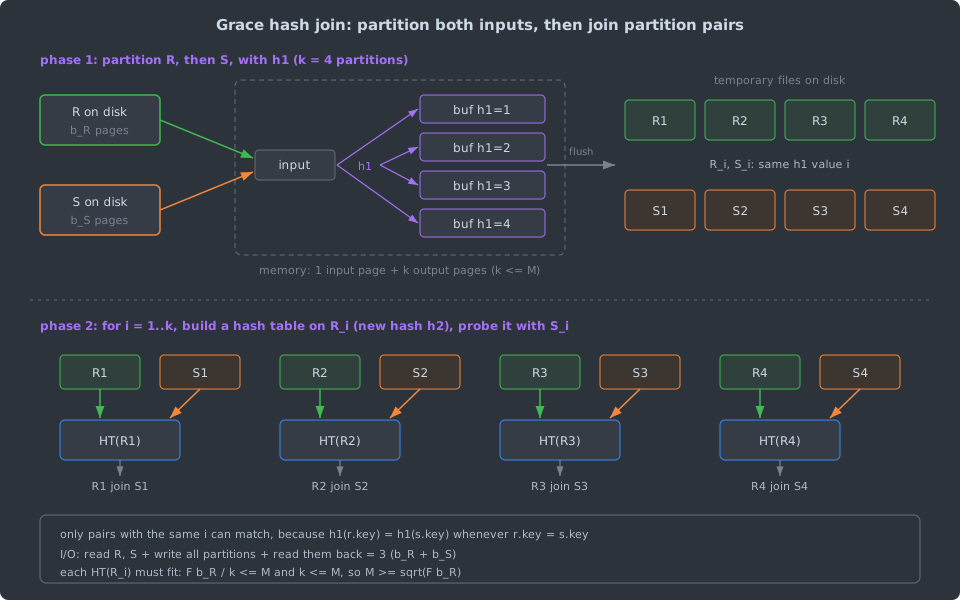
这一方法来自东京大学的 GRACE 数据库机(Kitsuregawa, Tanaka, Moto-oka, New Generation Computing 1983)。按 Shapiro(1986)第 2.4 节的描述,GRACE 机器的第二阶段用硬件排序器对每对分区做 sort-merge,今天通行的”Grace hash join”第二阶段改用哈希,这是 Shapiro 的版本。他特别指出这样做的一个好处:“subsets of S can be of arbitrary size. Only R needs to be partitioned into subsets of approximately equal size”,因为分区溢出是个大问题(见第五节)。
分区阶段每个分区占 1 页输出缓冲,所以 \(k \le M\);第二阶段每个 \(R_i\) 的哈希表要放进内存,所以 \(F b_R / k \le M\)。两式合起来得到
\[ M \ge \sqrt{F\, b_R}, \qquad \mathrm{cost}_{\mathrm{Grace}} = 3(b_R + b_S). \]
分区条件只与构建侧有关,这是哈希连接比 SMJ 的 \(\sqrt{b_R+b_S}\) 宽松的地方。Shapiro 的 GRACE 只用 \(\sqrt{F\lvert R\rvert}\) 页做分区,多余的内存用来缓存部分分区,省下 \(2\min(\lvert R\rvert+\lvert S\rvert,\ \lvert M\rvert-\sqrt{F\lvert R\rvert})\) 次 I/O;本文模拟器实现的是固定 \(k=\lceil\sqrt{F b_R}\rceil\)、不缓存的教科书版本,所以它的曲线在阈值以上是平的。
Hybrid 哈希连接
Hybrid hash join 由 DeWitt、Katz、Olken、Shapiro、Stonebraker、Wood 在 SIGMOD 1984 提出,Shapiro 1986 做了完整分析。思路是:分区阶段只拿出刚好够用的 \(B\) 页做输出缓冲,其余内存直接给分区 0 建哈希表。\(R_0\) 在扫描 \(R\) 时就进了哈希表,\(S_0\) 在扫描 \(S\) 时当场探测,这两部分永远不落盘。
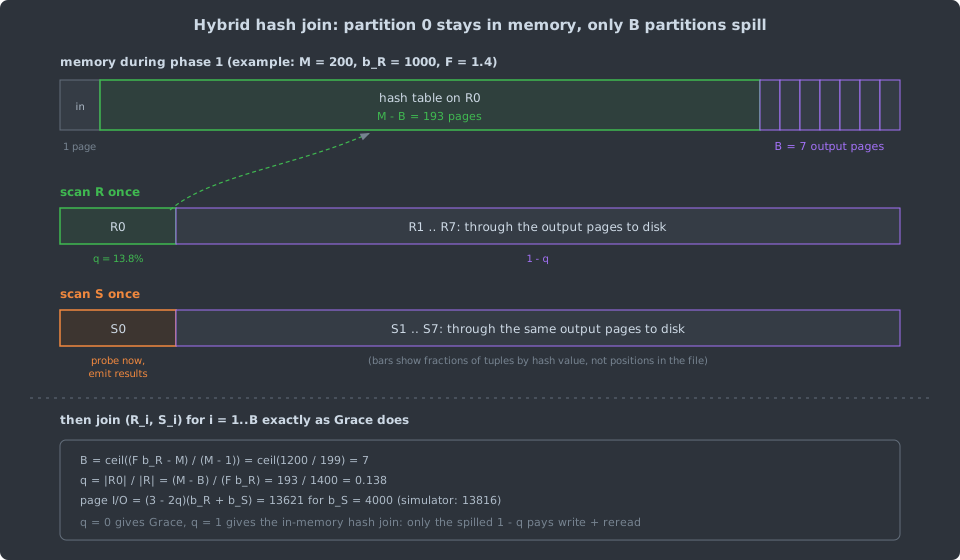
\(B\) 的推导只需要两个约束:内存装得下 \(R_0\) 的哈希表加 \(B\) 页缓冲,每个溢出分区之后也能放进内存:
\[ F\,\lvert R_0\rvert + B = M, \qquad F\,\frac{b_R - \lvert R_0\rvert}{B} = M . \]
消去 \(\lvert R_0\rvert\) 得到 DeWitt 等人给出的
\[ B = \max\left(0,\ \left\lceil \frac{F\, b_R - M}{M - 1} \right\rceil\right), \qquad q = \frac{\lvert R_0\rvert}{b_R} = \frac{M - B}{F\, b_R} . \]
假设 \(S_0\) 占 \(S\) 的比例也是 \(q\),只有比例为 \(1-q\) 的数据要写出再读回:
\[ \mathrm{cost}_{\mathrm{Hybrid}} = (3 - 2q)(b_R + b_S). \]
Shapiro 的写法是 \(2(\lvert R\rvert+\lvert S\rvert)(1-q)\),差别就是那一项初始读取。\(q=0\) 时它就是 Grace,\(q=1\) 时就是经典哈希连接。有一种流传的写法把 \(q\) 写成 \(1/k\)(\(k\) 为分区数),那是”所有分区等大、分区 0 恰好是其中一个”的实现,后面会看到 PostgreSQL 正是这样,但这不是 DeWitt 与 Shapiro 的 hybrid:他们的 \(R_0\) 可以远大于其他分区。
Shapiro 证明 hybrid 的 I/O 不多于他的 GRACE,关键不等式是 \(q(\lvert R\rvert+\lvert S\rvert) > \lvert M\rvert - \sqrt{F\lvert R\rvert}\):同样一页多余的内存,GRACE 用来缓存一页分区数据,只省 2 次 I/O;hybrid 用来多装 \(1/F\) 页 \(R_0\),同时带走比例相同的 \(S_0\),省下约 \(2(b_R+b_S)/(F b_R)\) 次。本文参数下后者是前者的 \(5000/1400 \approx 3.6\) 倍。
模拟结果
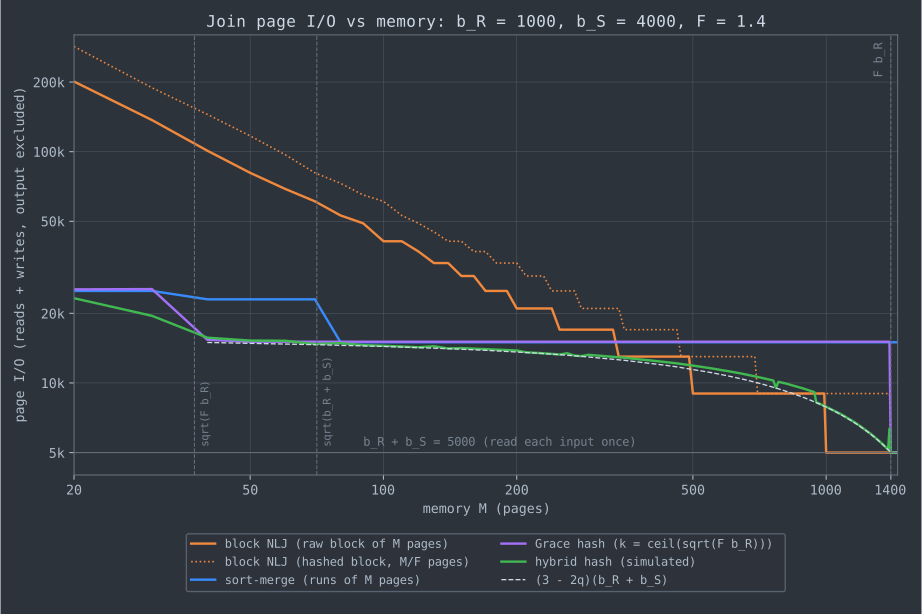
选取几个内存点(全部数字来自
./join_io_sim):
| \(M\) | BNLJ | BNLJ 哈希块 | SMJ | SMJ 额外趟数 | Grace | Hybrid | \((3-2q)(b_R+b_S)\) | \(q\) |
|---|---|---|---|---|---|---|---|---|
| 20 | 201,000 | 285,000 | 25,000 | 2 | 25,392 | 23,250 | 不适用 | 不适用 |
| 38 | 109,000 | 149,000 | 23,000 | 1 | 17,402 | 15,516 | 14,993 | 0.001 |
| 50 | 81,000 | 117,000 | 23,000 | 1 | 15,074 | 15,250 | 14,843 | 0.016 |
| 71 | 61,000 | 81,000 | 23,000 | 1 | 15,074 | 15,206 | 14,629 | 0.037 |
| 100 | 41,000 | 61,000 | 15,000 | 0 | 15,074 | 14,482 | 14,386 | 0.061 |
| 200 | 21,000 | 33,000 | 15,000 | 0 | 15,074 | 13,816 | 13,621 | 0.138 |
| 500 | 9,000 | 13,000 | 15,000 | 0 | 15,074 | 11,884 | 11,443 | 0.356 |
| 700 | 9,000 | 9,000 | 15,000 | 0 | 15,074 | 10,622 | 10,014 | 0.499 |
| 1000 | 5,000 | 9,000 | 15,000 | 0 | 15,074 | 7,890 | 7,864 | 0.714 |
| 1400 | 5,000 | 5,000 | 15,000 | 0 | 5,000 | 5,000 | 5,000 | 1.000 |
几点观察:
- 两个平方根阈值都兑现了。 哈希类在 \(\sqrt{F b_R} \approx 37.4\) 以下需要递归分区(\(M=20\) 时 Grace 递归到第 2 层),SMJ 在 \(\sqrt{b_R+b_S} \approx 70.7\) 以下多一趟归并。Grace 的 15,074 比 \(3 \times 5000\) 多 74 页,来自每个分区最后一页没写满。
- Hybrid 贴着公式走,但会被方差咬一口。 模拟值比 \((3-2q)\) 公式高 0.3% 到 6%。\(M=50\) 和 \(71\) 时 hybrid 反而比 Grace 还差:\(B\) 是按”每个溢出分区恰好装满内存”算出来的,哈希分布的随机波动让一部分分区超出一点,于是再递归一层。DeWitt 等人对此的回答是”if we err slightly we can always apply the hybrid hash join recursively”,工程实现则通常给分区留余量。密集扫描里 \(M=1390\) 处还有一个跳变(6,344 对公式的 5,079),那是模拟器处理分区 0 溢出的粒度太粗(一次把分区 0 的哈希范围缩小 1/8)造成的,属于实现细节而不是算法性质。
- 内存足够大时,“读两遍 \(S\)”比 hybrid 便宜。 \(M=700\) 时哈希块 BNLJ 只要 9,000 次(\(R\) 分两块,\(S\) 扫两遍),hybrid 要 10,622 次。MySQL 源码的注释提到了同一件事,见第六节。
- SMJ 在这个负载上从不占优,与 Shapiro 的结论一致;它的优势来自输入已经有序、需要有序输出、或者重复键很少而构建侧倾斜严重的场景,页 I/O 模型里体现不出来。
五、溢出、倾斜与递归分区
分区溢出
\(B\) 和 \(k\) 都是按”分区大小均匀”算的。某个分区超出内存时,Shapiro 1986 第 4 节讨论了两种处理:还在内存里的分区 0 可以把一部分桶挪出去,变成一个新的溢出分区;已经写到磁盘的分区只能换一个哈希函数再分一次。模拟器两种都实现了:分区 0 在读 \(S\) 之前检查,超了就把哈希范围缩小并把挪出的元组写成额外分区;磁盘分区递归调用自身,每一层换一个种子。递归一层的额外代价是把这对分区再写一遍、读一遍,即 \(2(\lvert R_i\rvert + \lvert S_i\rvert)\)。
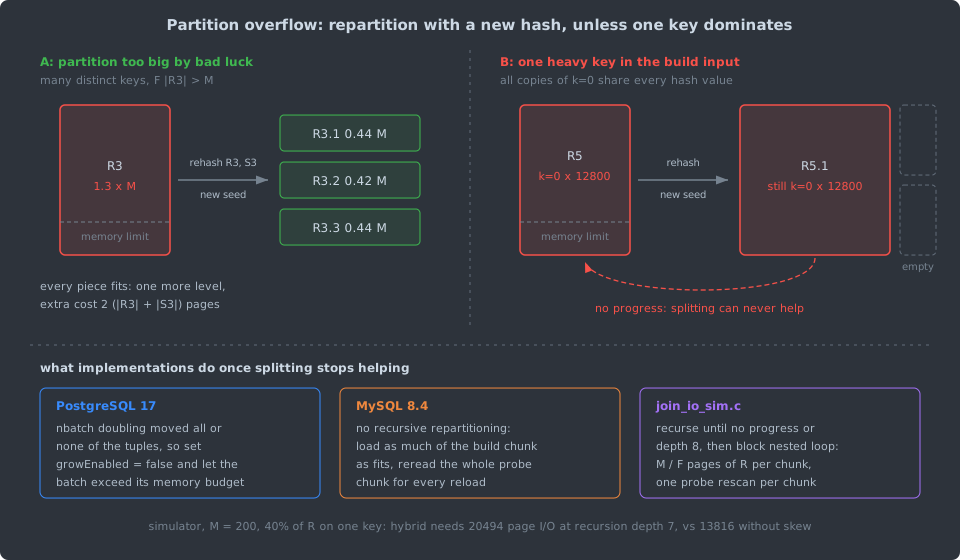
构建侧重键:拆分无效
图中 B 是递归分区解决不了的情形:同一个键的所有副本有相同的哈希值,换多少次种子都会落在同一个分区。模拟器让 \(R\) 中比例为 \(h\) 的元组共享键 0(\(M=200\),其余参数不变):
| \(h\) | Grace I/O | 递归深度 | 回扫次数 | Hybrid I/O | 递归深度 | 回扫次数 |
|---|---|---|---|---|---|---|
| 0.00 | 15,072 | 1 | 0 | 13,816 | 1 | 0 |
| 0.02 | 15,072 | 1 | 0 | 13,644 | 1 | 0 |
| 0.05 | 15,074 | 1 | 0 | 13,962 | 2 | 0 |
| 0.10 | 15,076 | 1 | 0 | 14,534 | 2 | 0 |
| 0.20 | 17,041 | 4 | 1 | 16,882 | 6 | 1 |
| 0.40 | 18,658 | 4 | 2 | 20,494 | 7 | 2 |
\(h=0.40\) 时 12,800 个相同键的元组占 \(12800 \times 1.4 / 32 = 560\) 页,远超 \(M=200\)。热键所在的分区每递归一层只能甩掉少量其他键,直到只剩热键,模拟器才判定”没有进展”,改用分块嵌套循环:每次装 \(M/F\) 页 \(R\),把对应的 \(S\) 分区重扫一遍(表中的”回扫次数”)。hybrid 的每层扇出(\(B=7\))比 Grace(\(k=38\))小,所以热键分区要递归更多层才能剥干净,I/O 反而比 Grace 高。\(h \le 0.10\) 时的小幅波动来自哪一段哈希范围落进了 \(R_0\),不必过度解读。
探测侧倾斜:PostgreSQL 的 skew 优化
另一类倾斜在探测侧:\(S\)
里少数几个值出现得极多。PostgreSQL
对此有专门的优化,src/include/executor/hashjoin.h
的注释说明了做法:取外表(探测侧)连接键的最常见值(MCV)统计,把与这些值哈希相同的内表元组放进单独的
skew 哈希表,于是外表中这些值的元组”are effectively handled
as part of the first batch and will never go to disk”。skew
表最多占连接内存的
SKEW_HASH_MEM_PERCENT(2%);ExecHashBuildSkewHash()
在 MCV 频率之和不到
SKEW_MIN_OUTER_FRACTION(0.01)时放弃。注释解释了为什么看外表统计:外表通常更大,优化它的常见值省下的
I/O 更多。这个优化只在非并行路径、且初始批次数大于 1
时启用(ExecHashTableCreate() 中的
if (nbatch > 1))。它处理的是探测侧倾斜,对上一小节构建侧的重键没有帮助。
六、PostgreSQL 17 与 MySQL 8.4 的实现
PostgreSQL:批次数只加倍
src/backend/executor/nodeHashjoin.c
的文件头说明它基于 hybrid hash join,并引用了 Zeller &
Gray, “An Adaptive Hash Join Algorithm for Multiuser
Environments”(VLDB
1990)。串行执行时的状态机如下(状态名去掉了
HJ_ 前缀,并行执行的 barrier 阶段省略):
stateDiagram-v2
    [*] --> BUILD_HASHTABLE
    BUILD_HASHTABLE --> NEED_NEW_OUTER: inner fully hashed
    NEED_NEW_OUTER --> NEED_NEW_OUTER: later batch, save to file
    NEED_NEW_OUTER --> SCAN_BUCKET: tuple of current batch
    SCAN_BUCKET --> SCAN_BUCKET: emit match
    SCAN_BUCKET --> FILL_OUTER_TUPLE: bucket exhausted
    FILL_OUTER_TUPLE --> NEED_NEW_OUTER
    NEED_NEW_OUTER --> FILL_INNER_TUPLES: batch done, right/full join
    NEED_NEW_OUTER --> NEED_NEW_BATCH: batch done
    FILL_INNER_TUPLES --> NEED_NEW_BATCH
    NEED_NEW_BATCH --> NEED_NEW_OUTER: reload inner batch
    NEED_NEW_BATCH --> [*]: no batches left
内存上限是 get_hash_memory_limit(),即
work_mem × hash_mem_multiplier。work_mem
默认 4MB;hash_mem_multiplier 在 PostgreSQL 13
引入,PostgreSQL 15 起默认
2.0,所以默认配置下一个哈希表可以用到 8MB。规划阶段
ExecChooseHashTableSize()
按估计的内表大小算初始批次数:
\[ \mathrm{nbatch} = 2^{\left\lceil \log_2 \max\left(2,\ \left\lceil \frac{\text{inner bytes}}{\text{hash memory} - \text{bucket bytes}} \right\rceil\right) \right\rceil}, \]
以上是内表放不下时的情形,放得下就是 1。执行时如果
ExecHashTableInsert() 发现空间超限,就调用
ExecHashIncreaseNumBatches() 把 nbatch
加倍,把当前内存里不再属于当前批次的元组写到对应批次文件。批次号和桶号取自哈希值的不同位:
/* PostgreSQL REL_17_9, src/backend/executor/nodeHash.c, ExecHashGetBucketAndBatch()(节选) */
if (nbatch > 1)
{
    *bucketno = hashvalue & (nbuckets - 1);
    *batchno = pg_rotate_right32(hashvalue,
                                 hashtable->log2_nbuckets) & (nbatch - 1);
}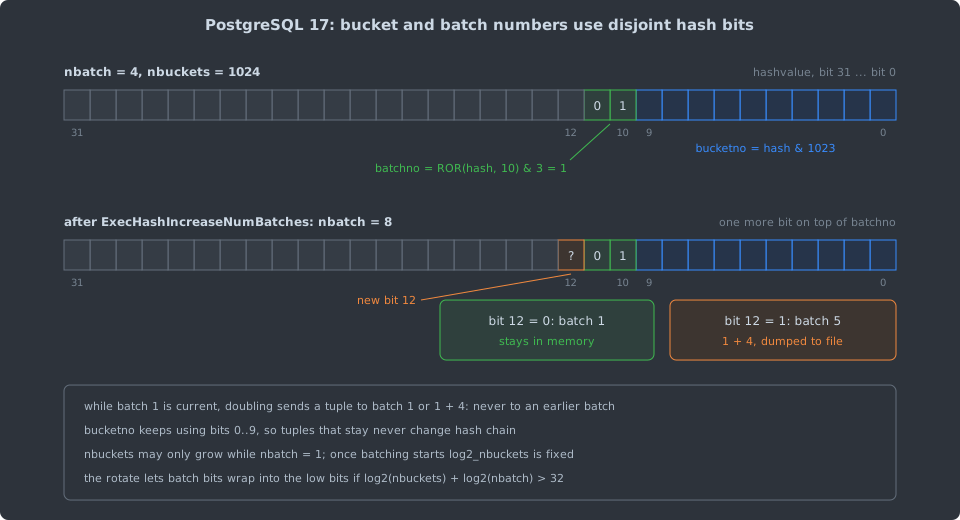
函数注释解释了这个设计:加倍”effectively adds one more
bit to the top of the
batchno”,于是当前批次的元组要么留下、要么去编号更大的批次,从不回到已处理过的批次;桶号用的低位不变,留下的元组也不用换链表。正因如此,nbuckets
只允许在 nbatch 仍为 1
时增长,一旦开始分批,log2_nbuckets
就固定了。循环右移让批次位在总位数超过 32
时借用桶号的低位:“It’s better to have longer bucket chains
than to lose the ability to divide batches.”
和 DeWitt 的 hybrid 对比,PostgreSQL 的批次大小相等,批次 0 就是其中之一,所以 \(q = 1/\mathrm{nbatch}\)。nbatch 向上取到 2 的幂,批次 0 只用到内存的一半到全部。按上面的公式推算:\(F b_R = 1400\) 页、\(M = 1000\) 页时,DeWitt 的 \(q = 999/1400 \approx 0.714\),代价约 7,864;PostgreSQL 取 nbatch = 2,\(q = 0.5\),代价 \((3-1)\times 5000 = 10000\)。这是推算,没有在 PostgreSQL 上实测。换来的是实现简单:批次数可以在运行时加倍,估计偏小也不会失控。
加倍解决不了重键。ExecHashIncreaseNumBatches()
在一次加倍后如果”dumped out either all or none of the tuples
in the table”,就置
growEnabled = false,永久停止加倍,注释直言:“We
have to just gut it out and hope the server has enough RAM.”
也就是说,PostgreSQL 17
遇到构建侧重键时的策略是超出内存预算。
读入后续批次时,ExecHashJoinNewBatch() 从
innerBatchFile[curbatch]
重建哈希表,注释提醒此时”some tuples may be sent to future
batches. Also, it is possible for hashtable->nbatch to be
increased here!“;外表元组在 HJ_NEED_NEW_OUTER
状态发现不属于当前批次时,由
ExecHashJoinSaveTuple() 写入
outerBatchFile[batchno],批次 0
的外表元组不落盘,这正是 hybrid 的特征。
并行哈希连接(PostgreSQL 11 起,Thomas
Munro)用一张共享哈希表,并行路径的内存预算乘以
parallel_workers + 1。它有一个与串行路径不同的地方:nbatch
大于 1 时,ExecParallelHashJoinPartitionOuter()
把所有外表元组,包括批次 0,写进共享
tuplestore 再各自取批次处理,探测侧的行为更接近 Grace。
在 EXPLAIN ANALYZE 里,哈希节点输出
Buckets: %d (originally %d) Batches: %d (originally %d) Memory Usage: ...kB(src/backend/commands/explain.c),Batches
比 originally 大,说明内表估计偏小、运行时发生了加倍。
MySQL:从内存降级为 hybrid,不递归
MySQL 8.0.18
引入哈希连接,最初只用于没有可用索引的内连接等值条件;8.0.20
起,凡是原来会用块嵌套循环(BNL)的地方都改用哈希连接,包括内连接的非等值条件、半连接、反连接和左右外连接,EXPLAIN
不再显示 BNL(8.0.18、8.0.20 Release Notes;8.4 手册
10.2.1.4 “Hash Join
Optimization”)。EXPLAIN FORMAT=TREE 中显示为
Inner hash join、Left hash join
等(sql/join_optimizer/explain_access_path.cc)。
sql/iterators/hash_join_iterator.h
的注释完整描述了执行流程。
flowchart TD
    A[read build rows into in-memory hash table] -->|all rows fit| B[classic in-memory hash join]
    A -->|join_buffer_size full| C{spilling allowed?}
    C -->|no, e.g. LIMIT without sort| D[probe whole input, clear table, load next build rows, repeat]
    C -->|yes| E[hash remaining build rows into at most 128 chunk files]
    E --> F[each probe row: look up in memory table, then write to its probe chunk]
    F --> G[for each chunk pair: load build chunk, stream probe chunk]
    G -->|build chunk too big| H[load a piece at a time, reread whole probe chunk per piece]
几个细节来自源码:
- 哈希表容量由
join_buffer_size决定,表本身是ankerl::unordered_dense::segmented_map(hash_join_buffer.cc)。 - 落盘时的 chunk 数由
InitializeChunkFiles()决定:按规划器估计的剩余行数除以”内存表行数 × 0.9”(kReductionFactor,注释说宁可多一两个 chunk,也不要多次重读探测输入),上限kMaxChunks = 128(“to avoid running out of file descriptors”),再用std::bit_ceil取 2 的幂。分到 chunk 用另一个带种子(kChunkPartitioningHashSeed)的哈希函数。 - chunk 装不下时不递归分区,注释的说法是”reading as much as possible into the hash table, and then reading the entire probe chunk file for each time the hash table is reloaded. This might happen if we have a very skewed data set”。半连接等需要去重的连接类型再配合 probe row saving 文件。
- 内存里的那部分构建行是”先读到的行”,不是按哈希范围选出来的,所以一个探测行可能同时与内存和磁盘上的构建行匹配。
WriteProbeRowToDiskIfApplicable()因此对内连接和外连接把每个探测行都写进 chunk 文件(半连接、反连接在内存已命中时可以跳过)。
最后一点改变了代价。设内存中构建行的比例为 \(q'\),按源码逻辑推算(未实测):
\[ \mathrm{cost}_{\mathrm{MySQL}} \approx (3 - 2q')\, b_R + 3\, b_S , \]
构建侧享受 hybrid 的节省,探测侧和 Grace 一样全部写出再读回。PostgreSQL 串行路径的批次 0 外表元组不落盘,并行路径则与 MySQL 同样全部写出。
MySQL 在注释里还承认了模拟结果第 3 点那种情况:“It could
also be beneficial if the build input almost fits
in memory; it would likely be better to read the probe input
twice instead of writing both inputs out to disk. However,
we do not currently do any such cost based optimization.”
不允许落盘的模式(LIMIT
且无排序时使用)正是”读多遍探测输入”,但它是为了尽早出结果,不是代价选择。落盘哈希连接打开的文件数会受
open_files_limit 约束(8.4 手册
10.2.1.4)。
两者的共同点
两个系统的内存哈希表都是一张不分区的大表;溢出都按哈希值切到磁盘文件;都假设构建侧的键大致均匀,对构建侧重键都没有真正的解决办法:PostgreSQL
放弃加倍、超出内存,MySQL 分段装载、反复重读探测
chunk。PostgreSQL 17 的内存计算还有一个盲区:每个批次的
BufFile 自带一个 BLCKSZ(默认
8KB)缓冲(src/backend/storage/file/buffile.c),内外表各一个,而
nodeHash.c
计算批次数和空间时没有计入它们。nbatch
很大时,这部分内存会超过哈希表本身的预算。
七、内存中的哈希连接:分区还是不分区
问题从哪来
数据全在内存里时,页 I/O 不再是瓶颈,代价变成了 CPU 缓存和 TLB 缺失:哈希表比末级缓存大时,每次探测至少一次缓存缺失。Shatdal、Kant、Naughton(VLDB 1994)提出把内存哈希连接也做成”先分区、再在缓存大小的分区里连接”;Manegold、Boncz、Kersten(IEEE TKDE 2002)指出单趟分区的扇出受 TLB 项数和缓存行数限制,扇出太大时分区本身就会缺失,于是提出多趟 radix 分区。这类算法统称 radix-partitioned hash join(下文记为 PRO),与之相对的是直接建一张全局哈希表的 no-partitioning join(NPO)。
实验
reproduce/inmem_join.c
实现了三种单线程算法:NPO;PRO1,一趟分区;PRO3,三趟分区,每趟扇出不超过
16。两种 PRO 都把分区切到每个约 2K
个构建元组,分区内的哈希表只有几十 KB。两个负载:W1 \(\lvert R\rvert =
2^{20}\)、\(\lvert S\rvert
= 2^{24}\),比例与 Blanas 等人的 16M ⋈ 256M
相同,规模缩小 16 倍,PRO 分区位数为 9;W2 \(\lvert R\rvert = \lvert S\rvert =
2^{23}\),形状类似 Balkesen 等人的 Workload
B,分区位数为 12。元组 8 字节,哈希表项 16
字节。每种算法的结果条数和校验和都与 NPO 核对。
分区的核心是直方图加前缀和的两遍扫描:
/* reproduce/inmem_join.c, radix_pass()(节选,删去了 -DSIM 构建用来计数的 ACC() 调用) */
for (size_t i = 0; i < n; i++) {
    size_t p = (hash32(in[i].key) >> shift) & mask;
    cur[p]++;
}
size_t sum = 0;
for (size_t p = 0; p < fan; p++) {
    size_t c = cur[p];
    start[p] = sum;
    cur[p] = sum;
    sum += c;
}
start[fan] = sum;
for (size_t i = 0; i < n; i++) {
    size_t p = (hash32(in[i].key) >> shift) & mask;
    out[cur[p]++] = in[i];
}同一份代码编译两次。-DSIM
版本把每次数组访问喂给一个简化的存储模型:1MiB、16
路组相联、64 字节行的 LRU 缓存,加上 64 项全相联 LRU 的
TLB,4KiB 页;连续运行 3 次输出一致。计时版本在 7 号核上用
taskset 绑核,每种算法跑 5 次取中位数,整组重复
3 轮再取中位数。环境:Intel Core i9-12900K(L2 每个性能核
1.25MiB,L3 30MiB),WSL2 内核 6.6.87.2,GCC
16.1.1,-O2,透明大页为
madvise,所以这些数组用的是 4KiB
页。机器上同时有其他负载,计时只看相对趋势。
gcc -O2 -Wall -Wextra -DSIM -o inmem_sim inmem_join.c && ./inmem_sim
gcc -O2 -Wall -Wextra -o inmem_time inmem_join.c && taskset -c 7 ./inmem_time
模拟结果,按每个 \(S\) 元组平均:
| 负载 | 算法 | 访存 | 缓存缺失 | TLB 缺失 |
|---|---|---|---|---|
| W1 | NPO | 3.25 | 2.060 | 2.023 |
| W1 | PRO1 | 8.89 | 0.544 | 0.948 |
| W1 | PRO3 | 19.51 | 1.317 | 0.021 |
| W2 | NPO | 7.00 | 3.523 | 2.997 |
| W2 | PRO1 | 18.27 | 1.743 | 1.991 |
| W2 | PRO3 | 38.27 | 2.249 | 0.040 |
实测时间(W1 共 \(2^{24}\) 个探测元组,W2 共 \(2^{23}\) 个):
| 负载 | 算法 | 时间 (ms) | 每个 \(S\) 元组 (ns) |
|---|---|---|---|
| W1 | NPO | 170.6 | 10.17 |
| W1 | PRO1 | 154.9 | 9.23 |
| W1 | PRO3 | 230.9 | 13.76 |
| W2 | NPO | 257.2 | 30.66 |
| W2 | PRO1 | 178.5 | 21.28 |
| W2 | PRO3 | 229.3 | 27.33 |
怎么读这两张表
- NPO 的代价是每次探测两次缺失。 模型里 NPO 每个探测元组约 2 次缓存缺失(桶头和链表项)和 2 次 TLB 缺失,分区把分区内的哈希表压进缓存,缓存缺失降到原来的四分之一到一半。
- 扇出受 TLB 限制,这一点模型和实机给出了不同答案。 PRO1 的单趟扇出是 512 或 4096,远超模型的 64 项 TLB,几乎每次散射写都缺失;PRO3 把每趟扇出压到 16,TLB 缺失几乎消失,代价是访存数比 PRO1 多一倍以上(19.51 对 8.89,38.27 对 18.27)。可是在实机上 PRO1 最快、PRO3 最慢:真实处理器还有容量大得多的二级 TLB 和硬件预取,本文的玩具模型没有,它夸大了大扇出的惩罚。只看模型会得出”必须多趟分区”的结论,实测推翻了它,这也说明 Manegold 等人的多趟分区是针对当年的硬件参数调出来的。
- 哈希表相对末级缓存的大小决定分区值不值。 W1 的 NPO 哈希表(\(2^{20}\) 个 16 字节项加 4MiB 桶头,约 20MiB)还放得进 30MiB 的 L3,PRO1 只快约 10%;W2 的表约 160MiB,PRO1 比 NPO 快约 1.44 倍。在干净目录复跑时,W1 的 NPO 一度升到 259 ms,两种 PRO 只变化几个百分点:NPO 靠的是所有核共享的 L3,机器上其他负载一挤占,它最先受影响。
本实验是单线程的,不能用来裁决多线程下的争论,下一节的文献结论都在多核、SIMD 和 NUMA 条件下得出。
八、争论与开放问题
争论一:内存中要不要分区
- Blanas、Li、Patel(SIGMOD 2011) 认为不分区就够了:在 16M ⋈ 256M 的负载上,Intel Nehalem 上 NPO 与最好的分区算法相当,在 Sun UltraSPARC T2 上至少快 1.5 倍(Figure 1);高度倾斜时 NPO 在 Nehalem 上快约 2 倍、在 T2 上快 4 倍以上(4.5 节)。他们的解释是同时多线程(SMT)能掩盖缺失延迟:关掉 SMT 时 NPO 比分区算法慢约 2 倍,开启后几乎追平(4.6 节,Table 5)。
- Balkesen、Teubner、Alonso、Özsu(ICDE 2013) 重新实现并调优后得出相反结论:在 Blanas 的负载(Workload A,256MiB ⋈ 4096MiB)上 radix 在 Intel 上快约 25%;在两边等大的 Workload B(977MiB ⋈ 977MiB)上,Intel 上快约 3.5 倍,AMD 与 Sun 上约 2.5 倍(Figure 14)。他们指出 Blanas 的 radix 实现先建好所有分区的哈希表再统一探测,失去了分区带来的缓存局部性;不过在 Niagara 2 上,Workload A 仍然是 NPO 占优。
- Bandle、Giceva、Neumann(SIGMOD 2021) 把 radix join 集成进完整系统 Umbra,TPC-H 的 59 个连接里只有 1 个明显受益,他们因此不建议通用系统采用。HyPer 的 morsel-driven 并行框架(Leis et al., SIGMOD 2014)同样构建一张全局共享哈希表,不做 radix 分区。
本文的单线程实验支持一个窄的结论:哈希表远大于末级缓存时分区有明显收益,放得进时收益很小。这与 Balkesen 的 Workload B 和 Blanas 的”与最好的分区算法相当”都不矛盾;分歧在于哪种情形在真实负载里更常见,Bandle 的数据站在 Blanas 一边。
争论二:排序还是哈希
Shapiro(1986)在他的代价模型里证明 hybrid 优于 sort-merge,并指出当时的商业系统大多只实现 sort-merge。Graefe、Linville、Shapiro(IEEE TKDE 1994)“Sort versus hash revisited”把两者的对偶性逐项列出,结论是性能差别”by percentages rather than factors”;Graefe 同年的 ICDE 论文题为”Sort-merge-join: An idea whose time has(h) passed?“,题目本身就是这场争论。多核时代,Kim 等人(PVLDB 2009)预测 SIMD 变宽后 sort-merge 会反超;Albutiu、Kemper、Neumann(PVLDB 2012)提出面向 NUMA 的 MPSM 归并连接;Balkesen、Alonso、Teubner、Özsu(PVLDB 2013)用 AVX 重新比较,发现 radix hash join 仍然明显更快,sort-merge 只有在数据量非常大时才接近。至少到 2013 年的硬件,Kim 等人的预测没有兑现。
开放问题
- 基数估计错了怎么办。 PostgreSQL 靠 nbatch 运行时加倍兜底,但每次加倍都要扫描内存中的全部元组、写出其中约一半;MySQL 的 chunk 数在第一次溢出时按估计值定死,估计偏小就只能重读探测 chunk。Zeller & Gray(1990)研究的是运行中内存预算本身变化的自适应哈希连接,把”估计错误”和”内存变化”统一处理的执行期自适应仍然是工程上的难点。
- 构建侧重键。 两个系统都没有把热键拆出来单独处理,退路是超出内存或反复回扫。第五节的模拟说明递归分区在这里只会白白增加 I/O;及早识别热键、对热键改用嵌套循环,是一个直接的方向,但需要在构建时就能判断,而递归到第几层才算没有进展,目前只有经验阈值。
- 溢出的元数据成本。 批次文件缓冲、文件描述符上限(MySQL 的 128 个 chunk)都没有计入代价模型。批次数一大,这些”看不见”的开销就会主导。
九、工程选型
| 场景 | 倾向 | 依据 |
|---|---|---|
| 外层过滤后很小,内层连接列有索引 | 索引嵌套循环 | 代价与 \(b_S\) 无关,见第二节 |
| 非等值条件 | 嵌套循环;MySQL 8.0.20 起由无哈希键的哈希连接迭代器执行 | 哈希与归并都依赖等值 |
| 两边已按连接键有序,或后续需要同一顺序 | 归并连接 | 省去排序,输出可复用(interesting order) |
| 等值、无序、构建侧接近或超过内存 | hybrid 哈希连接 | 代价 \((3-2q)(b_R+b_S)\),随内存平滑下降 |
| 构建侧略大于内存 | 考虑分块读两遍探测侧 | 第四节 \(M=700\) 的结果与 MySQL 源码注释 |
| 构建侧有大量重复键 | 交换构建侧,让重复键落在探测侧 | 递归分区无效,见第五节 |
排查时,PostgreSQL 看 EXPLAIN ANALYZE
里哈希节点的 Batches 与
originally,批次数超过 1
就说明发生了落盘,可以调大 work_mem 或
hash_mem_multiplier;批次数远超初值,说明内表行数估计偏小,要先修统计信息。MySQL
相应的参数是 join_buffer_size,落盘规模受
open_files_limit 限制。
十、参考资料
规范与文档
- PostgreSQL 17 Documentation, 19.4 “Resource
Consumption”:
work_mem、hash_mem_multiplier。 - PostgreSQL 11 Release Notes(并行哈希连接)、13 Release
Notes(引入
hash_mem_multiplier)、15 Release Notes(“Increase hash_mem_multiplier default to 2.0”)。 - MySQL 8.4 Reference Manual, 10.2.1.4 “Hash Join Optimization”。
- MySQL 8.0.18 与 8.0.20 Release Notes(哈希连接引入,取代 BNL)。
源码(PostgreSQL REL_17_9,MySQL 8.4.9)
- PostgreSQL
src/backend/executor/nodeHashjoin.c:文件头注释、ExecHashJoinImpl()、ExecHashJoinNewBatch()、ExecHashJoinSaveTuple()、ExecParallelHashJoinPartitionOuter()。 - PostgreSQL
src/backend/executor/nodeHash.c:ExecChooseHashTableSize()、ExecHashTableCreate()、ExecHashTableInsert()、ExecHashIncreaseNumBatches()、ExecHashGetBucketAndBatch()、ExecHashBuildSkewHash()、get_hash_memory_limit();src/include/executor/hashjoin.h:SKEW_HASH_MEM_PERCENT、SKEW_MIN_OUTER_FRACTION。 - PostgreSQL
src/backend/executor/nodeMergejoin.c(文件头注释与EXEC_MJ_*状态);src/backend/optimizer/path/costsize.c:final_cost_mergejoin();src/backend/storage/file/buffile.c;src/backend/commands/explain.c。 - MySQL
sql/iterators/hash_join_iterator.h(文件头注释、kMaxChunks)、sql/iterators/hash_join_iterator.cc(InitializeChunkFiles()、WriteProbeRowToDiskIfApplicable())、sql/iterators/hash_join_buffer.cc、sql/iterators/hash_join_chunk.h、sql/join_optimizer/explain_access_path.cc。
核心论文
- M. Kitsuregawa, H. Tanaka, T. Moto-oka, “Application of hash to data base machine and its architecture”, New Generation Computing 1(1):63–74, 1983.
- D. J. DeWitt, R. H. Katz, F. Olken, L. D. Shapiro, M. R. Stonebraker, D. A. Wood, “Implementation techniques for main memory database systems”, SIGMOD 1984, pp. 1–8.
- L. D. Shapiro, “Join processing in database systems with large main memories”, ACM TODS 11(3):239–264, 1986.
- S. Blanas, Y. Li, J. M. Patel, “Design and evaluation of main memory hash join algorithms for multi-core CPUs”, SIGMOD 2011, pp. 37–48.
- C. Balkesen, J. Teubner, G. Alonso, M. T. Özsu, “Main-memory hash joins on multi-core CPUs: Tuning to the underlying hardware”, ICDE 2013, pp. 362–373.
- C. Balkesen, G. Alonso, J. Teubner, M. T. Özsu, “Multi-core, main-memory joins: Sort vs. hash revisited”, PVLDB 7(1):85–96, 2013.
其他论文
- P. G. Selinger, M. M. Astrahan, D. D. Chamberlin, R. A. Lorie, T. G. Price, “Access path selection in a relational database management system”, SIGMOD 1979.
- H. Zeller, J. Gray, “An adaptive hash join algorithm for multiuser environments”, VLDB 1990, pp. 186–197.
- G. Graefe, “Query evaluation techniques for large databases”, ACM Computing Surveys 25(2):73–169, 1993.
- G. Graefe, A. Linville, L. D. Shapiro, “Sort versus hash revisited”, IEEE TKDE 6(6):934–944, 1994.
- G. Graefe, “Sort-merge-join: An idea whose time has(h) passed?”, ICDE 1994, pp. 406–417.
- A. Shatdal, C. Kant, J. F. Naughton, “Cache conscious algorithms for relational query processing”, VLDB 1994, pp. 510–521.
- S. Manegold, P. A. Boncz, M. L. Kersten, “Optimizing main-memory join on modern hardware”, IEEE TKDE 14(4):709–730, 2002.
- C. Kim, E. Sedlar, J. Chhugani, T. Kaldewey, A. D. Nguyen, A. Di Blas, V. W. Lee, N. Satish, P. Dubey, “Sort vs. hash revisited: Fast join implementation on modern multi-core CPUs”, PVLDB 2(2):1378–1389, 2009.
- M.-C. Albutiu, A. Kemper, T. Neumann, “Massively parallel sort-merge joins in main memory multi-core database systems”, PVLDB 5(10):1064–1075, 2012.
- V. Leis, P. Boncz, A. Kemper, T. Neumann, “Morsel-driven parallelism: A NUMA-aware query evaluation framework for the many-core age”, SIGMOD 2014.
- M. Bandle, J. Giceva, T. Neumann, “To partition, or not to partition, that is the join question in a real system”, SIGMOD 2021.
工程资料
- R. Ramakrishnan, J. Gehrke, Database Management Systems, 3rd ed., McGraw-Hill, 2003(连接算法一章的代价记账口径)。
实验
reproduce/join_io_sim.c:第一、二、四、五节的页 I/O 数据;reproduce/plot_io.py生成join-io-vs-memory.svg。reproduce/inmem_join.c:第七节的模拟访存与计时数据。
系列导航: - 上一篇:定时器数据结构:堆、时间轮与生产系统的精度权衡 - 下一篇:查询优化器:System R 动态规划、Cascades Memo 与基数误差
相关阅读: - 外部排序:从 I/O 下界到 PostgreSQL 与 GNU sort - 哈希表内部:开放寻址、链式与 Robin Hood - 缓冲池管理算法 - PG 内核:Join 顺序与路径生成 - 分布式 OLAP 查询引擎:Hash Join 与 Hash Aggregation
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
查询优化器:System R 动态规划、Cascades Memo 与基数误差
从 System R 的左深动态规划与 interesting orders 出发,解释 Volcano/Cascades 如何用 memo、规则和物理性质组织搜索,再用可复现实验展示查询图形状与基数估计误差如何决定计划质量。
WAL 与 ARIES:pageLSN、CLR 与可重启恢复
从 steal/no-force 缓冲策略出发,拆解 ARIES 的 Analysis、Redo、Undo、pageLSN、CLR 与 fuzzy checkpoint,并用可复现实验验证恢复中再次崩溃的幂等性;最后对照 PostgreSQL 16 与 SQLite 3.46 的真实 WAL 边界。
外部排序:从 I/O 下界到 PostgreSQL 与 GNU sort
从 Aggarwal–Vitter 的 I/O 下界出发,用可复现实验比较替换选择与快排生成 run、败者树与堆的比较次数、多阶段与平衡归并的搬运量,再对照 PostgreSQL 18 与 GNU sort 9.11 源码说明今天为何多用快排、平衡归并和堆。