Tarjan
算法族容易被讲成一句话:一次深度优先搜索(Depth-First
Search,DFS)加一个 low
数组,就能求强连通分量(Strongly Connected
Component,SCC)、割点和桥。真正会出错的地方也在这句话里:SCC
的 low 只允许被仍在 SCC
栈里的顶点更新;无向图的 low
必须按边编号跳过父边;桥用 \(low[v] > disc[u]\),割点用
\(low[v] \ge
disc[u]\),根还要单独数 DFS 子树。
本文先把同一个 DFS
骨架拆成有向图和无向图两套不变量,再用同目录
reproduce/tarjan_lab.cpp 复现:Tarjan
SCC、Kosaraju、割点、桥的递归版与迭代版,并与暴力删点、删边和可达性基线对拍。计时不是重点,实验只报告访问边数、栈操作次数和递归深度这些与墙钟无关的指标。
一、谱系:DFS 为什么能统一这些问题
Tarjan 的论文 “Depth-First Search and Linear
Graph Algorithms” 先在 1971 年 IEEE SWAT 发表,1972
年发表于 SIAM Journal on Computing
1(2):146–160。论文的核心贡献不是给出某个孤立技巧,而是证明
DFS 树、回边和 low
值足以在线性时间识别强连通分量、双连通分量等结构。
随后几条线各自发展:
| 年份 | 工作 | 本文引用点 |
|---|---|---|
| 1972 | Tarjan, Depth-First Search and Linear Graph Algorithms, SIAM J. Comput. | SCC 与 DFS/low-link 框架的源头 |
| 1973 | Hopcroft–Tarjan, “Algorithm 447: efficient algorithms for graph manipulation”, CACM 16(6) | 线性时间图操作与双连通分量的工程化表述 |
| 1981 | Sharir, “A strong-connectivity algorithm and its applications in data flow analysis”, Computers & Mathematics with Applications | Kosaraju–Sharir 两遍 DFS 视角 |
| 1994 | Nuutila–Soisalon-Soininen, “On finding the strongly connected components in a directed graph”, Information Processing Letters | SCC 的非递归与栈优化变体 |
| 2000 | Gabow, “Path-based depth-first search for strong and biconnected components”, Information Processing Letters | path-based SCC / biconnected DFS 变体 |
| 2016 | Pearce, “A space-efficient algorithm for finding strongly connected components”, Information Processing Letters | 进一步压缩 SCC 辅助空间 |
工程实现也沿用这条谱系。NetworkX 3.5 的
networkx/algorithms/components/strongly_connected.py
中,strongly_connected_components 明确写着使用
Tarjan 算法加 Nuutila 修改,且是非递归版本;同文件还提供
kosaraju_strongly_connected_components。LLVM
21.1.0 的 llvm/include/llvm/ADT/SCCIterator.h
中,llvm::scc_iterator 使用 Tarjan DFS、内部
VisitStack 和
SCCNodeStack,并说明输出 SCC DAG
的逆拓扑序。这些实现都没有把“递归 DFS
伪代码”直接搬进生产代码。

上图只用于解释边分类。对有向图,已访问边可能指向正在递归栈中的祖先,也可能指向已经完成的
SCC;这两类边对 SCC 的 low
更新含义不同。对无向图,树边会以反向边再次出现,不能简单用端点是否等于父节点来跳过。
二、同名 low
的两套定义
设 \(disc[u]\) 是顶点 \(u\) 的 DFS 发现序号。
有向 SCC 的 low-link:处理完 \(u\) 的 DFS 子树后,\(low[u]\) 是从 \(u\) 出发,经若干条 DFS 树边,再接至多一条指向仍在 SCC 栈中顶点的边,能到达的最小 \(disc\)。规则是:
\[ low[u] = \min\Bigl(disc[u],\ \min_{(u,v)\text{ tree}} low[v],\ \min_{(u,v),\ v\text{ on stack}} disc[v]\Bigr). \]
“仍在栈中”不能省略。若边指向已经弹出的
SCC,它只说明从当前子树能到达一个更早完成的分量,不说明对方也能回到当前子树;用它更新
low 会把两个不同 SCC 粘在一起。
无向割点 / 桥的 low:处理完 \(u\) 的 DFS 子树后,\(low[u]\) 是 \(u\) 的子树内顶点,经过零条或多条树边,再用至多一条不是父树边本身的非树边,能到达的最小 \(disc\):
\[ low[u] = \min\Bigl(disc[u],\ \min_{(u,v)\text{ tree}} low[v],\ \min_{(x,y)\text{ back},\ x\in subtree(u)} disc[y]\Bigr). \]
这里“不是父树边本身”应按边编号判断。若无向边以邻接表的两条弧保存,只能跳过进入 \(u\) 的那条无向边;从 \(u\) 到父节点的另一条平行边仍然是合法回边。
三、Tarjan SCC:栈内顶点才可能同属一个分量
SCC 是有向图中极大的互相可达顶点集合。Tarjan SCC 维护三类状态:
disc[u] == 0:尚未访问;on_stack[u] == true:已经发现但还没归入某个 SCC;on_stack[u] == false且已访问:所在 SCC 已弹出。
核心代码片段来自 reproduce/tarjan_lab.cpp
的递归实现,完整程序还含迭代版和测试驱动:
if (!disc[v]) {
    dfs(v);
    low[u] = min(low[u], low[v]);
} else if (in[v]) {
    low[u] = min(low[u], disc[v]);
}
当回溯到 \(u\) 且 \(low[u] = disc[u]\) 时,\(u\) 是当前未弹出区域中发现序号最小的根;从 SCC 栈顶一直弹到 \(u\),正好得到一个 SCC。输出顺序是缩点 DAG 的逆拓扑序:若分量 \(A\) 有边到分量 \(B\),通常先弹出 \(B\)。
下面的轨迹来自同一程序的 examples
模式。图的边为 \(1\to2,2\to3,3\to1,2\to4,4\to5,5\to4,5\to6\)。
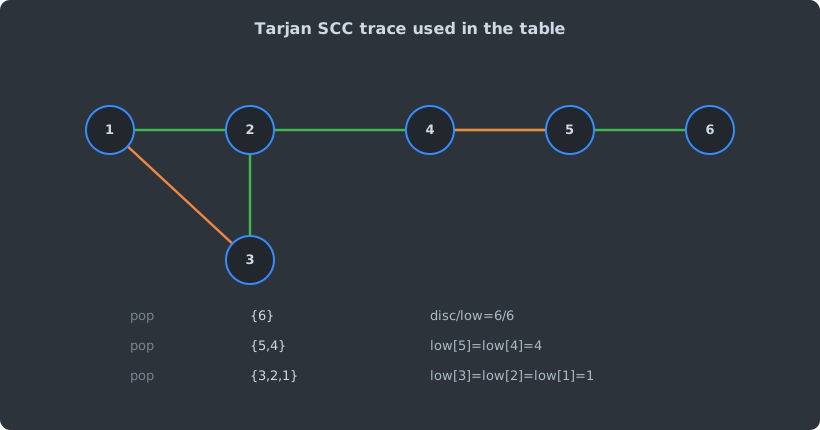
| 步 | 事件 | disc |
low |
SCC 栈 | 已弹出分量 |
|---|---|---|---|---|---|
| 1 | enter 1 | 1:- | 1:- | [1] | - |
| 2 | enter 2 | 1,2 | 1,2 | [1,2] | - |
| 3 | enter 3; edge 3->1 | 1,2,3 | 1,2,1 | [1,2,3] | - |
| 4 | return 3 to 2 | 1,2,3 | 1,1,1 | [1,2,3] | - |
| 5 | enter 4 | 1,2,3,4 | 1,1,1,4 | [1,2,3,4] | - |
| 6 | enter 5; edge 5->4 | 1,2,3,4,5 | 1,1,1,4,4 | [1,2,3,4,5] | - |
| 7 | enter 6; pop 6 | 1,2,3,4,5,6 | 1,1,1,4,4,6 | [1,2,3,4,5] | {6} |
| 8 | return 5 to 4; pop 5,4 | 1,2,3,4,5,6 | 1,1,1,4,4,6 | [1,2,3] | {6},{5,4} |
| 9 | return 4 to 2 | 1,2,3,4,5,6 | 1,1,1,4,4,6 | [1,2,3] | {6},{5,4} |
| 10 | return 2 to 1; pop 3,2,1 | 1,2,3,4,5,6 | 1,1,1,4,4,6 | [] | {6},{5,4},{3,2,1} |
这张表也暴露了 on_stack 条件的作用:弹出
{6} 后,任何指向 6 的边都不能再降低其他顶点的
low,因为 6 所在 SCC 已经封闭。
四、Kosaraju–Sharir:两遍 DFS 换来更直观的不变量
Kosaraju–Sharir 算法同样是线性时间,但做两遍 DFS:
- 在原图上 DFS,按完成时间把顶点压入序列;
- 在转置图 \(G^T\) 上按完成时间逆序 DFS,每次访问到的集合就是一个 SCC。
直觉来自缩点 DAG。若原图中 SCC \(A\) 能到达 SCC \(B\),第一遍 DFS 的最大完成时间会把源侧分量排在后面;第二遍反向遍历时,逆序取出的第一个未访问分量在 \(G^T\) 中没有通向未处理分量的出边,因此不会越界。
| 维度 | Tarjan SCC | Kosaraju–Sharir |
|---|---|---|
| DFS 次数 | 1 次 | 2 次 |
| 是否构造转置图 | 不需要 | 需要 \(G^T\) |
| 辅助结构 | SCC 栈、on_stack、low |
完成序列、转置图 |
| 适合场景 | 不想复制边、需要流式缩点 | 教学、已有转置邻接表 |
results.txt 中 30000
个随机小有向图显示:Tarjan 递归版和迭代版都访问 469223
条边;Kosaraju 访问 938446
条边,正好是两遍遍历的口径。这里不把它写成“Tarjan
快一倍”的性能结论,因为实际时间还受邻接表布局、缓存和语言运行时影响;可确认的事实只是边访问次数的差异。
五、割点与桥:同一棵无向 DFS 树上的两个判定
无向图中,割点是删除该顶点及其关联边后使连通分量数增加的顶点;桥是删除该边后使连通分量数增加的边。设 DFS 树边为 \((u,v)\),其中 \(u\) 是 \(v\) 的父节点。
桥判定:
\[ (u,v)\text{ is a bridge} \iff low[v] > disc[u]. \]
若 \(low[v] = disc[u]\),说明 \(v\) 的子树有一条非树边回到 \(u\),删除树边 \((u,v)\) 后仍可绕回 \(u\),所以不是桥。严格大于才说明 \(v\) 的子树连 \(u\) 本身都回不到。
割点判定分两种情况:
\[ u\ne root:\quad \exists v\text{ child of }u,\ low[v] \ge disc[u]. \]
非根顶点 \(u\) 的某个子树无法通过回边到达 \(u\) 的祖先时,删除 \(u\) 会切断该子树。根没有祖先,不能套这个条件;根是割点当且仅当它有至少两个 DFS 树子节点。
这就是 >= 与 >
的区别:割点删的是顶点 \(u\),回到 \(u\) 本身也没用;桥删的是边
\((u,v)\),只要还能回到
\(u\),这条边就不是唯一通道。
六、重边的最小反例
最小反例只有两个顶点和两条平行边。DFS 从 1 沿第一条边到
2;在 2 的邻接表里,第二条 2–1 平行边是合法回边,应该令
\(low[2]=disc[1]\)。如果代码写成
if (v == parent) continue;,两条 2–1
都会被跳过,第一条树边就会被误报为桥。
下图是测试程序使用的四点多重图版本:1–2
有两条平行边,2–3–4–2 构成环。程序输出
bridge=-,说明没有桥;割点只有 2。
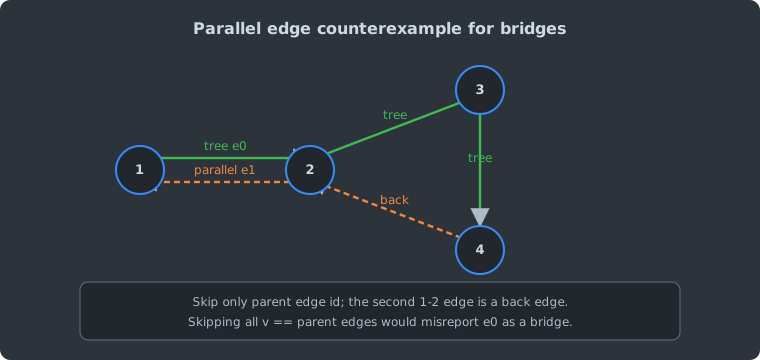
对应实现只跳过进入当前顶点的那条无向边编号:
for (auto [v, id] : adj[u]) {
    if (id == parent_edge) continue;
    if (!disc[v]) {
        dfs(v, id);
        low[u] = min(low[u], low[v]);
        if (low[v] > disc[u]) bridge[id] = true;
        if (parent_edge != -1 && low[v] >= disc[u]) cut[u] = true;
    } else {
        low[u] = min(low[u], disc[v]);
    }
}
若使用“每条无向边存两条有向弧”的竞赛写法,也可以跳过反向弧编号
id ^ 1,前提是边确实按成对顺序插入,且从 0
开始编号。
七、递归深度不是理论细节
DFS
伪代码通常写成递归,但链式图会让递归深度等于顶点数。当前环境
ulimit -s 为 8192
KiB;测试程序没有故意触发崩溃,而是用两个规模说明风险:
chain_iter n=200000 edges=199999 comps=200000 edge_visits=199999 stack_ops=800000 max_call_stack=200000
chain_rec_sample n=10000 edge_visits=9999 stack_ops=20000 max_rec_depth=10000 projected_depth_for_n=200000
迭代 Tarjan SCC 的显式帧只需要保存当前顶点、下一条待扫边和父顶点:
struct Frame { int u, next, parent; };遍历一条未访问边时压入新帧;顶点所有邻边处理完后弹帧,若
low[u] == disc[u] 就从 SCC 栈弹出一个分量,并把
low[u]
回传给父帧。这个写法和递归版访问同样的边,但把系统调用栈换成了可控的堆上数组。割点、桥的迭代版也类似,只是帧里还要记录
parent_edge 和根的子节点数。
八、复现实验:对拍优先,计时靠后
复现程序放在
post/algorithms/46-tarjan/reproduce/tarjan_lab.cpp,图示脚本放在
reproduce/draw_tarjan_figures.py。复现命令如下:
cd post/algorithms/46-tarjan/reproduce
BUILD_DIR="${BUILD_DIR:-./build}"
mkdir -p "$BUILD_DIR"
g++ -std=c++17 -O2 -Wall -Wextra -pedantic \
    -fsanitize=address,undefined -fno-omit-frame-pointer \
    tarjan_lab.cpp -o "$BUILD_DIR/tarjan_lab_asan"
taskset -c 11 "$BUILD_DIR/tarjan_lab_asan" test 30000
taskset -c 11 "$BUILD_DIR/tarjan_lab_asan" chain 200000 10000
taskset -c 11 "$BUILD_DIR/tarjan_lab_asan" examples
环境:Linux 6.6.87.2-microsoft-standard-WSL2
x86_64;GCC/G++ 16.1.1;taskset -c 11
绑核;编译时开启 AddressSanitizer 和
UndefinedBehaviorSanitizer。随机数种子固定为 20260924。
| 测试 | 基线 | 规模 | 结果 |
|---|---|---|---|
| 有向 SCC | 传递闭包暴力可达性 | 30000 个随机小图,合计 469223 条边 | Tarjan 递归、Tarjan 迭代、Kosaraju 全部一致 |
| 无向割点 / 桥 | 暴力删点、删边后重算连通分量 | 30000 个随机小多重图,合计 150882 条无向边 | 递归版、迭代版全部一致 |
| 大链图 | 结构性检查 | 200000 顶点有向链 | 迭代版最大显式调用栈 200000;递归样本 10000 顶点达到 10000 层 |
核心指标来自 results.txt:
| 算法 / 测试 | 访问边数 | 栈操作次数 | 最大深度 |
|---|---|---|---|
| Tarjan SCC 递归,随机有向图 | 469223 | 298308 | 9 |
| Tarjan SCC 迭代,随机有向图 | 469223 | 596616 | 9 |
| Kosaraju,随机有向图 | 938446 | 596616 | 9 |
| 割点/桥递归,随机无向图 | 301764 | - | 9 |
| 割点/桥迭代,随机无向图 | 301764 | 300662 | 9 |
| Tarjan SCC 迭代,大链图 | 199999 | 800000 | 200000 |
这些数字只支持三个结论:线性扫描边;Kosaraju 在该实现里按口径访问两遍边;链式图的 DFS 深度确实随 \(n\) 线性增长。它们不支持跨语言、跨机器的绝对耗时排名。
九、工程实现中的选择
如果图规模可控、输入来自竞赛题,递归版短且容易审查。进入服务端或编译器这类长期运行进程后,需要额外考虑三件事。
第一,递归栈边界。 LLVM 21.1.0 的
llvm::scc_iterator 用 VisitStack
显式模拟 DFS,NetworkX 3.5 的
strongly_connected_components
也在文档字符串里标明是非递归 Tarjan + Nuutila
修改。原因不是渐近复杂度,而是生产输入很容易出现深链。
第二,输出顺序。 Tarjan 和 LLVM
scc_iterator 常给出 SCC DAG
的逆拓扑序;Kosaraju
第二遍的发现顺序也依赖第一遍完成序。如果后续阶段需要确定性输出,应按顶点编号或组件最小顶点再排序,不要把当前邻接表顺序当接口承诺。
第三,图存储。 本文程序为了便于验证使用
vector<vector<int>>。更大的静态图常改用
Compressed Sparse
Row(CSR)或连续边数组,以减少分配次数和指针跳转。这个改变不会影响
disc/low
不变量,但会影响迭代帧里保存的是“下一条边的下标”还是迭代器。
十、开放问题:DFS 顺序的限制
Tarjan SCC 已经是线性时间,单机顺序算法很难再从渐近复杂度上改进。活跃问题主要在两类场景。
动态 SCC。 当有向图持续插入、删除边时,重新跑一次 \(O(|V|+|E|)\) 的 SCC 可能太贵。工程系统通常要在批处理重算、增量维护和近似告警之间取舍。本文不展开动态算法,因为它们的问题模型已经不同于静态 DFS。
并行 SCC。 DFS 的栈依赖天然串行。Fleischer、Hendrickson、Pınar 在 IPDPS Workshops 2000 的 “On Identifying Strongly Connected Components in Parallel” 使用 forward-backward 思路:选 pivot,同时求可达集与反向可达集,其交集是一个 SCC,再递归处理剩余区域。这类算法牺牲了 Tarjan 的简单 DFS 结构,换取更适合并行的分治形态;不同图族上的负载均衡和 pivot 选择仍会影响效果。
十一、参考资料
核心论文
- Robert E. Tarjan, “Depth-First Search and Linear Graph Algorithms”, SIAM Journal on Computing 1(2):146–160, 1972, DOI: 10.1137/0201010.
- John E. Hopcroft, Robert E. Tarjan, “Algorithm 447: efficient algorithms for graph manipulation”, Communications of the ACM 16(6), 1973, DOI: 10.1145/362248.362272.
- Micha Sharir, “A strong-connectivity algorithm and its applications in data flow analysis”, Computers & Mathematics with Applications 7(1):67–72, 1981, DOI: 10.1016/0898-1221(81)90008-0.
- Esko Nuutila, Eljas Soisalon-Soininen, “On finding the strongly connected components in a directed graph”, Information Processing Letters 49(1):9–14, 1994, DOI: 10.1016/0020-0190(94)90047-7.
- Harold N. Gabow, “Path-based depth-first search for strong and biconnected components”, Information Processing Letters 74(3–4):107–114, 2000, DOI: 10.1016/S0020-0190(00)00051-X.
- David J. Pearce, “A space-efficient algorithm for finding strongly connected components”, Information Processing Letters 116(1):47–52, 2016, DOI: 10.1016/j.ipl.2015.08.010.
其他论文
- Lisa K. Fleischer, Bruce Hendrickson, Ali Pınar, “On Identifying Strongly Connected Components in Parallel”, IPDPS Workshops 2000, Lecture Notes in Computer Science 1800:505–511, DOI: 10.1007/3-540-45591-4_68.
源码
- NetworkX 3.5,
networkx/algorithms/components/strongly_connected.py, functionsstrongly_connected_componentsandkosaraju_strongly_connected_components. - LLVM 21.1.0,
llvm/include/llvm/ADT/SCCIterator.h, class templatellvm::scc_iterator.
实验
post/algorithms/46-tarjan/reproduce/tarjan_lab.cpp:Tarjan SCC、Kosaraju、割点、桥的递归/迭代实现,随机对拍与链式图深度测试。post/algorithms/46-tarjan/reproduce/results.txt:本文表格所用原始输出。post/algorithms/46-tarjan/reproduce/draw_tarjan_figures.py:重绘dfs-tree.svg、scc-trace.svg、parallel-edge-bridge.svg的脚本。
上一篇: 最小生成树:割性质、Kruskal/Prim/Borůvka
与线性时间开放问题
下一篇: 网络流与二分匹配
相关阅读: - 拓扑排序 - 图着色与寄存器分配:从
DSatur 到 Chaitin-Briggs
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。
基数排序:绕开比较下界的代价,从 LSD、American flag sort 到 ska_sort
比较下界只约束比较模型,基数排序把代价转移到键长和内存访问上。本文推导代价模型,用缓存模拟与绑核实测解释位宽为何停在 8 到 11 位,并对照 ska_sort、ClickHouse、DuckDB 与 IPS²Ra 说明它何时赢、何时输。