最小生成树(Minimum Spanning Tree,MST)的问题陈述只有一句话:给一个连通无向图,每条边有权重,选出 \(n-1\) 条边把所有顶点连起来,并使权重和最小。围绕它流传的几种说法都只对一半。“稀疏图用 Kruskal、稠密图用 Prim”是教科书的经验法则,但本文第六节的实测显示,决定快慢的往往是数据能否放进缓存,而不是边密度。“割上最轻的边一定在 MST 里”只在最轻边唯一时成立;边权有并列时,这句话的正确版本决定了 Borůvka 会不会造出一个环。还有人以为 MST 早已”解决”:实际上,比较模型下是否存在确定性线性时间算法,至今没有答案。
本文先把割性质、环性质和唯一性条件写成带并列边的严格形式并给出证明(第一节),再交代从
1926 年到 2002 年的算法谱系(第二节),然后用同一个 7
顶点例图和分步图讲
Kruskal、Prim、Borůvka(第三到五节)。实验数据全部来自同目录的
reproduce/mst.c:它用暴力枚举校验三种算法,并统计比较次数、decrease-key
次数、并查集指针跳数等与时钟无关的量(第六节)。最后是工程选型、相关问题和开放问题。
一、问题与两条基本性质
定义
设 \(G=(V,E)\) 是无向图,\(n=|V|\),\(m=|E|\),权重函数 \(w: E \to \mathbb{R}\)。生成树(spanning tree)是 \(E\) 的子集 \(T\),它连通所有顶点且无环,因此恰有 \(n-1\) 条边;权重 \(w(T)=\sum_{e\in T} w(e)\) 最小的生成树叫最小生成树。图不连通时,对每个连通分量各取一棵,得到最小生成森林(minimum spanning forest),边数为 \(n-c\),\(c\) 是分量数。本文的实现都直接输出森林。
割(cut)是顶点的一个二分 \((S, V\setminus S)\),其中 \(\emptyset \ne S \subsetneq V\)。一端在 \(S\)、另一端在 \(V\setminus S\) 的边叫跨割边(crossing edge),记作 \(\delta(S)\)。若边集 \(A\) 中没有跨割边,就说这个割尊重(respects)\(A\)。
割性质
下面两个版本要分开记。
割性质(一般版,允许并列):设 \(A\) 包含于某棵 MST,割 \((S, V\setminus S)\) 尊重 \(A\),\(e\) 是 \(\delta(S)\) 中权重最小的边之一。那么 \(A \cup \{e\}\) 也包含于某棵 MST。
割性质(严格版):若 \(e\) 是 \(\delta(S)\) 中唯一的最轻边,则 \(e\) 属于每一棵 MST。
一般版就是 CLRS 所说的”安全边”(safe edge)定理,Kruskal 和 Prim 在边权并列时的正确性靠的是它;严格版只在最轻边唯一时成立。两者都用同一个交换论证证明,下图用例图演示:

证明(一般版):设 \(T^*\) 是包含 \(A\) 的 MST,\(e=(u,v)\),\(u\in S\),\(v\notin S\)。若 \(e\in T^*\),结论成立。否则 \(T^*\) 中 \(u\) 到 \(v\) 的唯一路径从 \(S\) 出发、到达 \(V\setminus S\),必然经过至少一条跨割边 \(f\ne e\)。因为割尊重 \(A\),\(f\notin A\)。\(e\) 是最轻跨割边,所以 \(w(e)\le w(f)\)。令 \(T' = T^* - f + e\):删掉 \(f\) 把 \(T^*\) 断成两块,\(u\)、\(v\) 分属两块,加上 \(e\) 重新连通,所以 \(T'\) 仍是生成树,且
\[ w(T') = w(T^*) - w(f) + w(e) \le w(T^*). \]
\(T'\) 也是 MST,并且包含 \(A\cup\{e\}\)。\(\blacksquare\)
证明(严格版):若某棵 MST \(T\) 不含 \(e\),同样的交换给出 \(w(T') < w(T)\),矛盾。\(\blacksquare\)
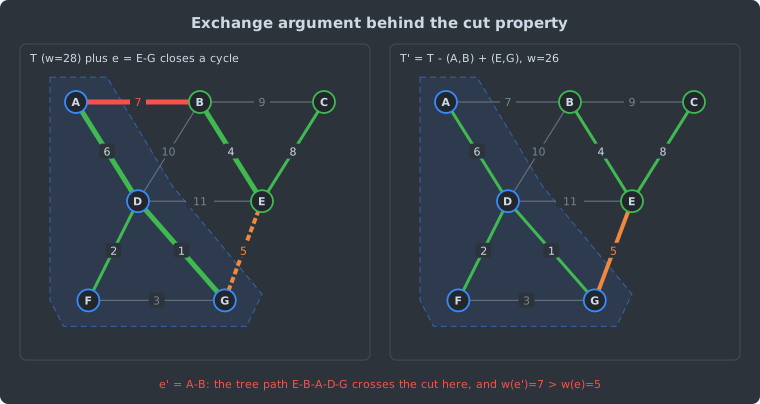
上图的 \(T\) 不含 E-G。把 E-G 加进去,树上 E 到 G 的路径 E-B-A-D-G 与它构成环;这条路径在 A-B 处跨过割,而 \(w(\text{A-B})=7 > w(\text{E-G})=5\),换掉之后权重从 28 降到 26。
环性质与最优性判据
环性质:设 \(C\) 是图中的一个环,\(e\in C\)。若 \(e\) 比 \(C\) 上其他边都严格重,则 \(e\) 不属于任何 MST;若 \(e\) 只是 \(C\) 上最重的边之一(允许并列),则存在一棵不含 \(e\) 的 MST。
证明是割性质的镜像:若 MST \(T\) 含 \(e\),删掉 \(e\) 得到一个割,\(C-e\) 是连接 \(e\) 两端的路径,必然经过另一条跨割边 \(f\),\(w(f)\le w(e)\),于是 \(T-e+f\) 不比 \(T\) 重,严格时更轻。
Tarjan 在 1983 年的专著里把这两条性质写成通用贪心框架的两条规则:蓝规则(blue rule,按割性质给边染蓝、选入)和红规则(red rule,按环性质给边染红、排除),任意顺序交替使用都能得到 MST。本文三种算法都只用蓝规则;Kruskal 1956 年论文里的 Construction A′(按权重从大到小删边,只要不破坏连通)就是纯红规则的算法,今天叫反向删除(reverse-delete)。
两条性质合起来给出一个最优性判据,后面的测试程序和”只看次序”的结论都用它:
判据:生成树 \(T\) 是 MST,当且仅当对每条非树边 \(e=(u,v)\),
\[ w(e) \ge \max_{f \in P_T(u,v)} w(f), \]
其中 \(P_T(u,v)\) 是 \(T\) 中 \(u\) 到 \(v\) 的路径。
证明:必要性:若路径上某条 \(f\) 满足 \(w(f)>w(e)\),\(T-f+e\) 更轻。充分性:在所有 MST 中取与 \(T\) 公共边最多的 \(T^*\),假设 \(T^*\ne T\)。取 \(e\in T^*\setminus T\),\(T^*-e\) 定义一个割;\(e\) 在 \(T\) 中是非树边,路径 \(P_T(u,v)\) 跨过这个割,跨割的那条树边 \(f\) 不在 \(T^*\) 中(\(T^*\) 里跨这个割的只有 \(e\))。由判据 \(w(e)\ge w(f)\),于是 \(T^*-e+f\) 不比 \(T^*\) 重,也是 MST,且与 \(T\) 多一条公共边,矛盾。\(\blacksquare\)
判据只涉及边权之间的比较,所以MST 只取决于边权的相对次序:对边权做任意严格递增变换,MST 集合不变。直接推论有三条:负权边不需要特殊处理;浮点权重不需要”整数化”或 \(\varepsilon\) 容差比较(容差比较反而破坏传递性),只要排除 NaN;把次序反过来就得到最大生成树。
唯一性
定理:若所有边权互不相同,MST 唯一。
证明:设 \(T_1\ne T_2\) 都是 MST。在对称差(symmetric difference)\(T_1 \triangle T_2\) 中取权重最小的边 \(e\),不妨设 \(e\in T_1\setminus T_2\)。把 \(e\) 加入 \(T_2\) 形成环 \(C\)。\(C\) 不可能全在 \(T_1\) 里(\(T_1\) 无环),所以 \(C\) 上有一条边 \(f\notin T_1\);\(f\in T_2\),于是 \(f\in T_1\triangle T_2\) 且 \(f\ne e\)。由 \(e\) 的取法和权重互异,\(w(f)>w(e)\)。\(T_2 - f + e\) 是生成树且比 \(T_2\) 轻,矛盾。\(\blacksquare\)
逆命题不成立:三角形的三条边权为 1、1、2 时,MST 唯一,但边权有并列。
这条定理有历史分量。Borůvka(1926)和 Jarník(1930)的原始论文都一开始就假设边权互不相同,并证明了解的唯一性;Kruskal 1956 年那篇三页的论文,写作目的之一就是给 Borůvka 的唯一性定理一个简单的证明,今天叫 Kruskal 算法的 Construction A 是他证明的工具。
工程上的推论是:给边权加上一个固定的次级键,例如把边的编号作为第二关键字,按
\((w, \text{id})\)
比较,就得到一个严格全序;这个全序下 MST
唯一,而且它也是原权重下的一棵
MST(全序细化了原次序,判据在原权重下仍然成立)。reproduce/mst.c
中所有算法都按 \(\text{key}(e) =
w(e)\cdot 2^{32} + \text{id}(e)\)
比较,因此即使边权大量并列,三种算法也必须返回完全相同的边集,这是测试程序的核心断言之一。
二、谱系:从 1926 年的电网到线性时间问题
flowchart TB
  subgraph classic["1926-1959: three greedy schemes"]
    B26["Boruvka 1926<br/>all components at once"]
    J30["Jarnik 1930<br/>grow one tree"]
    K56["Kruskal 1956<br/>edges by weight"]
    P57["Prim 1957 / Dijkstra 1959<br/>rediscover Jarnik"]
  end
  subgraph faster["1975-1987: beating O(m log n)"]
    Y75["Yao 1975 / Cheriton-Tarjan 1976<br/>O(m log log n)"]
    FT87["Fredman-Tarjan 1987<br/>Fibonacci heap, O(m beta(m,n))"]
    GGST["Gabow-Galil-Spencer-Tarjan 1986<br/>O(m log beta(m,n))"]
  end
  subgraph linear["1985-2002: towards linear time"]
    VER["Komlos 1985 / Dixon-Rauch-Tarjan 1992 / King 1997<br/>linear-time MST verification"]
    KKT["Karger-Klein-Tarjan 1995<br/>randomized, expected O(m)"]
    FW["Fredman-Willard 1994<br/>O(m) for integer weights, word RAM"]
    CH["Chazelle 2000<br/>deterministic O(m alpha(m,n))"]
    PR["Pettie-Ramachandran 2002<br/>optimal, exact bound unknown"]
  end
  J30 --> P57
  P57 --> FT87
  FT87 --> GGST
  GGST --> CH
  CH --> PR
  B26 --> Y75
  B26 --> KKT
  VER --> KKT
B26 --> CHBorůvka(1926)。捷克数学家 Otakar Borůvka 的问题来自西摩拉维亚电力公司(Západomoravské elektrárny)的职员 Jindřich Saxel:为南摩拉维亚设计最经济的输电网。他当年发表了两篇:一篇在摩拉维亚自然科学学会的期刊上,另一篇是发在工程期刊《Elektrotechnický obzor》上的短文,面向工程师。Nešetřil 等人 2001 年把两篇都译成了英文并附了评注。
Jarník(1930)。Vojtěch Jarník 读了 Borůvka 的论文,以给 Borůvka 写信的形式发表了另一种方法:从任一顶点出发,每次把离当前树最近的顶点接上来。这就是今天的 Prim 算法。Prim(Bell System Technical Journal,1957)和 Dijkstra(Numerische Mathematik,1959)先后独立地重新发现了它。Dijkstra 那篇三页的短文题为”关于图的两个问题”,第一个问题就是 MST,第二个才是后来以他命名的最短路。因此文献里也把它叫作 Jarník 算法、Prim–Jarník 算法或 DJP 算法。
Kruskal(1956)。Kruskal 在论文里给了三种构造:Construction A(按权重从小到大选边,跳过成环的边,即 Kruskal 算法)、Construction B(从一个给定的顶点子集出发向外选边,子集取单个顶点时就是 Prim 的做法)和 Construction A′(反向删除)。他在文末的参考文献里引用了 Borůvka。Graham 与 Hell 1985 年的综述是这段历史的标准参考。
超越 \(O(m\log n)\)。三种经典算法用二叉堆或排序实现都是 \(O(m\log n)\)。Yao(1975)用 Borůvka 式的分阶段做法得到 \(O(m\log\log n)\),Cheriton 与 Tarjan(1976)也给出了多种 \(O(m\log\log n)\) 算法。Fredman 与 Tarjan(1987)发明了 Fibonacci 堆,用它让 Prim 达到 \(O(m + n\log n)\),并给出 \(O(m\,\beta(m,n))\) 的 MST 算法,其中 \(\beta(m,n)=\min\{i : \log^{(i)} n \le m/n\}\);Gabow、Galil、Spencer、Tarjan(1986)改进到 \(O(m\log\beta(m,n))\)。
走向线性。1990 年代出现了三条互不相同的路线,区别在计算模型:
- Karger、Klein、Tarjan(JACM 1995)给出随机化的期望线性时间算法。模型是单位代价 RAM,对边权只允许做比较。核心引理是:以概率 \(p\) 独立采样每条边得到子图 \(H\),求出 \(H\) 的最小生成森林 \(F\),那么原图中不能被 \(F\) 按环性质排除的边(F-light 边)期望不超过 \(n/p\) 条。算法交替执行 Borůvka 步与采样步,排除 F-heavy 边则依赖线性时间的 MST 验证算法(Komlós 1985;Dixon、Rauch、Tarjan 1992;King 1997)。
- Fredman 与 Willard(1994)在字长 RAM 上、边权为整数时给出确定性线性时间算法。它利用了对边权做比较以外的运算。
- Chazelle(JACM 2000)给出确定性、基于比较的 \(O(m\,\alpha(m,n))\) 算法,\(\alpha\) 是反阿克曼函数(inverse Ackermann function)。它的关键数据结构是软堆(soft heap),一种允许部分键值”被污染”以换取常数均摊时间的近似优先队列。
- Pettie 与 Ramachandran(JACM 2002)给出一个可证明最优的确定性比较算法:运行时间是 \(O(T^*(m,n))\),\(T^*\) 是 MST 问题的决策树复杂度(decision-tree complexity),即确定 MST 所需的最少比较次数。但 \(T^*\) 的精确量级未知,目前只知道介于 \(\Omega(m)\) 与 \(O(m\,\alpha(m,n))\) 之间。
KKT 和 Chazelle 的算法都把 Borůvka 步当作基本收缩操作:每执行一次,顶点数至少减半。1926 年的算法因此至今仍在理论最快算法里使用。
三、Kruskal:排序加并查集
算法与正确性
- 把边按权重从小到大排序(本文实现按 \((w, \text{id})\));
- 依次考察每条边 \((u,v)\):若 \(u\)、\(v\) 已在同一连通分量,跳过;否则选入并合并两个分量;
- 选够 \(n-1\) 条边时提前结束。
下图是例图上的完整执行过程。例图有 7 个顶点、11 条边,边权取 1 到 11 且互不相同,因此 MST 唯一:
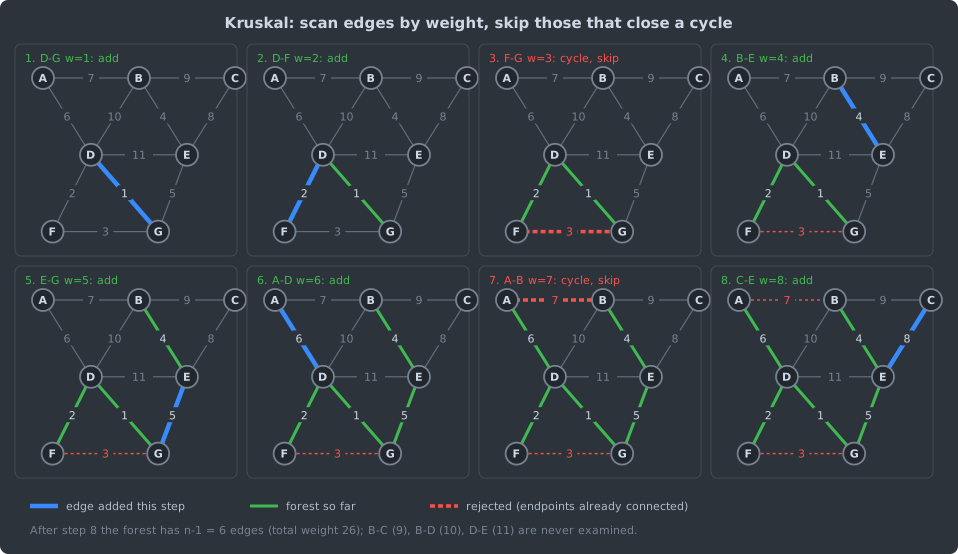
- 第 3 步 F-G 被拒绝:D-G、D-F 已经让 F 和 G 连通,F-G 会闭合环 D-F-G。
- 第 7 步 A-B 被拒绝:此时 A-D-G-E-B 已是一条路径。
- 第 8 步之后森林已有 6 条边,剩下的三条边根本不需要看。这个”提前结束”在第六节会变成一个很大的数字。
正确性:考察第 \(i\) 条被选入的边 \(e=(u,v)\),令 \(S\) 为当前森林中 \(u\) 所在的分量。这个割尊重已选边集 \(A\)(\(A\) 的边都在各分量内部)。任何排在 \(e\) 之前的边被拒绝时,两端已在同一分量;分量只会变大,所以两端现在仍在同一分量,不跨 \(S\)。因此 \(e\) 是 \(\delta(S)\) 中次序最小的边,由割性质一般版,\(A\cup\{e\}\) 仍包含于某棵 MST。对选入次数归纳即得正确性。这个论证不要求边权互异。
并查集
“两端是否在同一分量”和”合并分量”由并查集(disjoint-set
union,union-find)完成。本文实现用按秩合并(union by
rank)加完整的路径压缩(path compression)(摘自
reproduce/mst.c,删去了统计计数以外的无关代码):
static int uf_find(UF *uf, int x, Stats *st)
{
    int r = x;
    st->finds++;
    while (uf->parent[r] != r) { r = uf->parent[r]; st->hops++; }
    while (uf->parent[x] != r) { int nx = uf->parent[x]; uf->parent[x] = r; x = nx; }
    return r;
}

static void uf_link(UF *uf, int rx, int ry) /* rx, ry are distinct roots */
{
    if (uf->rank[rx] < uf->rank[ry]) { int t = rx; rx = ry; ry = t; }
    uf->parent[ry] = rx;
    if (uf->rank[rx] == uf->rank[ry]) uf->rank[rx]++;
}
关于并查集的复杂度,几个经常被写错的结论是:
- 只按秩合并时,秩不超过 \(\lfloor\log_2 n\rfloor\),树高不超过秩,所以单次 find 最坏 \(O(\log n)\)。这也意味着递归实现的 find 在按秩合并下栈深不超过 \(\lfloor\log_2 n\rfloor\)(\(n=10^6\) 时为 19),“大图递归 find 会爆栈”只在不做按秩合并时才成立。
- 按秩合并加路径压缩时,\(m\) 次操作的总时间是 \(\Theta(m\,\alpha(m,n))\),上界与这个算法的匹配下界都来自 Tarjan(JACM 1975)。按 CLRS 第 21.4 节的定义,\(n\) 远超 \(10^{80}\) 时仍有 \(\alpha(n)\le 4\)。
- 只做路径压缩、合并时随意挂接,Tarjan 与 van Leeuwen(JACM 1984)给出的最坏界是:\(m\ge n\) 时 \(\Theta(m\log_{1+m/n} n)\)。
- Fredman 与 Saks(STOC 1989)在 cell probe 模型下证明了 \(\Omega(\alpha)\) 的均摊下界,所以 \(\alpha\) 不是分析不够紧,而是这个问题本身的代价。
第六节的实测里,Kruskal 每次 find 平均只跟随 0.88 到 1.00 个父指针。在 Kruskal 的场景里,并查集的开销可以忽略,真正的开销在排序。
复杂度
排序 \(O(m\log m)\);简单图 \(m<n^2\),所以 \(\log m < 2\log n\),也可以写成 \(O(m\log n)\)。并查集部分最多 \(2m\) 次 find 和 \(n-1\) 次合并,是 \(O(m\,\alpha(m,n))\)。边已排好序,或者边权是小范围整数、可以用计数排序或基数排序时,总时间降到 \(O(m\,\alpha(m,n))\)。
四、Prim:从一个顶点向外生长
算法与正确性
维护已在树中的顶点集 \(S\) 和每个树外顶点 \(v\) 的键值 \(\text{key}[v]\),即从 \(S\) 到 \(v\) 的最轻边权。每步取键值最小的树外顶点加入 \(S\),再用它的邻边更新邻居的键值。正确性直接来自割性质一般版:每一步选的都是 \(\delta(S)\) 中最轻的边,而割 \((S, V\setminus S)\) 尊重已选的树边。
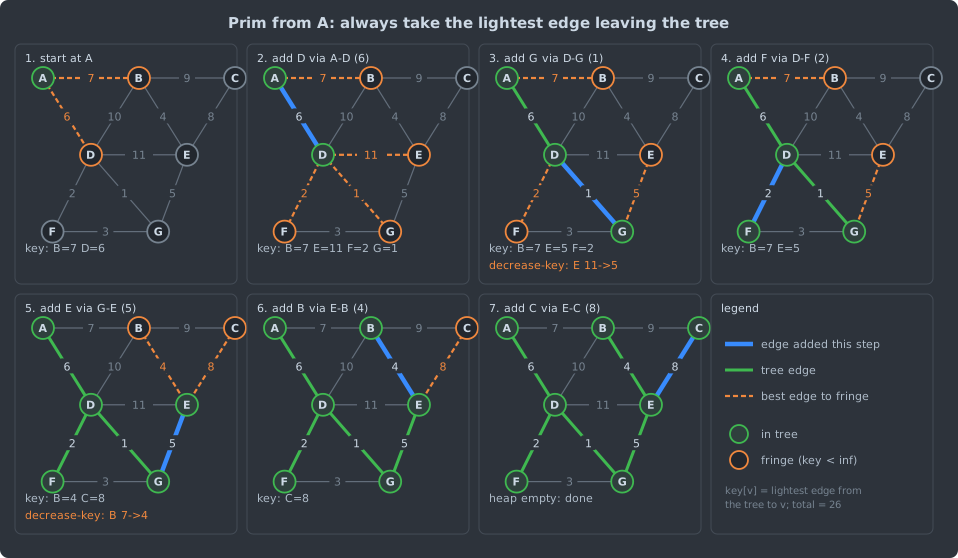
图中每个面板下方是该步结束后的键值表。有两次键值下降,也就是 decrease-key:
- 加入 G 后,G-E(5)比 D-E(11)更轻,E 的键值 \(11\to 5\);
- 加入 E 后,E-B(4)比 A-B(7)更轻,B 的键值 \(7\to 4\)。
最终得到的树与 Kruskal 相同,总权重 26。
与 Dijkstra 的差别
Prim 与 Dijkstra 的代码骨架相同,只有松弛式不同:
\[ \text{Prim: } \text{key}[v] \leftarrow \min\bigl(\text{key}[v],\ w(u,v)\bigr), \qquad \text{Dijkstra: } \text{dist}[v] \leftarrow \min\bigl(\text{dist}[v],\ \text{dist}[u] + w(u,v)\bigr). \]
Prim 的键值只看一条边,所以它对负权不敏感;Dijkstra 的键值是路径长度,负权会破坏”出堆即最终值”的性质。这是两种算法在负权上表现不同的根源。
四种优先队列实现
reproduce/mst.c
实现了下面前三种,第四种只作理论参照:
| 实现 | 时间复杂度 | 额外空间 | 说明 |
|---|---|---|---|
| 数组,线性扫描取最小 | \(O(n^2 + m)\) | \(O(n)\) | 与边权分布无关;完全图可以不物化边表 |
| 索引二叉堆(indexed binary heap)+ decrease-key | \(O(m\log n)\) | \(O(n)\) | 堆里每个顶点最多一项 |
| 懒堆(lazy heap):键值变小时插入新项,出堆时跳过过期项 | \(O(m\log m)\) | \(O(m)\) | 免写 decrease-key,堆可能涨到 \(m\) 项 |
| Fibonacci 堆 | \(O(m + n\log n)\) | \(O(n)\) | Fredman–Tarjan 1987;均摊 \(O(1)\) decrease-key |
二叉堆版的核心循环(摘自 reproduce/mst.c 的
prim_heap()):
for (long a = g->off[u]; a < g->off[u + 1]; a++) {
    int v = g->adj[a].to;
    st->scanned++;
    if (done[v]) continue;
    uint64_t k = ekey(g, g->adj[a].eid);
    st->cmps++;
    if (k >= q.key[v]) continue;
    q.key[v] = k;
    if (q.pos[v] < 0) {
        q.h[q.size] = v; q.pos[v] = q.size; q.size++;
        st->heap_ins++;
    } else {
        st->heap_dec++;
    }
    ih_up(&q, q.pos[v], st);
    if (q.size > st->heap_max) st->heap_max = q.size;
}
\(O(m\log n)\) 是最坏情况:每条边都触发一次 decrease-key。随机边权下 decrease-key 远少于 \(m\)。Filter-Kruskal 论文(ALENEX 2009)指出,Jarník–Prim 用二叉堆在随机边权下的期望时间是 \(O(m + n\log n\log(m/n))\),它引用的是 Noshita(1985)对 Dijkstra 算法期望复杂度的分析。第六节的计数与这个量级吻合:decrease-key 次数在 \(n\ln(m/n)\) 的 90% 到 99% 之间。同一节还构造了一组让每条边都触发 decrease-key 的权重,这时懒堆会涨到 838 万项。
五、Borůvka:所有分量同时选边
算法
- 开始时每个顶点自成一个分量;
- 每一轮,每个分量找出一端在自己内部、另一端在外部的最轻边;
- 把这些边全部选入,按它们合并分量;
- 重复,直到没有跨分量的边。
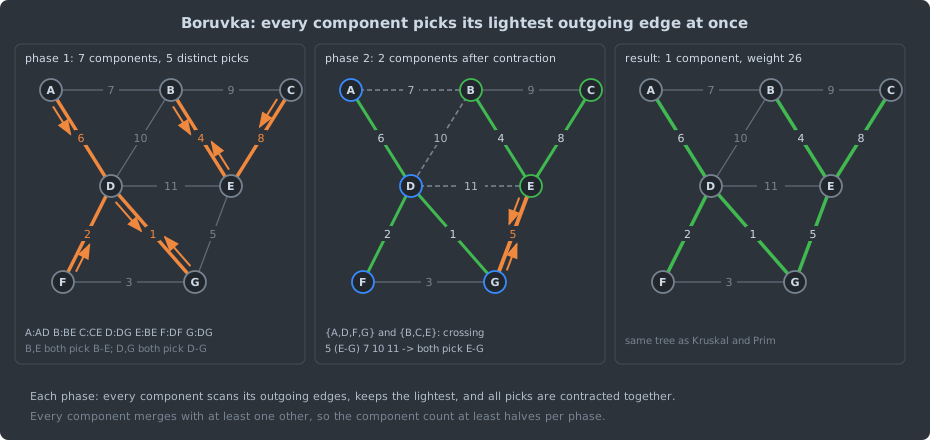
第一轮里有两对顶点选中了同一条边:B 和 E 都选 B-E,D 和 G 都选 D-G。所以 7 个选择只贡献了 5 条不同的边,合并后剩两个分量。第二轮两个分量的跨分量边是 E-G(5)、A-B(7)、B-D(10)、D-E(11),两边都选 E-G,一轮结束。
轮数:每个分量至少和另一个分量合并,所以每轮分量数至少减半,最多 \(\lceil\log_2 n\rceil\) 轮。每轮扫描一遍边,总时间 \(O(m\log n)\)。实现上通常把已经落在同一分量内部的边永久删掉(本文实现即如此),后面的轮次扫描的边越来越少。
正确性:在严格全序下,每个分量选中的边是它那个割上唯一的最轻边,由割性质严格版,它属于唯一的那棵 MST。所以同一轮选中的边全部属于同一棵树,不可能成环。
并列边必须用统一的次序打破
严格全序这个前提不能省。下图是最小的反例:三角形三条边权都是 1。
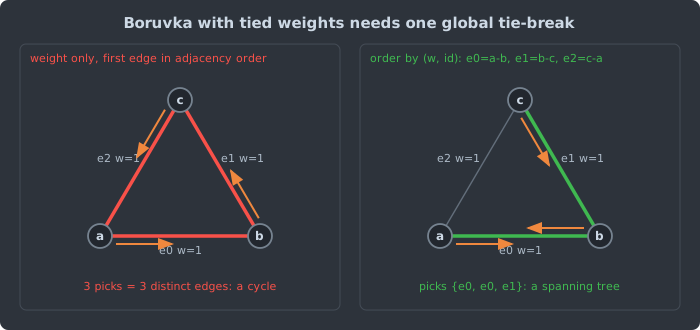
每个顶点只比较权重、取邻接表里遇到的第一条最轻边时,三个顶点可能各选一条不同的边,一次性加入就成了环。改成按 \((w,\text{id})\) 比较后,所有分量对并列边的偏好一致,环不会出现。
./mst ties 100000 1
统计了这个问题的实际频率(邻接表顺序随机打乱):
| 输入 | 只比较权重 | 按 \((w, \text{id})\) |
|---|---|---|
| 三条边权都为 1 的三角形 | 100,000 次中 24,999 次成环(25.0%) | 0 次 |
| \(n=50\)、\(m=150\) 的随机图,边权取 1 或 2 | 100,000 次中 21,109 次成环(21.1%) | 0 次 |
三角形的 25%
可以直接算出来:每个顶点在两条边中等概率选一条,8
种组合里恰有 2 种首尾相接成环。NetworkX 3.4.2 的
boruvka_mst_edges()
在文档里要求”边权必须互不相同,否则结果可能不是树”,说的就是这个问题。
为什么理论和并行都从 Borůvka 出发
Borůvka 每一轮里各分量找最轻出边的工作互不依赖,天然适合并行和分布式:
- Gallager、Humblet、Spira(ACM TOPLAS 1983)的分布式 MST 算法(GHS)让每个”片段”(fragment)并发地找最小出边再合并,这是 Borůvka 思路在异步消息传递模型中的实现。论文假设边权互异,消息数不超过 \(5n\log_2 n + 2m\)。
- Vineet 等人(High Performance Graphics 2009)在 GPU 上实现 MST 时采用的也是 Borůvka 的递归收缩框架。
- 第二节提到的 KKT、Chazelle、Pettie–Ramachandran 算法都以 Borůvka 步作为基本收缩操作。
六、实验:比较次数、decrease-key 与计时
环境与口径
- 程序:
reproduce/mst.c,含 Kruskal(自写归并排序加并查集)、Prim 的三种实现(索引二叉堆、懒堆、数组)和 Borůvka(每轮删除分量内部边)。 - 编译运行:在
reproduce/目录下执行sh run.sh 5,即gcc -O2 -Wall -Wextra -o mst mst.c之后依次运行测试和基准。计时部分用taskset -c 5绑定到 5 号核。 - 环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,GCC 16.1.1。
- 输入:先生成随机生成树保证连通,再加入不重复的随机边;边权为 32 位均匀随机数,随机种子 1。\(n=4096\) 时平均度数 \(2m/n\) 取 4、16、64、256、1024 和完全图(\(m=8{,}386{,}560\));另有 \(n=2^{20}\) 的两组稀疏图。
- 计时:每个配置运行 5 次取中位数;整个脚本运行 3
次,表中是 3 个中位数的中位数。原始输出在
reproduce/results/,plot_bench.py负责汇总和绘图。 - 计数器(比较次数、decrease-key 次数等)与时钟无关,3 次运行逐字节一致。计时只看相对趋势:机器上同时有其他负载,而且 Prim 使用的邻接数组(CSR)是预先建好的,不计入算法时间,其构建时间单独列出。
正确性测试(./mst test):
- 20,000 个随机小图(\(n\le 7\),\(m\le 14\),含自环和平行边,一半的图边权只取 1 到 3),五种实现的权重都与暴力枚举一致;
- 300 个中等规模图(\(n\le 601\)),五种实现返回的边集完全相同,并且满足第一节的最优性判据;
- 这 20,300 个图中有 7,307 个不连通,用来检验最小生成森林。
我还用变异测试确认测试确实能抓到错误:让 Borůvka 的一侧对并列边取最后一条、让 Kruskal 不做成环检查,这两个变体都被测试判为失败。
操作计数(\(n=4096\),随机边权)
| 平均度数 | \(m\) | Kruskal 排序比较次数 | Kruskal 实际考察的边 | Prim 堆 decrease-key | \(n\ln(m/n)\) | Prim 懒堆峰值 | Borůvka 轮数 |
|---|---|---|---|---|---|---|---|
| 4 | 8,192 | 96,103 | 8,184 | 2,581 | 2,839 | 3,058 | 5 |
| 16 | 32,768 | 450,083 | 15,181 | 8,165 | 8,517 | 8,619 | 5 |
| 64 | 131,072 | 2,062,368 | 18,361 | 13,953 | 14,196 | 14,410 | 5 |
| 256 | 524,288 | 9,298,648 | 16,844 | 19,481 | 19,874 | 19,895 | 5 |
| 1024 | 2,097,152 | 41,388,976 | 16,706 | 25,105 | 25,552 | 25,536 | 6 |
| 完全图 | 8,386,560 | 182,286,473 | 21,231 | 30,969 | 31,229 | 31,379 | 5 |
从这张表能读出三件事:
- Kruskal 排了所有边,只用了前面很少一段。完全图上排序比较了 1.82 亿次,而选够 4095 条树边只需要考察排序后的前 21,231 条边,占全部边的 0.25%。qKruskal 和 Filter-Kruskal 的出发点就是只对”可能有用”的那一段排序。
- 随机边权下 decrease-key 很少。decrease-key 次数与 \(n\ln(m/n)\) 的比值在 0.91 到 0.99 之间,远小于最坏情况的 \(m\)。所以二叉堆版 Prim 在稠密随机图上的主要开销是扫一遍邻接表,也就是每条边一次比较。
- Borůvka 的轮数远低于上界。\(\lceil\log_2 4096\rceil = 12\),实际只要 5 到 6 轮;第一轮后剩下约 25% 的分量(完全图上是 1,029 个),之后每轮大约剩五分之一。
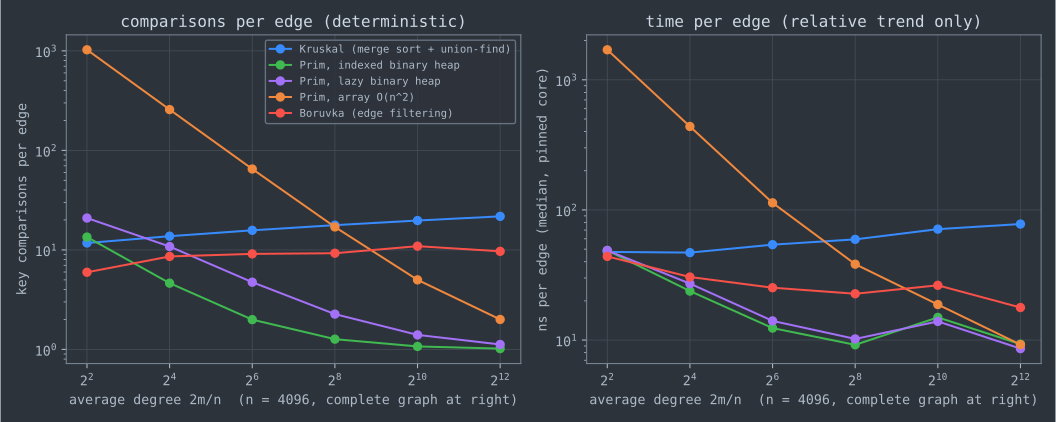
下图左边是每条边摊到的比较次数,右边是每条边摊到的时间:
计时(中位数,毫秒)
\(n=4096\),随机边权:
| 平均度数 | Kruskal | Prim 索引堆 | Prim 懒堆 | Prim 数组 | Borůvka | 建邻接数组 |
|---|---|---|---|---|---|---|
| 4 | 0.39 | 0.40 | 0.40 | 13.93 | 0.36 | 0.05 |
| 16 | 1.54 | 0.78 | 0.89 | 14.35 | 1.00 | 0.16 |
| 64 | 7.09 | 1.62 | 1.84 | 14.86 | 3.31 | 0.69 |
| 256 | 31.15 | 4.82 | 5.35 | 20.08 | 11.90 | 2.84 |
| 1024 | 149.31 | 31.33 | 29.18 | 39.33 | 55.26 | 22.23 |
| 完全图 | 653.32 | 78.01 | 72.12 | 77.39 | 149.17 | 81.23 |
\(n=2^{20}=1{,}048{,}576\),随机边权(数组 Prim 为 \(O(n^2)\),不参与):
| 平均度数 | Kruskal | Prim 索引堆 | Prim 懒堆 | Borůvka | 建邻接数组 | Borůvka 轮数 |
|---|---|---|---|---|---|---|
| 4 | 228.19 | 681.86 | 796.36 | 243.56 | 64.12 | 8 |
| 16 | 861.44 | 1136.17 | 1617.64 | 785.46 | 303.89 | 8 |
完全图,权重 \(w(i,j) = n(n-i)+j\)(\(i<j\))。这组权重让从顶点 0 出发的 Prim 按 \(0,1,2,\ldots\) 的顺序取出顶点,每条边都触发一次键值下降:
| Kruskal | Prim 索引堆 | Prim 懒堆 | Prim 数组 | Borůvka | |
|---|---|---|---|---|---|
| 时间(ms) | 217.30 | 24.04 | 552.95 | 29.64 | 51.42 |
| 关键计数 | 考察 8,382,466 条边 | decrease-key 8,382,465 次(\(=m-n+1\)) | 堆峰值 8,382,466 项 | 比较 \(n^2\) 次 | 1 轮 |
解读
“稀疏用 Kruskal、稠密用 Prim”在这里只对了一半。 \(n=4096\) 时,所有数据都能放进 CPU 缓存,Prim 从平均度数 16 起就比 Kruskal 快,差距随密度拉大到 8 倍多(完全图上 653 ms 对 78 ms)。原因在上面的计数表:Kruskal 做 \(\Theta(m\log m)\) 次排序比较,而随机权重下的二叉堆 Prim 只做约 \(m\) 次比较加 \(O(n\log n\log(m/n))\) 的堆操作。即使把建邻接数组的时间加回去,Prim 在中高密度上仍然领先。
\(n=2^{20}\) 时结论反过来。Kruskal 和 Borůvka 比 Prim 快 1.3 到 3 倍,虽然平均度数为 16 时 Prim 的比较次数只有 Kruskal 的三分之一(6,106 万次对 1.82 亿次)。这时 Prim 的堆和键值数组有上百万项,每次松弛和堆调整都是随机访存;Kruskal 的归并排序和 Borůvka 的边扫描都是顺序访存。Filter-Kruskal 论文的说法是”在实践中 Kruskal 在稀疏图上胜过 Jarník–Prim”,与这组数据一致;但本文 \(n=4096\) 的结果表明,这条经验依赖于数据规模和缓存,不只取决于密度。
数组 Prim 的价值在于最坏情况,而不在于平均情况。 随机权重的完全图上,数组版(77 ms)与堆版(78 ms)持平,因为堆版几乎没有 decrease-key。数组版的优势在于代价与权重无关:\(n^2\) 次比较,没有堆,也不必把 \(n^2\) 条边存成边表。点集的两两距离可以即时算出时,它只需要 \(O(n)\) 额外空间。
懒堆的风险在最坏情况的内存上。 在
decrease-key 最坏的权重下,索引堆只多了 decrease-key
次数。这组权重下每次上滤都立即停止,所以只用 24
ms。懒堆则把每次改进都插入为新项,堆涨到 838 万项、用时 553
ms,是索引堆的 23 倍。NetworkX 的
prim_mst_edges() 用 heapq
的懒插入实现,在这类输入上会有同样的内存曲线。
并查集不是瓶颈。 所有配置里 Kruskal 每次 find 平均跟随的父指针数在 0.88 到 1.00 之间(例如完全图随机权重:42,462 次 find,40,567 次跳转)。这与 \(\alpha\) 的理论结论一致,也说明优化 Kruskal 应该从排序入手。
七、工程选型与陷阱
选型
| 条件 | 选择 | 依据 |
|---|---|---|
| 输入是边表,图很大、偏稀疏 | Kruskal;对密一些的图考虑 Filter-Kruskal | 顺序访存;第六节 \(n=2^{20}\) 实测;SciPy 1.14.1
的 minimum_spanning_tree 即为 Kruskal |
| 已有邻接表,数据能放进缓存,中高密度 | Prim + 索引二叉堆 | 随机权重下 decrease-key 约为 \(n\ln(m/n)\);第六节 \(n=4096\) 实测 |
| 完全图、两两距离可即时计算 | 数组 Prim,\(O(n^2)\) 时间、\(O(n)\) 额外空间 | 不物化 \(n^2/2\) 条边,最坏情况与权重无关 |
| 多核、GPU、分布式 | Borůvka 系 | 每轮各分量独立选边,轮数不超过 \(\lceil\log_2 n\rceil\);GHS 1983、Vineet 等 2009 |
| 边已排序,或边权是小范围整数 | Kruskal + 计数/基数排序 | 排序代价消失,剩 \(O(m\,\alpha(m,n))\) |
| 需要可复现的输出 | 所有实现都按 \((w, \text{id})\) 比较 | 严格全序下 MST 唯一;SciPy 用
np.argsort(kind='stable') 得到同样效果 |
两个生产实现的具体做法(以钉住的版本为准):
- SciPy
1.14.1,
scipy/sparse/csgraph/_min_spanning_tree.pyx:先用np.argsort(data, kind='stable')对边排序,再在_min_spanning_tree()里按 Kruskal 扫描,并用按秩合并连接两棵树;源码注释写的是 “Compress both paths”,实际只把两个端点直接挂到根上,不是完整的路径压缩。 - NetworkX
3.4.2,
networkx/algorithms/tree/mst.py:minimum_spanning_tree()默认algorithm="kruskal",另可选"prim"与"boruvka";ignore_nan参数用于处理 NaN 权重。
陷阱
| 陷阱 | 后果 | 做法 |
|---|---|---|
| 图不连通 | Kruskal 得到森林;只从一个起点跑的 Prim 只覆盖一个分量 | 检查边数是否为 \(n-c\);Prim 对每个未访问顶点重新起步(本文实现) |
比较函数写成 return a->w - b->w |
差值溢出或截断成 int
后符号出错,排序不再是全序 |
写成 (a > b) - (a < b) |
| 浮点边权含 NaN | 比较不满足严格弱序,qsort、std::sort
的行为无定义 |
事先过滤;不要用 \(\varepsilon\) 容差判等,MST 只依赖次序 |
| Borůvka 遇到并列边 | 同一轮选中的边可能成环(第五节:随机小图 21.1%) | 按 \((w, \text{id})\) 比较 |
| 懒堆 Prim | 堆可能涨到 \(m\) 项(第六节:838 万项) | 内存敏感时用索引堆或数组版 |
| 担心递归 find 爆栈 | 按秩合并下深度不超过 \(\lfloor\log_2 n\rfloor\) | 真正要防的是”只做路径压缩、不按秩合并” |
| 自环 | 无害:两端 find 结果相同,自动跳过 | 不需要预处理 |
| 平行边 | 不影响正确性 | 可以只保留最轻的一条,减少排序量 |
八、MST 能回答的相关问题
最小瓶颈路径。MST 上 \(u\) 到 \(v\) 的路径是一条最小瓶颈路径(minimax path),即在所有 \(u\)–\(v\) 路径中,路径上最大边权最小的那一条。证明:设 MST 路径上的最重边为 \(f\),删掉 \(f\) 得到一个割;若另有路径 \(P\) 的最大边权小于 \(w(f)\),\(P\) 必然跨过这个割,跨割边 \(e\) 满足 \(w(e)<w(f)\),于是 \(T-f+e\) 更轻,矛盾。最小瓶颈路径不一定唯一。求”带宽最大的路径”时要用最大生成树:把次序反过来即可。
单链接聚类。Gower 与 Ross(Applied Statistics 1969)指出,单链接层次聚类(single-linkage clustering)与 MST 等价:删掉 MST 中最重的 \(k-1\) 条边,剩下的 \(k\) 个连通分量就是单链接聚类在 \(k\) 类时的结果。Kruskal 的合并顺序就是聚类树的合并顺序。Zahn(IEEE TC 1971)用”删掉明显比邻边长的 MST 边”做聚类,同属这一路线。
欧几里得 MST。平面点集的欧几里得 MST 是 Delaunay 三角剖分的子图(Shamos 与 Hoey,FOCS 1975)。先用 \(O(n\log n)\) 求 Delaunay 三角剖分,它只有 \(O(n)\) 条边,再在上面跑 Kruskal,总共 \(O(n\log n)\),不必处理完全图的 \(n^2/2\) 条边。三角剖分本身见 Voronoi 图与 Delaunay 三角剖分。
Steiner 树。只要求连通一个指定的终端子集 \(R\),并允许借道其他顶点,问题就变成 NP 难的 Steiner 树问题(它在 Karp 1972 年的 21 个 NP 完全问题之列)。经典近似是在 \(R\) 的最短路距离完全图上求 MST 再映射回原图,近似比不超过 \(2(1-1/|R|)\)(Kou、Markowsky、Berman,Acta Informatica 1981);目前最好的近似比是 \(\ln 4+\varepsilon < 1.39\)(Byrka 等,JACM 2013)。
冗余。MST 没有任何冗余,删掉任意一条边图就断开。要求”任一条边断开后仍连通”,就是最小代价 2-边连通生成子图问题,它是 NP 难的:边权全为 1 时,2-边连通图每个顶点度数至少为 2,所以至少有 \(n\) 条边;恰好 \(n\) 条边的 2-边连通生成子图只能是哈密顿圈。这类问题不能靠在 MST 上打补丁精确求解。
九、争论与开放问题
开放问题:比较模型下的确定性线性时间
这是 MST 最有名的开放问题:是否存在确定性的线性时间 MST 算法? 精确的表述需要限定模型,下面三点都来自第二节的文献:
- 允许随机,答案是肯定的(KKT 1995,期望 \(O(m)\));
- 边权是整数、允许字长 RAM 运算,答案也是肯定的(Fredman–Willard 1994);
- 确定性、只允许比较边权时,最好的已知上界是 Chazelle 的 \(O(m\,\alpha(m,n))\)。Pettie–Ramachandran 的算法可证最优,但它的运行时间 \(T^*(m,n)\) 的量级未知。他们在论文结论里把”确定这个算法的最坏复杂度”称为 MSF 问题剩下的主要开放问题。
因此,前两条路线绕开了问题,却没有回答它:随机性和整数位运算对线性时间是不是必需的,目前没有人知道。如果 \(T^*(m,n)=\Theta(m)\),Pettie–Ramachandran 的算法本身就是确定性线性时间算法,只是没有人能证明这一点。
Pettie 与 Ramachandran 还提出了一个更细的问题:他们的最优算法依赖预先计算的小规模最优决策树,那么不借助这类预计算(或类似技术),能否得到最优的一致(uniform)算法?更一般地,有没有问题必须依赖预计算?他们建议先在更简单的 MST 验证问题上研究,因为在指针机模型上,使用预计算决策树的最好验证算法(Buchsbaum 等,1998)与不使用的算法(Tarjan,1979)之间仍差一个 \(\alpha(m,n)\) 因子。
争论:理论最优算法值不值得实现
理论谱系的终点和工程实践几乎没有交集。Filter-Kruskal 的作者评价期望线性时间算法”复杂,且常数因子很大”,转而改进 Kruskal:像快速排序一样按枢轴把边分成轻、重两半,先递归处理轻的一半;处理重的一半之前,先删掉两端已经连通的边。论文证明,对任意图,在随机边权下它的期望时间是 \(O(m + n\log n\log(m/n))\),与二叉堆 Prim 相同;此外它只需要边表,而且作者指出它允许比 Jarník–Prim 更粗粒度、更实用的并行化。
第六节给这场讨论补了一个具体的量:随机权重的完全图上,Kruskal 只用到排序结果的前 0.25%,完整排序的绝大部分工作是浪费的。这正是 Filter-Kruskal 瞄准的冗余。反过来,同一节的 decrease-key 最坏构造说明,“随机边权”这个假设在对抗性或高度结构化的权重下不成立。比如按顶点编号单调递减的权重会让懒堆 Prim 的内存涨到 \(m\)。论文结论依赖的输入假设,是选型时首先要核对的东西。
开放问题:经验法则需要换成代价模型
“稀疏用 Kruskal、稠密用 Prim”这条经验来自只数比较次数的年代。本文的两组规模给出了相反的排名:\(n=4096\) 时 Prim 领先,\(n=2^{20}\) 时 Kruskal 与 Borůvka 领先,而比较次数的排名在两组里并没有反转。一个能同时覆盖比较次数、随机访存和并行度的代价模型,比任何一条密度阈值都更能指导选型。实验基础也薄弱:Filter-Kruskal 论文指出,MST 问题没有公认的真实世界测试集,过去的研究大多使用合成图族,其中就包括本文第六节那种让每条边都触发 decrease-key 的构造。
十、参考资料
源码与文档
- SciPy
v1.14.1,
scipy/sparse/csgraph/_min_spanning_tree.pyx:minimum_spanning_tree()、_min_spanning_tree()。 - NetworkX
3.4.2,
networkx/algorithms/tree/mst.py:minimum_spanning_tree()、kruskal_mst_edges()、prim_mst_edges()、boruvka_mst_edges()。
核心论文
- O. Borůvka, “O jistém problému minimálním”, Práce moravské přírodovědecké společnosti III(3), 1926, 37–58;“Příspěvek k řešení otázky ekonomické stavby elektrovodních sítí”, Elektrotechnický obzor 15, 1926, 153–154.
- V. Jarník, “O jistém problému minimálním (Z dopisu panu O. Borůvkovi)”, Práce moravské přírodovědecké společnosti 6(4), 1930, 57–63.
- J. B. Kruskal, “On the shortest spanning subtree of a graph and the traveling salesman problem”, Proceedings of the AMS 7(1), 1956, 48–50.
- R. C. Prim, “Shortest connection networks and some generalizations”, Bell System Technical Journal 36(6), 1957, 1389–1401.
- E. W. Dijkstra, “A note on two problems in connexion with graphs”, Numerische Mathematik 1, 1959, 269–271.
- D. R. Karger, P. N. Klein, R. E. Tarjan, “A randomized linear-time algorithm to find minimum spanning trees”, JACM 42(2), 1995, 321–328.
- B. Chazelle, “A minimum spanning tree algorithm with inverse-Ackermann type complexity”, JACM 47(6), 2000, 1028–1047.
- S. Pettie, V. Ramachandran, “An optimal minimum spanning tree algorithm”, JACM 49(1), 2002, 16–34.
其他论文与书
- J. Nešetřil, E. Milková, H. Nešetřilová, “Otakar Borůvka on minimum spanning tree problem: Translation of both the 1926 papers, comments, history”, Discrete Mathematics 233(1–3), 2001, 3–36.
- R. L. Graham, P. Hell, “On the history of the minimum spanning tree problem”, Annals of the History of Computing 7(1), 1985, 43–57.
- A. C. Yao, “An \(O(|E|\log\log|V|)\) algorithm for finding minimum spanning trees”, Information Processing Letters 4(1), 1975, 21–23.
- D. Cheriton, R. E. Tarjan, “Finding minimum spanning trees”, SIAM Journal on Computing 5(4), 1976, 724–742.
- M. L. Fredman, R. E. Tarjan, “Fibonacci heaps and their uses in improved network optimization algorithms”, JACM 34(3), 1987, 596–615.
- H. N. Gabow, Z. Galil, T. Spencer, R. E. Tarjan, “Efficient algorithms for finding minimum spanning trees in undirected and directed graphs”, Combinatorica 6(2), 1986, 109–122.
- M. L. Fredman, D. E. Willard, “Trans-dichotomous algorithms for minimum spanning trees and shortest paths”, JCSS 48(3), 1994, 533–551.
- J. Komlós, “Linear verification for spanning trees”, Combinatorica 5(1), 1985, 57–65.
- B. Dixon, M. Rauch, R. E. Tarjan, “Verification and sensitivity analysis of minimum spanning trees in linear time”, SIAM Journal on Computing 21(6), 1992, 1184–1192.
- V. King, “A simpler minimum spanning tree verification algorithm”, Algorithmica 18(2), 1997, 263–270.
- R. E. Tarjan, “Applications of path compression on balanced trees”, JACM 26(4), 1979, 690–715.
- A. L. Buchsbaum, H. Kaplan, A. Rogers, J. R. Westbrook, “Linear-time pointer-machine algorithms for least common ancestors, MST verification, and dominators”, STOC 1998, 279–288.
- R. E. Tarjan, “Efficiency of a good but not linear set union algorithm”, JACM 22(2), 1975, 215–225.
- R. E. Tarjan, J. van Leeuwen, “Worst-case analysis of set union algorithms”, JACM 31(2), 1984, 245–281.
- M. L. Fredman, M. Saks, “The cell probe complexity of dynamic data structures”, STOC 1989, 345–354.
- R. E. Tarjan, Data Structures and Network Algorithms, SIAM, 1983, Chapter 6.
- T. H. Cormen, C. E. Leiserson, R. L. Rivest, C. Stein, Introduction to Algorithms, 3rd ed., MIT Press, 2009, Chapters 21 and 23.
- R. G. Gallager, P. A. Humblet, P. M. Spira, “A distributed algorithm for minimum-weight spanning trees”, ACM TOPLAS 5(1), 1983, 66–77.
- V. Vineet, P. Harish, S. Patidar, P. J. Narayanan, “Fast minimum spanning tree for large graphs on the GPU”, High Performance Graphics 2009, 167–171.
- V. Osipov, P. Sanders, J. Singler, “The Filter-Kruskal minimum spanning tree algorithm”, ALENEX 2009, 52–61.
- K. Noshita, “A theorem on the expected complexity of Dijkstra’s shortest path algorithm”, Journal of Algorithms 6(3), 1985, 400–408.
- J. C. Gower, G. J. S. Ross, “Minimum spanning trees and single linkage cluster analysis”, Applied Statistics 18(1), 1969, 54–64.
- C. T. Zahn, “Graph-theoretical methods for detecting and describing gestalt clusters”, IEEE Transactions on Computers C-20(1), 1971, 68–86.
- M. I. Shamos, D. Hoey, “Closest-point problems”, FOCS 1975, 151–162.
- R. M. Karp, “Reducibility among combinatorial problems”, in Complexity of Computer Computations, Plenum, 1972, 85–103.
- L. Kou, G. Markowsky, L. Berman, “A fast algorithm for Steiner trees”, Acta Informatica 15(2), 1981, 141–145.
- J. Byrka, F. Grandoni, T. Rothvoß, L. Sanità, “Steiner tree approximation via iterative randomized rounding”, JACM 60(1), 2013.
实验
reproduce/mst.c:五种实现、暴力校验、并列边成环统计与基准;reproduce/run.sh:完整复现命令。reproduce/plot_bench.py:汇总reproduce/results/run{1,2,3}.txt并生成mst-bench.svg。reproduce/draw_figures.py:计算例图上三种算法的每一步,并生成本文的全部分步图。
系列导航: - 上一篇:Bellman-Ford 与路由协议:负环、SPFA 与距离向量收敛 - 下一篇:Tarjan 算法族:SCC、割点、桥的统一框架
相关阅读: - Dijkstra 与 A*:非负权、启发式与工程优先队列 - 网络流与二分匹配 - Voronoi 图与 Delaunay 三角剖分 - 随机化算法
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。
基数排序:绕开比较下界的代价,从 LSD、American flag sort 到 ska_sort
比较下界只约束比较模型,基数排序把代价转移到键长和内存访问上。本文推导代价模型,用缓存模拟与绑核实测解释位宽为何停在 8 到 11 位,并对照 ska_sort、ClickHouse、DuckDB 与 IPS²Ra 说明它何时赢、何时输。