网络流最容易被误解成“找几条能装下流量的路径”。这句话只说对了操作,没有说清证书:最大流算法最后必须同时给出一个割,证明再也不可能把更多流从源点送到汇点。残量图(residual graph)负责描述还能怎么改,最小割负责证明为什么不能再改。
本文按“模型与证书 → 算法谱系 → 可复现实现 →
工程源码”的顺序展开。完整 C++ 程序在同目录
reproduce/network_flow_lab.cpp,实现
Edmonds-Karp、Dinic、FIFO push-relabel 加 gap 启发式和
Hopcroft-Karp,并用暴力最小割 /
暴力匹配对拍。实验只报告增广次数、BFS/DFS
访问残量边数、push/relabel/gap
次数,不用墙钟时间给算法排名。
一、模型:流、残量图与割证书
设流网络为 \(G=(V,E,s,t,c)\),其中 \(s\) 是源点,\(t\) 是汇点,容量函数 \(c:E\to\mathbb{R}_{\ge 0}\)。可行流 \(f\) 满足两类约束:
\[ 0 \le f(u,v) \le c(u,v), \qquad (u,v)\in E, \]
以及对所有 \(u\notin\{s,t\}\) 的流量守恒:
\[ \sum_v f(v,u)=\sum_v f(u,v). \]
流值可写成源点净流出:
\[ |f|=\sum_v f(s,v)-\sum_v f(v,s). \]
给定一个当前流,残量网络 \(G_f\) 有两类边:
- 若 \(f(u,v)<c(u,v)\),保留前向残量边 \((u,v)\),容量 \(c_f(u,v)=c(u,v)-f(u,v)\);
- 若 \(f(u,v)>0\),加入反向残量边 \((v,u)\),容量 \(c_f(v,u)=f(u,v)\)。
反向边不是“倒着流”的物理管道,而是撤销已有决策的记账方式。最大流算法的共同不变量是:只要残量图里还有从 \(s\) 到 \(t\) 的路,就能沿这条路增广;若没有这样的路,从 \(s\) 在残量图中可达的点集 \(S\) 与其补集 \(T=V\setminus S\) 给出一个最小割。
对于任意 \(s\)-\(t\) 割 \((S,T)\),容量为
\[ c(S,T)=\sum_{u\in S, v\in T} c(u,v). \]
弱对偶很直接:任意流穿过割的净流量不超过割容量,所以 \(|f|\le c(S,T)\)。当残量图中 \(t\) 不可达时,所有从 \(S\) 到 \(T\) 的边都被饱和,所有从 \(T\) 回到 \(S\) 的边流量为 \(0\),于是 \(|f|=c(S,T)\)。这就是 Ford 和 Fulkerson 1956 年论文中的最大流最小割定理,也是工程调试时最有用的正确性证书。
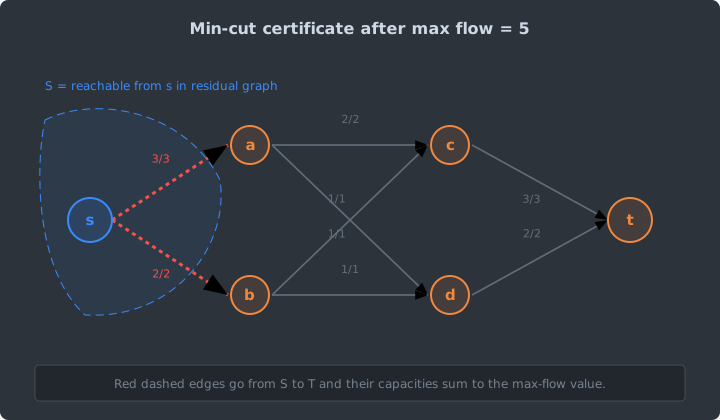
这张图由 reproduce/draw_flow_figures.py
重新运行同一个小网络得到。边标注是
flow/capacity;红色虚线边跨过割,容量和等于最大流值
\(5\)。
二、谱系:从增广路到近线性时间
网络流的历史可以看作“怎样更聪明地修改残量图”的历史。
| 年份 | 工作 | 本文使用的结论 |
|---|---|---|
| 1956 | Ford 与 Fulkerson, “Maximal Flow Through a Network”, Canadian Journal of Mathematics 8 | 增广路方法、最大流最小割定理;整数容量时每次至少增广 \(1\) |
| 1970 | Dinic, “Algorithm for Solution of a Problem of Maximum Flow in a Network with Power Estimation”, Soviet Mathematics Doklady 11 | BFS 分层图与阻塞流,常用界 \(O(V^2E)\) |
| 1972 | Edmonds 与 Karp, “Theoretical Improvements in Algorithmic Efficiency for Network Flow Problems”, JACM 19(2) | 总是选最短增广路,得到 \(O(VE^2)\) |
| 1973 | Hopcroft 与 Karp, “An \(n^{5/2}\) Algorithm for Maximum Matchings in Bipartite Graphs”, SIAM J. Comput. 2(4) | 一轮内同时增广一组最短交替路,二分匹配 \(O(E\sqrt V)\) |
| 1988 | Goldberg 与 Tarjan, “A new approach to the maximum-flow problem”, JACM 35(4) | 不守恒的预流(preflow)、push 与 relabel |
| 1995 | Zwick, “The smallest networks on which the Ford-Fulkerson maximum flow procedure may fail to terminate”, TCS 148(1) | 无理容量下,任意选增广路的 Ford-Fulkerson 过程可能不终止 |
| 1997 | Cherkassky 与 Goldberg, “On Implementing the Push—Relabel Method for the Maximum Flow Problem”, Algorithmica 19(4) | 最高标号、global relabel、gap 等实现启发式的实验研究入口 |
| 2022 | Chen、Kyng、Liu、Peng、Probst Gutenberg、Sachdeva, “Maximum Flow and Minimum-Cost Flow in Almost-Linear Time”, FOCS 2022 / arXiv:2203.00671 | 多项式有界整数容量与费用上的 \(m^{1+o(1)}\) 理论突破;FOCS 2022 Best Paper |
这里有两个容易混在一起的边界。
第一,Ford-Fulkerson 是一类“只要找得到增广路就增广”的方法。整数容量保证终止,并给出 \(O(E|f^*|)\) 这样的伪多项式界;无理容量时,不恰当的增广路选择可能无限逼近最优值而不达到它。Zwick 1995 年的论文题名已经点明了“最小网络”这一点,本文只引用其存在性,不复画该构造。
第二,近线性时间最大流是理论前沿,不等于现有通用库已经切到这条路线。Chen 等人的 arXiv 摘要写明结果针对有 \(m\) 条边、需求/费用/容量为多项式有界整数的有向图,运行时间为 \(m^{1+o(1)}\);其技术复杂度与常见工程库中的 Dinic / push-relabel 仍有明显间隙。
三、Ford-Fulkerson 与 Edmonds-Karp:路径选择决定命运
Ford-Fulkerson 的框架可以写成三步:只要残量图中存在一条 \(s\)-\(t\) 路径 \(p\),就取 \(p\) 上最小残量作为 \(\Delta\),再沿 \(p\) 增广 \(\Delta\)。
问题在于“找哪条路”。如果每次用深度优先搜索(Depth-First Search,DFS)按固定邻接顺序找路,整数容量时虽然会停,但增广次数可能依赖最大流值本身;当容量很大时,这不是强多项式算法。
同目录程序的 bad
模式保留了两个小实验。unit_paths
是一组单位容量并行短路径:Edmonds-Karp 每次 BFS
只能确认一条增广路,因此增广次数等于最大流值;Dinic
在第一轮分层图里一次阻塞流就完成。表中的“BFS
边访问”来自程序计数,不是计时。
| \(k\) | \(V\) | \(E\) | 最大流 | EK 增广 | EK BFS 边访问 | Dinic phase | Dinic BFS 边访问 |
|---|---|---|---|---|---|---|---|
| 8 | 18 | 31 | 8 | 8 | 195 | 1 | 70 |
| 16 | 34 | 63 | 16 | 16 | 711 | 1 | 142 |
| 32 | 66 | 127 | 32 | 32 | 2703 | 1 | 286 |
| 64 | 130 | 255 | 64 | 64 | 10527 | 1 | 574 |
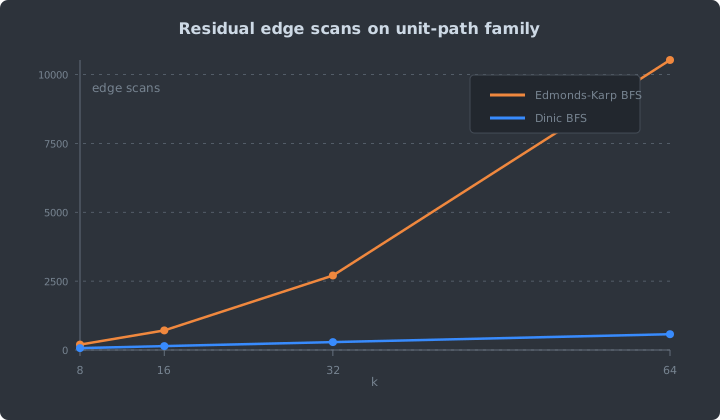
这不是 Edmonds-Karp 的最坏情况证明;它只说明即便每条路径很短,BFS 增广仍可能“一次只吃一单位”。Edmonds-Karp 的理论界来自更强的距离单调性:每次增广后,残量图中从 \(s\) 到任意点的 BFS 距离不会下降;每条边成为瓶颈后,若要再次成为瓶颈,相关距离至少增加 \(2\)。于是增广次数为 \(O(VE)\),每次 BFS 为 \(O(E)\),总时间 \(O(VE^2)\)。
bad.csv 还列出经典 DFS
对抗顺序:两条大容量通路之间放一条容量为 \(1\)
的横边,并让路径选择器反复走“经过横边、再撤销横边”的路径。容量为
\(U\) 时可以构造 \(2U\) 次单位增广,而最大流值也是
\(2U\)。这说明朴素 DFS
版本的问题是路径选择策略,而不是残量图概念本身。
四、Dinic:分层图把“最短路”批处理
Dinic 的每一轮分成两步:
- 在残量图上从 \(s\) 做 BFS,得到层数 \(level[v]\);只保留满足 \(level[v]=level[u]+1\) 的残量边,形成分层图(layered graph)。
- 在分层图里找一个阻塞流(blocking flow):让每条从 \(s\) 到 \(t\) 的分层路径至少有一条边被饱和。
同一个例子由
reproduce/network_flow_lab.cpp trace 输出:
first BFS levels:
s=0 a=1 b=1 c=2 d=2 t=3

layered edges in phase 1:
s -> a residual=3
s -> b residual=2
a -> c residual=2
a -> d residual=1
b -> c residual=1
b -> d residual=1
c -> t residual=3
d -> t residual=2
augment in level graph: +2, phase_flow=2
augment in level graph: +1, phase_flow=3
augment in level graph: +1, phase_flow=4
augment in level graph: +1, phase_flow=5
after blocking flow, first phase total=5
图和输出来自同一组边:s->a 容量 \(3\),s->b 容量
\(2\),中间经
c、d 到
t。第一轮分层图已经能送出全部 \(5\)
单位流。更复杂的图上,阻塞流只保证消灭当前最短长度的所有增广路;下一轮
BFS 若仍可达 \(t\),\(level[t]\) 会严格增加。
通用 Dinic 的常用复杂度界是 \(O(V^2E)\):最多 \(V-1\) 轮分层,每轮用当前弧优化求阻塞流。对于二分匹配这类单位容量、交替层结构的网络,Dinic 的行为与 Hopcroft-Karp 非常接近,可得到 \(O(E\sqrt V)\) 级别的阶段数分析。更一般的单位容量图还有更细的界,本文不展开。
实现时最容易错的是当前弧。正文不放完整程序,只摘取同目录 C++ 的关键循环:
long long dfs(int u, int t, long long f) {
    if (u == t) return f;
    for (int& i = it[u]; i < (int)g[u].size(); ++i) {
        Edge& e = g[u][i];
        if (e.cap <= 0 || level[e.to] != level[u] + 1) continue;
        long long ret = dfs(e.to, t, min(f, e.cap));
        if (ret) {
            e.cap -= ret;
            g[e.to][e.rev].cap += ret;
            return ret;
        }
    }
    return 0;
}
int& i = it[u]
是当前弧指针。某条边被证明不能继续通向汇点后,本轮阻塞流内不会再从同一个顶点重复扫描它;否则
Dinic 在稠密图上的常数会膨胀得很快。
五、Push-relabel:不找完整路径,先允许“水位过高”
Push-relabel 改变了思路:它不维护普通流,而维护预流(preflow)。除 \(s\) 与 \(t\) 外,顶点可以暂时有正的 excess,也就是流入大于流出。算法给每个顶点维护高度 \(h[v]\),只允许从高处向低一层的残量边 push;若一个有 excess 的顶点无路可推,就 relabel 到比某个可达邻居高一层。
基本操作是 push 与 relabel。若 \(excess[u]>0\)、\(c_f(u,v)>0\) 且 \(h[u]=h[v]+1\),就向 \((u,v)\) 推送 \(\min(excess[u], c_f(u,v))\);若 \(u\) 没有可推的出边,则令
\[ h[u] = 1 + \min_{(u,v)\in E_f} h[v]. \]
本文程序实现的是 FIFO 活跃队列加 gap 启发式。gap 的含义是:若某个高度 \(k\) 已经没有顶点,那么高度大于 \(k\) 且小于 \(n\) 的顶点不可能再到达汇点,可以整体抬到“无穷高”附近,之后把多余预流推回源点方向。
Goldberg 与 Tarjan 1988 年论文给出了 push-relabel 的理论基础;Cherkassky 与 Goldberg 1997 年的实验研究则是理解 highest-label、global relabel、gap 等启发式的重要入口。本文自测的 FIFO+gap 不是为了胜过库实现,只用来把 push/relabel/gap 的计数暴露出来。
六、二分匹配:最大流归约与 Hopcroft-Karp
给定二分图 \(G=(L\cup R,E)\),匹配是边集 \(M\subseteq E\),且每个顶点最多被一条匹配边覆盖。把最大匹配归约为最大流的方法是:
- 加源点 \(s\) 与汇点 \(t\);
- 对每个 \(u\in L\) 加边 \((s,u)\),容量 \(1\);
- 对每条二分边 \((u,v)\) 加边 \((u,v)\),容量 \(1\);
- 对每个 \(v\in R\) 加边 \((v,t)\),容量 \(1\)。
整数容量最大流存在整数最优解,所以流值等于匹配大小:从匹配到流显然成立;从流到匹配时,容量 \(1\) 保证每个左右顶点最多用一次。
Hopcroft-Karp 不显式建这个流网络,但做的是同一件事的特化:BFS 从所有未匹配的左侧顶点出发,按“未匹配边、匹配边、未匹配边……”构造交替分层;DFS 在这些最短交替路上找一组点不相交的增广路并同时翻转。每一阶段为 \(O(E)\),阶段数为 \(O(\sqrt V)\),总时间 \(O(E\sqrt V)\)。
二分图里还有两个和网络流直接相连的定理:
- Hall 定理:存在覆盖 \(L\) 的匹配,当且仅当任意 \(S\subseteq L\) 都满足 \(|N(S)|\ge |S|\)。它可以用最大流最小割定理证明。
- Kőnig 定理:二分图最大匹配大小等于最小顶点覆盖大小。这也是最大流最小割在二分图上的具体形态。
同目录程序对 Hopcroft-Karp 做了 120
组小规模随机图对拍:L,R\le 6
时用递归枚举所有匹配作为暴力基线,确保算法输出的匹配数一致。
七、复现实验:只看与时钟无关的计数
实验环境来自实际查询:
Linux 6.6.87.2-microsoft-standard-WSL2 x86_64 GNU/Linux
g++ (GCC) 16.1.1 20260430
CPU: 12th Gen Intel(R) Core(TM) i9-12900K, 24 logical CPUs编译、对拍和生成数据的命令如下,taskset -c 12
只用于固定运行核;本文不报告耗时,所以系统负载不会影响表中的计数。
cd post/algorithms/47-network-flow/reproduce
g++ -std=c++17 -O2 -Wall -Wextra -pedantic network_flow_lab.cpp -o network_flow_lab
taskset -c 12 ./network_flow_lab check
taskset -c 12 ./network_flow_lab metrics > metrics.csv
taskset -c 12 ./network_flow_lab bad > bad.csv
taskset -c 12 ./network_flow_lab trace > trace.txt
g++ -std=c++17 -O1 -g -fsanitize=address,undefined -fno-omit-frame-pointer \
    -Wall -Wextra -pedantic network_flow_lab.cpp -o network_flow_lab_asan
taskset -c 12 ./network_flow_lab_asan check
实际输出两次都是
check: ok directed=200 bipartite=120,分别对应普通编译和
ASan/UBSan 编译。
随机有向图实验使用 \(m=4n\),每个规模 \(3\) 个种子,容量为 \(1\) 到 \(20\) 的整数,并额外放一条从 \(0\) 到 \(n-1\) 的链保证可达。下表取中位数:
| \(n\) | \(m\) | 最大流中位数 | EK 增广 | EK BFS 边访问 | Dinic phase | Dinic DFS 边访问 | PR push | PR relabel | gap |
|---|---|---|---|---|---|---|---|---|---|
| 24 | 96 | 34 | 7 | 978 | 3 | 555 | 74 | 53 | 1 |
| 48 | 192 | 27 | 7 | 1739 | 4 | 1513 | 217 | 145 | 1 |
| 96 | 384 | 21 | 6 | 3132 | 4 | 2925 | 419 | 319 | 1 |
这些数字不能推出“哪个算法更快”。它们只能说明三个实现确实走了不同路径:Edmonds-Karp 的主要成本在反复 BFS;Dinic 用较少 phase 批处理最短路;push-relabel 的主要可观测事件是局部 push 和 relabel。若要做真实性能比较,还要固定图族、内存布局、编译选项、容量分布和预热,并增加样本数。
八、生产实现:钉版本源码里实际看到什么
这里不写“某某库通常如何”,只写在钉版本源码里看到的事实。
NetworkX 3.3
networkx/algorithms/flow/maxflow.py 第 9 到
14 行导入 preflow_push 并设置:
from .preflowpush import preflow_push

default_flow_func = preflow_push
同文件 maximum_flow(..., flow_func=None)
的文档说明:若 flow_func 为
None,使用默认最大流函数
preflow_push,但“默认函数可能随版本改变,不应依赖”。preflowpush.py
中 preflow_push 的默认参数含
global_relabel_freq=1,并在返回残量网络时设置
R.graph["algorithm"] = "preflow_push"。
OR-Tools v9.10
ortools/graph/max_flow.h
文件开头写明这是最大流问题的 push-relabel 实现,并引用
Goldberg 与 Tarjan。GenericMaxFlow 维护
node_excess_、node_potential_、residual_arc_capacity_
和活跃点容器。max_flow.cc
中构造函数默认值为:
use_global_update_(true),
use_two_phase_algorithm_(true),
process_node_by_height_(true),
check_input_(true),
check_result_(true)
头文件注释还说明 active_nodes_ 是普通栈;当
process_node_by_height_ 为真时,使用
PriorityQueueWithRestrictedPush
按高度处理活跃点。
Boost Graph Library 1.86
include/boost/graph/push_relabel_max_flow.hpp
的注释写明:实现基于 Cherkassky 与 Goldberg 的 push-relabel
方法以及 h_prf.c / hi_pr.c,采用
highest-label 版本,并带 global relabeling 与 gap relabeling
启发式。公开函数 push_relabel_max_flow 先求
maximum_preflow(),再
convert_preflow_to_flow(),最后断言
is_flow() 与 is_optimal()。
同版本
include/boost/graph/boykov_kolmogorov_max_flow.hpp
暴露 boykov_kolmogorov_max_flow
多个重载;其中带 ColorMap 的重载注释写明可用
color map 获取最小割信息。本文不把它说成 Boost
的默认最大流算法,只能说 BGL 同时提供了这些最大流接口。
九、工程选型与边界
几个实践结论可以从模型、源码和实验一起得到:
- 先要证书,再谈速度。 最大流实现应能在结束时给出残量可达集,从而导出最小割;二分匹配实现应能检查每个顶点匹配度不超过 \(1\)。
- 整数容量最省心。 Ford-Fulkerson 的终止性、二分匹配归约的整数最优解、许多库的容量类型,都偏向整数。若输入来自浮点概率,最好先明确缩放、舍入和误差边界。
- Dinic 适合自写与结构化图。 当前弧加分层图代码短,二分匹配、单位容量、分层约束强的网络通常表现稳定;但它不是本文核对到的 NetworkX / OR-Tools 默认路线。
- Push-relabel 是通用库常见选择。
NetworkX 3.3 默认 preflow-push,OR-Tools v9.10
SimpleMaxFlow底层是 push-relabel,Boost 1.86 提供 highest-label push-relabel。实际性能依赖 global relabel、gap、活跃点顺序和图存储。 - 理论前沿与工程落地分开写。 FOCS 2022 的近线性时间结果是组合优化的重要里程碑,但常见库仍采用更传统、易实现、常数可控的算法。把二者混成“生产已经近线性”是不准确的。
本文刻意不展开最小费用流、一般图匹配和 Boykov-Kolmogorov 在视觉能量最小化中的专门结构。这些主题都有自己的不变量和工程坑,放在最大流入门文里只会稀释主线。
十、参考资料
核心论文
- L. R. Ford, D. R. Fulkerson, “Maximal Flow Through a
Network”, Canadian Journal of Mathematics,
8:399-404, 1956, DOI:
10.4153/CJM-1956-045-5。 - E. A. Dinic, “Algorithm for Solution of a Problem of Maximum Flow in a Network with Power Estimation”, Soviet Mathematics Doklady, 11:1277-1280, 1970。
- Jack Edmonds, Richard M. Karp, “Theoretical Improvements
in Algorithmic Efficiency for Network Flow Problems”,
Journal of the ACM, 19(2):248-264, 1972, DOI:
10.1145/321694.321699。 - John E. Hopcroft, Richard M. Karp, “An \(n^{5/2}\) Algorithm for Maximum
Matchings in Bipartite Graphs”, SIAM Journal on
Computing, 2(4):225-231, 1973, DOI:
10.1137/0202019。 - Andrew V. Goldberg, Robert E. Tarjan, “A new approach to
the maximum-flow problem”, Journal of the ACM,
35(4):921-940, 1988, DOI:
10.1145/48014.61051。 - Uri Zwick, “The smallest networks on which the
Ford-Fulkerson maximum flow procedure may fail to
terminate”, Theoretical Computer Science,
148(1):165-170, 1995, DOI:
10.1016/0304-3975(95)00022-O。 - Boris V. Cherkassky, Andrew V. Goldberg, “On
Implementing the Push—Relabel Method for the Maximum Flow
Problem”, Algorithmica, 19(4):390-410, 1997, DOI:
10.1007/PL00009180。 - Li Chen, Rasmus Kyng, Yang P. Liu, Richard Peng, Maximilian Probst Gutenberg, Sushant Sachdeva, “Maximum Flow and Minimum-Cost Flow in Almost-Linear Time”, FOCS 2022 / arXiv:2203.00671v2。arXiv 为预印本;FOCS 2022 awards 页面列其为 Best Paper。
书籍与综述
- Ravindra K. Ahuja, Thomas L. Magnanti, James B. Orlin, Network Flows: Theory, Algorithms, and Applications, Prentice Hall, 1993。
- Bernhard Korte, Jens Vygen, Combinatorial Optimization: Theory and Algorithms, 6th edition, Springer, 2018。
源码
- NetworkX
3.3:
networkx/algorithms/flow/maxflow.py、networkx/algorithms/flow/preflowpush.py。 - OR-Tools
v9.10:
ortools/graph/max_flow.h、ortools/graph/max_flow.cc。 - Boost Graph Library
1.86:
include/boost/graph/push_relabel_max_flow.hpp、include/boost/graph/boykov_kolmogorov_max_flow.hpp。
本文复现
post/algorithms/47-network-flow/reproduce/network_flow_lab.cpp:Edmonds-Karp、Dinic、FIFO push-relabel + gap、Hopcroft-Karp,对拍与计数。post/algorithms/47-network-flow/reproduce/draw_flow_figures.py:按程序中的小网络与bad.csv重新生成 SVG。post/algorithms/47-network-flow/reproduce/metrics.csv、bad.csv、trace.txt:正文表格和图的原始数据。
下一篇: 拓扑排序:依赖解析的顺序与环
相关阅读: - 最小生成树:割性质、Kruskal/Prim/Borůvka 与线性时间开放问题 - 图着色与寄存器分配:从 DSatur 到 Chaitin-Briggs - 竞争分析与在线算法
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。
基数排序:绕开比较下界的代价,从 LSD、American flag sort 到 ska_sort
比较下界只约束比较模型,基数排序把代价转移到键长和内存访问上。本文推导代价模型,用缓存模拟与绑核实测解释位宽为何停在 8 到 11 位,并对照 ska_sort、ClickHouse、DuckDB 与 IPS²Ra 说明它何时赢、何时输。