读完 61 篇正文却从未闭卷算过一道矩阵分解、一次 Softmax 雅可比或一轮 Online Softmax 分块递推,很难判断哪些原理真正内化、哪些只是“看懂了别人写好的推导”。这套课程结业测试把本系列全部内容浓缩为三套分级限时考卷(总分 \(320\) 分):第一套 Quiz 1 检验 Gilbert Strang 线性代数与单层/多头注意力内核;第二套 Midterm 检验原论文设计动机、优化配方与现代对齐/缩放法则;第三套 Final Exam 检验长上下文位置编码、FlashAttention、MoE/MLA、投机解码、电路可解释性、\(TC^0\) 复杂度边界与状态空间/线性注意力。
学习目标(学完你能独立回答)
- 不查笔记,在限时内手算出给定小规模矩阵的四子空间分裂、正交投影、反向传播秩-1 外积、Softmax Jacobian 零空间与 3-token 因果缩放点积注意力输出。
- 独立完成 Sinusoidal \(SO(2)\) 旋转证明、LayerNorm 解析梯度、SwiGLU \(\frac{8}{3}d\) 对等账、LoRA 首步不对称梯度、DPO 配分函数相消与 Chinchilla 拉格朗日最优 \((N^*, D^*)\) 闭式推导。
- 严格推导与手算 RoPE 频率绕圈边界、FlashAttention 两块 Online Softmax、DeepSeek MLA 矩阵吸收压缩比、无损投机采样无偏性、Elhage OV 特征方向以及 Mamba 4 步 Blelloch 并行扫描。
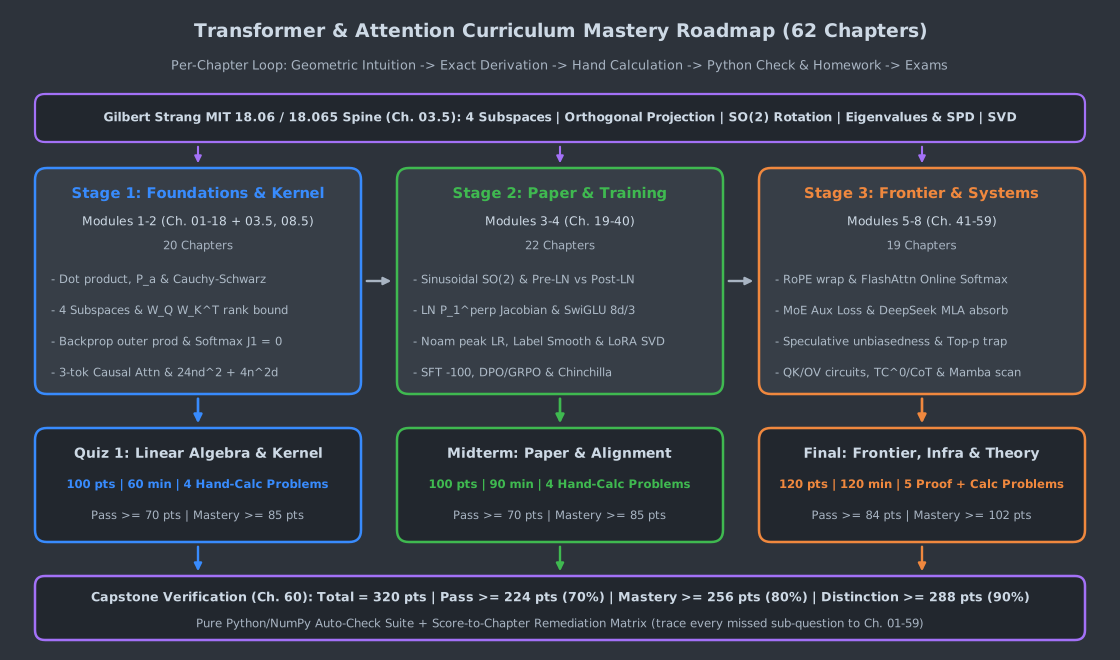
一、考试说明、作答规范与评分标准
每套试卷都按前 \(90\%\) 闭卷纸笔推导 + 后 \(10\%\) 运行核验设计,建议准备空白 A4 草稿纸与计时器严格模拟:
| 考卷 | 覆盖范围 | 题数与总分 | 建议用时 | 及格线(\(70\%\)) | 优秀线(\(85\%\)) |
|---|---|---|---|---|---|
| Quiz 1 | 第 01–18 篇 + 03.5、08.5 | \(4\) 大题,\(100\) 分 | \(60\) 分钟 | \(70\) 分 | \(85\) 分 |
| Midterm Exam | 第 19–40 篇 | \(4\) 大题,\(100\) 分 | \(90\) 分钟 | \(70\) 分 | \(85\) 分 |
| Final Exam | 第 41–59 篇 | \(5\) 大题,\(120\) 分 | \(120\) 分钟 | \(84\) 分 | \(102\) 分 |
| 全课程总评 | 全系列第 01–59 篇 | \(13\) 大题,\(320\) 分 | \(270\) 分钟(分三次) | \(224\) 分 | \(272\) 分(卓越 \(\ge 288\) 分) |
作答约定与注意事项: -
作答环境:先关闭所有章节页面与 Python
终端,独立在草稿纸上列出完整步骤后再展开
<details>
逐分自评;涉及指数、对数数值计算(如 \(e^1 \approx 2.718282\)、\(e^2 \approx 7.389056\)、\(\ln 2 \approx 0.693147\)、\(\ln 10 \approx
2.302585\))可使用基础科学计算器,最终运行第五节的纯
Python / NumPy 脚本交叉校验。 -
张量约定:除非题目另有声明,向量 \(\mathbf{x} \in \mathbb{R}^d\)
默视为列向量;Transformer 批量前向线性层常采用行向量右乘
\(\mathbf{y}^\top =
\mathbf{x}^\top
W\),两种约定下的转置关系已在相关题目中写明。 -
考后回溯:每道题末尾都标出了对应补漏章节链接,凡得分低于该题满分
\(70\%\)
的模块,建议先重做对应章节的「跟着纸笔算一遍」与课后作业,再重测同类型题。
二、Quiz 1:线性代数几何与注意力内核(100 分,建议 60 分钟)
第 1 题(25 分):Gilbert Strang 四个基本子空间与单头 \(W_Q W_K^\top\) 秩瓶颈
- (a)(8 分) 设某模型隐藏维度 \(d_{\text{model}} = 512\),单头注意力投影维度 \(d_k = 64\),权重矩阵 \(W_Q, W_K \in \mathbb{R}^{512\times 64}\)。定义单头双线性打分矩阵 \(M = W_Q W_K^\top \in \mathbb{R}^{512\times 512}\)。利用矩阵乘法秩不等式与 Strang 维度定理,求 \(\operatorname{rank}(M)\) 的上界、行空间 \(C(M^\top)\) 的最大维度及零空间 \(N(M)\) 的最小维度;据此从几何上解释为什么即使训练数据无限大,单个注意力头也无法消除零空间盲区,必须采用多头注意力(Multi-Head Attention)。
- (b)(10 分) 考察极简降维投影矩阵 \(A = \begin{pmatrix} 1 & 1 & 2 \\ 0 & 1 & 1 \end{pmatrix}\)。求 \(A\) 的秩 \(r\),写出四个基本子空间 \(C(A^\top), N(A), C(A), N(A^\top)\) 各自的维度与一组基;并将输入特征 \(\mathbf{x} = (4, 2, 0)^\top\) 精确正交分解为 \(\mathbf{x} = \mathbf{x}_r + \mathbf{x}_n\)(其中 \(\mathbf{x}_r \in C(A^\top),\ \mathbf{x}_n \in N(A)\)),验证 \(\mathbf{x}_r^\top \mathbf{x}_n = 0\) 与 \(A\mathbf{x} = A\mathbf{x}_r\)。
- (c)(7 分) 在具有 \(H = 8\) 个头(\(d_k = d_v = 64\),\(H d_k = d_{\text{model}} = 512\))的多头注意力中,写出各头输出拼接 \([O_1, \dots, O_8] W_O\) 与按头独立经过切片 \(W_O^{(h)} \in \mathbb{R}^{64\times 512}\) 后求和的精确矩阵分块等价式,并说明总参数量为何仍是 \(4 d_{\text{model}}^2\) 而非 \(4 H d_{\text{model}}^2\)。
参考答案与评分细则(先独立推导再展开)
- (a) 秩上限与零空间盲区(8 分):
- 由秩不等式 \(\operatorname{rank}(W_Q W_K^\top) \le \min(\operatorname{rank}(W_Q), \operatorname{rank}(W_K)) \le d_k = 64\)(\(3\) 分)。
- 因此行空间 \(C(M^\top)\) 维度至多为 \(64\);由 Strang 维度定理 \(\dim C(M^\top) + \dim N(M) = 512\),零空间 \(N(M)\) 维度至少为 \(512 - 64 = 448\)(\(3\) 分)。
- 该上界由矩阵张量形状决定,与优化器或样本数无关;落入 \(N(M)\) 的特征方向对单头打分完全隐形,必须靠多个头占据不同的 \(64\) 维子空间并通过 \(W_O\) 拼回残差流(\(2\) 分)。
- (b) 四子空间与正交分裂手算(10 分):
- \(A\) 的两行线性无关,故秩 \(r = 2\)(\(1\) 分)。维度与基:\(C(A^\top)\) 在 \(\mathbb{R}^3\) 中占 \(2\) 维,基为 \((1,1,2)^\top, (0,1,1)^\top\);\(C(A) = \mathbb{R}^2\) 占 \(2\) 维,基为标准基 \((1,0)^\top, (0,1)^\top\);\(N(A^\top) = \{\mathbf{0}\}\) 占 \(0\) 维(\(2\) 分)。解 \(A\mathbf{n} = \mathbf{0}\) 得 \(n_2 = -n_3,\ n_1 = -n_2 - 2n_3 = -n_3\),取基 \(\mathbf{n} = (1, 1, -1)^\top\),故 \(\dim N(A) = 1\)(\(2\) 分)。
- 将 \(\mathbf{x} = (4, 2, 0)^\top\) 投影到 \(N(A)\):系数 \(c = \frac{\mathbf{n}^\top \mathbf{x}}{\mathbf{n}^\top \mathbf{n}} = \frac{4 + 2 - 0}{1 + 1 + 1} = 2\),得 \(\mathbf{x}_n = (2, 2, -2)^\top\),\(\mathbf{x}_r = \mathbf{x} - \mathbf{x}_n = (2, 0, 2)^\top = 2(1,1,2)^\top - 2(0,1,1)^\top \in C(A^\top)\)(\(3\) 分)。
- 核验:\(\mathbf{x}_r^\top \mathbf{x}_n = 4 + 0 - 4 = 0\),且 \(A\mathbf{x} = (6, 2)^\top = A\mathbf{x}_r\)(\(2\) 分)。
- (c) 多头分块等价式与参数账(7 分):
- 将 \(W_O \in \mathbb{R}^{512\times 512}\) 按行切为 \(8\) 块 \(W_O^\top = [(W_O^{(1)})^\top, \dots, (W_O^{(8)})^\top]\),由分块矩阵乘法得 \([O_1, \dots, O_8] W_O = \sum_{h=1}^8 O_h W_O^{(h)}\)(\(4\) 分)。
- 所有 \(8\) 个头的 \(W_Q^{(h)}, W_K^{(h)}, W_V^{(h)}\) 横向拼接恰好构成三个 \(512\times 512\) 矩阵,加上 \(W_O\) 共 \(4 d_{\text{model}}^2\) 参数;每个头只算 \(1/H\) 宽度,多头参数与算力与单全维头等价(\(3\) 分)。
对应补漏章节:03|矩阵乘法的四种视角、03.5|Gilbert Strang 线性代数核心地图、16|Multi-Head Attention。
第 2 题(25 分):Strang 正交投影 \(P_{\mathbf{a}}\)、Cauchy-Schwarz 与点积缩放
- (a)(8 分) 设锚点键向量 \(\mathbf{a} = (1, 2, 2)^\top\),目标查询向量 \(\mathbf{b} = (6, 3, 6)^\top\)。用 Strang 一维正交投影公式求出投影矩阵 \(P_{\mathbf{a}} = \frac{\mathbf{a}\mathbf{a}^\top}{\mathbf{a}^\top \mathbf{a}}\)(写成分数矩阵)、投影向量 \(\mathbf{p} = P_{\mathbf{a}}\mathbf{b}\) 以及垂直残差 \(\mathbf{e} = \mathbf{b} - \mathbf{p}\);核验 \(\mathbf{p}^\top\mathbf{e} = 0\) 与勾股定理 \(\|\mathbf{b}\|_2^2 = \|\mathbf{p}\|_2^2 + \|\mathbf{e}\|_2^2\)。
- (b)(7 分) 由正交误差向量长度平方非负(\(\|\mathbf{e}\|_2^2 = \left\|\mathbf{b} - \frac{\mathbf{a}^\top\mathbf{b}}{\mathbf{a}^\top\mathbf{a}}\mathbf{a}\right\|_2^2 \ge 0\)),严格推导 Cauchy-Schwarz 不等式 \(|\mathbf{a}^\top\mathbf{b}| \le \|\mathbf{a}\|_2\|\mathbf{b}\|_2\)(假设 \(\mathbf{a} \neq \mathbf{0}\));并求 (a) 中 \(\mathbf{a}\) 与 \(\mathbf{b}\) 夹角的精确余弦值 \(\cos\theta\)。
- (c)(10 分) 设 \(\mathbf{q}, \mathbf{k} \in \mathbb{R}^{d_k}\) 各分量彼此独立,满足 \(\mathbb{E}[q_i]=\mathbb{E}[k_i]=0\) 与 \(\operatorname{Var}(q_i)=\operatorname{Var}(k_i)=1\)。从双求和展开严格证明 \(\operatorname{Var}(\mathbf{q}\cdot\mathbf{k}) = d_k\);当 \(d_k = 64\) 且某行未缩放点积为 \(\mathbf{s} = [0, 8, 0]\) 时,分别在无缩放(除以 \(1\))、标准缩放(除以 \(\sqrt{d_k}=8\))和过度缩放(除以 \(d_k=64\))下计算第 \(2\) 个位置的 Softmax 概率 \(p_2\) 及其雅可比对角元 \(p_2(1-p_2)\)(保留 \(4\) 位小数),指出 \(1/d_k\) 为何同样不可取。
参考答案与评分细则(先独立推导再展开)
- (a) 一维投影手算与验算(8 分):
- \(\mathbf{a}^\top \mathbf{a} = 1 + 4 + 4 = 9\),\(\mathbf{a}^\top \mathbf{b} = 6 + 6 + 12 = 24\)(\(2\) 分)。
- \(P_{\mathbf{a}} = \frac{1}{9}\begin{pmatrix} 1 & 2 & 2 \\ 2 & 4 & 4 \\ 2 & 4 & 4 \end{pmatrix}\)(\(2\) 分)。
- \(\mathbf{p} = \frac{24}{9}\mathbf{a} = \frac{8}{3}(1,2,2)^\top = \left(\frac{8}{3}, \frac{16}{3}, \frac{16}{3}\right)^\top\),\(\mathbf{e} = \mathbf{b} - \mathbf{p} = \left(\frac{10}{3}, -\frac{7}{3}, \frac{2}{3}\right)^\top\)(\(2\) 分)。
- \(\mathbf{p}^\top \mathbf{e} = \frac{80 - 112 + 32}{9} = 0\);\(\|\mathbf{p}\|_2^2 = 64,\ \|\mathbf{e}\|_2^2 = \frac{100+49+4}{9} = 17,\ \|\mathbf{b}\|_2^2 = 36+9+36 = 81 = 64 + 17\)(\(2\) 分)。
- (b) Cauchy-Schwarz 证明与余弦相似度(7
分):
- 展开 \(\|\mathbf{e}\|_2^2 = \|\mathbf{b}\|_2^2 - 2\frac{(\mathbf{a}^\top\mathbf{b})^2}{\|\mathbf{a}\|_2^2} + \frac{(\mathbf{a}^\top\mathbf{b})^2}{\|\mathbf{a}\|_2^4}\|\mathbf{a}\|_2^2 = \|\mathbf{b}\|_2^2 - \frac{(\mathbf{a}^\top\mathbf{b})^2}{\|\mathbf{a}\|_2^2} \ge 0\)(\(3\) 分)。
- 移项乘 \(\|\mathbf{a}\|_2^2\) 得 \((\mathbf{a}^\top\mathbf{b})^2 \le \|\mathbf{a}\|_2^2\|\mathbf{b}\|_2^2\),开方即得 \(|\mathbf{a}^\top\mathbf{b}| \le \|\mathbf{a}\|_2\|\mathbf{b}\|_2\)(\(2\) 分)。
- \(\|\mathbf{a}\|_2 = 3,\ \|\mathbf{b}\|_2 = \sqrt{81} = 9\),故 \(\cos\theta = \frac{24}{3\times 9} = \frac{8}{9} \approx 0.8889\)(\(2\) 分)。
- (c) 点积方差证明与缩放数值对比(10
分):
- \(\mathbb{E}[q_i k_i] = 0\)(独立零均值)。\(\operatorname{Var}(\sum_{i=1}^{d_k} q_i k_i) = \sum_{i=1}^{d_k}\operatorname{Var}(q_i k_i) + \sum_{i\neq j}\operatorname{Cov}(q_i k_i, q_j k_j)\)。因各维度独立,交叉项协方差全为 \(0\);对角项 \(\operatorname{Var}(q_i k_i) = \mathbb{E}[q_i^2]\mathbb{E}[k_i^2] - 0 = 1\cdot 1 = 1\),加和得 \(d_k\)(\(4\) 分)。
- 数值对比(\(4\) 分):
- 无缩放 \([0, 8, 0]\):\(p_2 = \frac{e^8}{2 + e^8} \approx 0.9993\),\(p_2(1-p_2) \approx 0.0007\)(Softmax 严重饱和,梯度归零);
- 除以 \(\sqrt{d_k}=8\) 得 \([0, 1, 0]\):\(p_2 = \frac{e^1}{2+e^1} \approx 0.5761\),\(p_2(1-p_2) \approx 0.2442\)(接近峰值 \(0.25\));
- 除以 \(d_k=64\) 得 \([0, 0.125, 0]\):\(p_2 = \frac{e^{0.125}}{2+e^{0.125}} \approx 0.3617\),\(p_2(1-p_2) \approx 0.2309\)。
- 尽管除以 \(d_k\) 时 Softmax 雅可比对角元本身未饱和,但分布趋向均匀 \(1/N\),且链式法则前端再乘缩放导数 \(1/d_k = 1/64\),仍导致回传给 Query 的总梯度被额外压低 \(d_k\) 倍(\(2\) 分)。
对应补漏章节:02|向量、内积与正交投影、15|Scaled Dot-Product。
第 3 题(25 分):反向传播秩-1 外积规则与 Softmax Jacobian 零空间
- (a)(9 分) 采用行向量右乘约定:\(\mathbf{z}_1^\top = \mathbf{x}^\top W_1\),\(\mathbf{h}^\top = \operatorname{ReLU}(\mathbf{z}_1^\top)\),\(\mathbf{y}^\top = \mathbf{h}^\top W_2\)。设输入 \(\mathbf{x} = (2, -1)^\top\),权重 \(W_1 = \begin{pmatrix} 2 & -1 \\ 1 & 1 \end{pmatrix}\),\(W_2 = \begin{pmatrix} 1 & 2 \\ -1 & 3 \end{pmatrix}\),上游损失梯度 \(\mathbf{g}_y = (1, -2)^\top\)。按反向传播秩-1 外积规则 \(\nabla_W L = \mathbf{x}_{\text{in}}\mathbf{g}_{\text{out}}^\top\) 逐步计算:\(\mathbf{z}_1, \mathbf{h}, \mathbf{y}\);权重梯度 \(\nabla_{W_2} L\)、\(\nabla_{W_1} L\) 与输入梯度 \(\mathbf{g}_x\),并验证两个权重梯度的矩阵秩均不超过 \(1\)。
- (b)(10 分) 设 logits 向量为 \(\mathbf{z} = (0, \ln 2, \ln 3)^\top\)。精确计算概率分布 \(\mathbf{p} = \operatorname{softmax}(\mathbf{z})\)(用精确分数)与 \(3\times 3\) Softmax 雅可比矩阵 \(J = \operatorname{diag}(\mathbf{p}) - \mathbf{p}\mathbf{p}^\top\)(写成分数矩阵);直接通过矩阵乘法计算 \(J\mathbf{1}\) 证明 \(\mathbf{1} \in N(J)\),并结合 Strang 四个基本子空间说明 \(\mathbf{1} \in N(J)\) 对任意上游梯度回传至 logits 造成的约束。
- (c)(6 分) 若 (b) 中交叉熵损失的真实标签为第 \(3\) 类 \(\mathbf{e}_3 = (0, 0, 1)^\top\)(因此 \(\mathbf{g}_p = \nabla_{\mathbf{p}} L = -\frac{1}{p_3}\mathbf{e}_3\)),直接用 (b) 算出的 \(J\) 矩阵计算 \(\mathbf{g}_z = J^\top \mathbf{g}_p\),验证其精确等于 \(\mathbf{p} - \mathbf{e}_3\);再证明对任意 \(\mathbf{v}\in\mathbb{R}^3\) 有 \(\mathbf{v}^\top J\mathbf{v} = \operatorname{Var}_{i\sim\mathbf{p}}(v_i) \ge 0\)。
参考答案与评分细则(先独立推导再展开)
- (a) 前向与秩-1 外积反向传播(9 分):
- 前向(\(2\) 分):\(\mathbf{z}_1^\top = [2, -1]\begin{pmatrix} 2 & -1 \\ 1 & 1 \end{pmatrix} = [3, -3]\),\(\mathbf{h}^\top = \operatorname{ReLU}([3, -3]) = [3, 0]\),\(\mathbf{y}^\top = [3, 0]\begin{pmatrix} 1 & 2 \\ -1 & 3 \end{pmatrix} = [3, 6]\)。
- \(\nabla_{W_2} L = \mathbf{h}\mathbf{g}_y^\top = \begin{pmatrix} 3 \\ 0 \end{pmatrix}[1, -2] = \begin{pmatrix} 3 & -6 \\ 0 & 0 \end{pmatrix}\),秩为 \(1\)(\(2\) 分)。
- \(\mathbf{g}_h = W_2 \mathbf{g}_y = \begin{pmatrix} 1 & 2 \\ -1 & 3 \end{pmatrix}\begin{pmatrix} 1 \\ -2 \end{pmatrix} = \begin{pmatrix} -3 \\ -7 \end{pmatrix}\);穿过 \(\operatorname{ReLU}'([3, -3]) = [1, 0]\) 得 \(\mathbf{g}_{z_1} = (-3, 0)^\top\)(\(2\) 分)。
- \(\nabla_{W_1} L = \mathbf{x}\mathbf{g}_{z_1}^\top = \begin{pmatrix} 2 \\ -1 \end{pmatrix}[-3, 0] = \begin{pmatrix} -6 & 0 \\ 3 & 0 \end{pmatrix}\)(秩为 \(1\)),\(\mathbf{g}_x = W_1 \mathbf{g}_{z_1} = \begin{pmatrix} -6 \\ -3 \end{pmatrix}\)(\(3\) 分)。
- (b) Softmax 精确 Jacobian 与零空间(10
分):
- \(e^{\mathbf{z}} = (1, 2, 3)\),总和 \(6\),故 \(\mathbf{p} = \left(\frac{1}{6},\ \frac{1}{3},\ \frac{1}{2}\right)^\top\)(\(2\) 分)。
- \(J = \operatorname{diag}\left(\frac{1}{6}, \frac{1}{3}, \frac{1}{2}\right) - \frac{1}{36}\begin{pmatrix} 1 & 2 & 3 \\ 2 & 4 & 6 \\ 3 & 6 & 9 \end{pmatrix} = \frac{1}{36}\begin{pmatrix} 5 & -2 & -3 \\ -2 & 8 & -6 \\ -3 & -6 & 9 \end{pmatrix}\)(\(4\) 分)。
- \(J\mathbf{1} = \frac{1}{36}(5-2-3,\ -2+8-6,\ -3-6+9)^\top = (0, 0, 0)^\top\)。由 Strang 正交补定理 \(C(J^\top) \perp N(J)\),任意回传梯度 \(\mathbf{g}_z = J^\top \mathbf{g}_p\) 必满足 \(\mathbf{1}^\top \mathbf{g}_z = \sum_i g_{z,i} = 0\)(总和为零的概率再分配,对应 Softmax 的平移不变性)(\(4\) 分)。
- (c) 交叉熵合并梯度与半正定证明(6
分):
- \(\mathbf{g}_p = (0, 0, -2)^\top\),\(\mathbf{g}_z = J^\top \mathbf{g}_p = \frac{1}{36}\begin{pmatrix} (-3)(-2) \\ (-6)(-2) \\ 9(-2) \end{pmatrix} = \begin{pmatrix} 1/6 \\ 1/3 \\ -1/2 \end{pmatrix} = \mathbf{p} - \mathbf{e}_3\)(\(3\) 分)。
- \(\mathbf{v}^\top J\mathbf{v} = \sum_i p_i v_i^2 - (\sum_i p_i v_i)^2 = \mathbb{E}_{i\sim\mathbf{p}}[v_i^2] - (\mathbb{E}_{i\sim\mathbf{p}}[v_i])^2 = \operatorname{Var}_{i\sim\mathbf{p}}(v_i) \ge 0\)(\(3\) 分)。
对应补漏章节:06|梯度下降与反向传播、07|Softmax 与概率分布、08.5|神经网络基础。
第 4 题(25 分):3-Token 因果缩放点积注意力手算与 FLOPs 交叉点
- (a)(13 分) 设序列长度 \(n=3\),头维度 \(d_k = d_v = 4\)(缩放因子 \(\sqrt{d_k} = 2\)),给定查询、键、值矩阵: \[ Q = \begin{pmatrix} 1 & 1 & 0 & 0 \\ 1 & 1 & 1 & 1 \\ 2 & 0 & 2 & 0 \end{pmatrix}, \quad K = \begin{pmatrix} 1 & 1 & 0 & 0 \\ 0 & 2 & 0 & 0 \\ 1 & 0 & 1 & 0 \end{pmatrix}, \quad V = \begin{pmatrix} 1 & 0 & 2 & 0 \\ 0 & 2 & 0 & 2 \\ 2 & 2 & 0 & 0 \end{pmatrix} \] 逐行计算因果缩放点积注意力 \(\mathrm{CausalAttn}(Q, K, V) = \operatorname{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}} + M_{\text{causal}}\right)V\):写出未掩码打分矩阵 \(S = QK^\top/2\)、掩码后逐行注意力权重矩阵 \(A\) 及最终输出矩阵 \(O\)(前两行写精确值,第三行保留 \(4\) 位小数)。
- (b)(12 分) 在标准 Decoder-only 单层 Transformer(宽度 \(d\),包含 \(W_Q, W_K, W_V, W_O \in \mathbb{R}^{d\times d}\) 以及经典 \(4d\) FFN 或 \(\frac{8}{3}d\) SwiGLU FFN,忽略归一化与 Softmax 逐元素项)中,严格推导单层前向总浮点运算量 \(\mathrm{FLOPs}_{\text{fwd}}(n, d) = 24 n d^2 + 4 n^2 d\)(写清每一项矩阵乘维度及乘加因子 \(2\));计算注意力二次项追平所有线性层 GEMM 的黄金交叉长度 \(n^* = 6d\);设 \(d = 4096\),分别求出 \(n = 4096\) 与 \(n = 65536\) 时单层前向总 FLOPs(以 TFLOPs 计)以及注意力交互项占比。
参考答案与评分细则(先独立推导再展开)
- (a) 3-Token 因果自注意力手算(13 分):
- 打分矩阵 \(S = \frac{1}{2}QK^\top = \begin{pmatrix} 1 & 1 & 0.5 \\ 1 & 1 & 1 \\ 1 & 0 & 2 \end{pmatrix}\)(\(3\) 分)。
- 施加下三角因果掩码 \(M_{\text{causal}}\)(\(j > i\) 置 \(-\infty\))并逐行
Softmax(\(5\) 分):
- 第 \(1\) 行 \([1, -\infty, -\infty] \implies [1.0,\ 0,\ 0]\);
- 第 \(2\) 行 \([1, 1, -\infty] \implies [0.5,\ 0.5,\ 0]\);
- 第 \(3\) 行 \([1, 0, 2]\):分母 \(Z_3 = e^1 + 1 + e^2 \approx 2.718282 + 1 + 7.389056 = 11.107338\),权重为 \([0.244728,\ 0.090031,\ 0.665241]\)(取 \(4\) 位小数为 \([0.2447,\ 0.0900,\ 0.6652]\))。
- 矩阵乘 \(O =
AV\)(\(5\) 分):
- \(\mathbf{o}_1 = \mathbf{v}_1 = [1.0,\ 0.0,\ 2.0,\ 0.0]\);
- \(\mathbf{o}_2 = 0.5\mathbf{v}_1 + 0.5\mathbf{v}_2 = [0.5,\ 1.0,\ 1.0,\ 1.0]\);
- \(\mathbf{o}_3 = 0.244728[1,0,2,0] + 0.090031[0,2,0,2] + 0.665241[2,2,0,0] \approx [1.5752,\ 1.5105,\ 0.4895,\ 0.1801]\)。
- (b) 单层 FLOPs 推导与交叉点(12 分):
- 一次 \((n\times
a)\cdot(a\times b)\) 矩阵乘需 \(2nab\) FLOPs(\(a\) 次乘加各占 \(2\) FLOPs):
- \(Q, K, V, O\) 四个 \(d\times d\) 投影:\(4 \times 2 n d^2 = 8 n d^2\);
- FFN 两层 \(4d\) MLP(\(d\to 4d\to d\)):\(2 \times (2 n d \cdot 4d) = 16 n d^2\)(若为 \(\frac{8}{3}d\) SwiGLU,三矩阵共 \(3 \times 2 n d \cdot \frac{8}{3}d = 16 n d^2\));
- 注意力交互 \(QK^\top\)(\((n\times d_k)(d_k\times n)\) 多头汇总为 \(2 n^2 d\))与 \(AV\)(\(2 n^2 d\)),合计 \(4 n^2 d\)。总计 \(24 n d^2 + 4 n^2 d\)(\(6\) 分)。
- 令 \(4 n^2 d = 24 n d^2 \implies n^* = 6d\);当 \(d = 4096\) 时,\(n^* = 24{,}576\)(\(2\) 分)。
- 代入 \(d =
4096\)(\(2\)
分/项,共 \(4\) 分):
- \(n = 4096\):\(\text{GEMM} = 24 \times 4096^3 \approx 1.6493\text{ TFLOPs}\),\(\text{Attn} = 4 \times 4096^3 \approx 0.2749\text{ TFLOPs}\),合计 \(1.9241\text{ TFLOPs}\),注意力占比 \(\frac{4}{28} \approx 14.29\%\);
- \(n = 65536 = 16 d\):\(\text{GEMM} = 26.3883\text{ TFLOPs}\),\(\text{Attn} = 70.3687\text{ TFLOPs}\),合计 \(96.7570\text{ TFLOPs}\),注意力占比 \(\frac{4\times 16}{24 + 4\times 16} = \frac{64}{88} \approx 72.73\%\)。
- 一次 \((n\times
a)\cdot(a\times b)\) 矩阵乘需 \(2nab\) FLOPs(\(a\) 次乘加各占 \(2\) FLOPs):
三、Midterm Exam:原论文剖析与现代大模型训练范式(100 分,建议 90 分钟)
第 1 题(25 分):Sinusoidal \(SO(2)\) 旋转证明、Pre-LN vs Post-LN 与 LayerNorm 投影 Jacobian
- (a)(8 分) 在原版正弦位置编码中,第 \(i\) 组通道定义为 \(\mathbf{p}_i(\text{pos}) = \begin{pmatrix} \sin(\omega_i \cdot \text{pos}) \\ \cos(\omega_i \cdot \text{pos}) \end{pmatrix}\)。证明对任意固定位移 \(\Delta k\),存在不依赖绝对位置 \(\text{pos}\) 的矩阵 \(R(\omega_i\Delta k)\) 使得 \(\mathbf{p}_i(\text{pos}+\Delta k) = R(\omega_i\Delta k)\mathbf{p}_i(\text{pos})\);验证 \(R^\top R = I_2\) 且 \(\det R = 1\)(属于 \(SO(2)\));据此解释为什么原版加性位置编码把位置信号混入词嵌入后,仍可能被 \(W_Q^\top W_K\) 的非对易性破坏,从而催生了 RoPE。
- (b)(7 分) 写出 Post-LN 与 Pre-LN 两种残差块的递归公式及其层间反向传播雅可比乘积链;从 Gilbert Strang 特征值偏移与 Xiong 等人(ICML 2020)谱范数边界说明为什么 Post-LN 极度依赖 Warmup,而 Pre-LN 能直接让梯度穿过恒等通路,同时指出 Pre-LN 带来的主干方差增长代价及缩放对策。
- (c)(10 分) 给定 \(d = 4\) 维隐状态向量 \(\mathbf{x} = (0, 6, 8,
14)^\top\),仿射参数 \(\boldsymbol{\gamma} = \mathbf{1},\
\boldsymbol{\beta} = \mathbf{0},\ \epsilon =
0\),上游梯度 \(\mathbf{g}
= (3, -1, 2, 4)^\top\)。
- 计算 LayerNorm 的正交投影中心化向量 \(\tilde{\mathbf{x}} = P_{\mathbf{1}^\perp}\mathbf{x}\)、标准差 \(\sigma\) 与归一化输出 \(\hat{\mathbf{x}}\);
- 利用解析反向传播公式 \(\nabla_{\mathbf{x}}\mathcal{L} = \frac{1}{\sigma}\left(P_{\mathbf{1}^\perp}\mathbf{g} - \frac{1}{d}(\hat{\mathbf{x}}^\top \mathbf{g})\hat{\mathbf{x}}\right)\) 精确算出 \(\nabla_{\mathbf{x}}\mathcal{L}\),并检验其同时垂直于 \(\mathbf{1}\) 与 \(\hat{\mathbf{x}}\)。
参考答案与评分细则(先独立推导再展开)
- (a) 正弦编码 \(SO(2)\) 证明与演化动机(8
分):
- 利用三角和角公式展开 \(\sin(\omega_i(\text{pos}+\Delta k))\) 与 \(\cos(\omega_i(\text{pos}+\Delta k))\),整理为矩阵乘法:\(R(\omega_i\Delta k) = \begin{pmatrix} \cos(\omega_i\Delta k) & \sin(\omega_i\Delta k) \\ -\sin(\omega_i\Delta k) & \cos(\omega_i\Delta k) \end{pmatrix}\)(注意 \((\sin,\cos)^\top\) 序下右上角为 \(+\sin\))(\(3\) 分)。
- 逐项计算 \(R^\top R = \begin{pmatrix} \cos^2+\sin^2 & \cos\sin-\sin\cos \\ \sin\cos-\cos\sin & \sin^2+\cos^2 \end{pmatrix} = I_2\),且 \(\det R = \cos^2 + \sin^2 = 1\),故 \(R \in SO(2)\)(\(3\) 分)。
- 仅在 \(\text{PE}\) 向量自身间成立正交位移不变;加到词嵌入 \(\mathbf{e} + \mathbf{p}\) 并乘以 \(W_Q, W_K\) 后,一般情况下 \(W_Q^\top W_K\) 与分块旋转矩阵不对易,且词义交叉项引入干扰,使相对位移仅作为“可学下限”而非硬结构保证(\(2\) 分)。
- (b) Post-LN vs Pre-LN 特征值与方差分析(7
分):
- Post-LN:\(\mathbf{h}_{\ell+1} = \operatorname{LN}(\mathbf{h}_\ell + F_\ell(\mathbf{h}_\ell))\),层间雅可比外乘归一化系数 \(J_{\text{LN}}(I + J_{F_\ell})\),由于顶层输出方差大使得 \(1/s\) 与残差信号耦合,底层梯度易随深度衰减而顶层初期方差极大,必须依赖线性 Warmup 缓冲(\(4\) 分)。
- Pre-LN:\(\mathbf{h}_{\ell+1} = \mathbf{h}_\ell + F_\ell(\operatorname{LN}(\mathbf{h}_\ell))\),反向路径包含纯恒等项 \(\prod (I + J_{F_\ell \circ \text{LN}}^\top)\),特征值锚定在 \(1\) 附近使百层可稳训;代价是未受外层归一化约束的主干残差流方差随深度 \(O(L)\) 增长,深层输出贡献易相对变浅(工程常用 \(1/\sqrt{2L}\) 残差初始化或 DeepNorm 缓解)(\(3\) 分)。
- (c) LayerNorm 精确手算(10 分):
- \(\mu = \frac{0+6+8+14}{4} = 7\),\(\tilde{\mathbf{x}} = (-7, -1, 1, 7)^\top\),\(\sigma^2 = \frac{49+1+1+49}{4} = 25 \implies \sigma = 5\),\(\hat{\mathbf{x}} = (-1.4, -0.2, 0.2, 1.4)^\top\)(\(4\) 分)。
- \(\bar{g} = \frac{3 - 1 + 2 + 4}{4} = 2 \implies P_{\mathbf{1}^\perp}\mathbf{g} = (1, -3, 0, 2)^\top\)(\(2\) 分)。
- \(\hat{\mathbf{x}}^\top \mathbf{g} = (-1.4)(3) + (-0.2)(-1) + (0.2)(2) + (1.4)(4) = -4.2 + 0.2 + 0.4 + 5.6 = 2.0\),径向修正 \(\frac{2.0}{4}\hat{\mathbf{x}} = (-0.7, -0.1, 0.1, 0.7)^\top\)(\(2\) 分)。
- \(\nabla_{\mathbf{x}}\mathcal{L} = \frac{1}{5}\big((1,-3,0,2)^\top - (-0.7,-0.1,0.1,0.7)^\top\big) = \frac{1}{5}(1.7, -2.9, -0.1, 1.3)^\top = (0.34, -0.58, -0.02, 0.26)^\top\);核验 \(\mathbf{1}^\top \nabla_{\mathbf{x}}\mathcal{L} = 0\),且 \(\hat{\mathbf{x}}^\top \nabla_{\mathbf{x}}\mathcal{L} = -0.476 + 0.116 - 0.004 + 0.364 = 0\)(\(2\) 分)。
对应补漏章节:21|位置编码、24|残差连接、25|Layer Normalization。
第 2 题(25 分):Geva 秩-1 键值记忆、SwiGLU \(\frac{8}{3}d\) 对等账、Label Smoothing 与 Noam 学习率
- (a)(8 分) 写出无输出偏置的两层 ReLU FFN \(\operatorname{FFN}(\mathbf{x}) = \operatorname{ReLU}(\mathbf{x}^\top W_1 + \mathbf{b}_1^\top)W_2\) 拆解为“键值记忆(Key-Value Memory)”与 Strang 第四乘法视角的秩-1 外积求和表达;取 \(d=2, d_{\text{ff}}=3\),\(\mathbf{x}^\top = [1, 2]\),\(W_1 = \begin{pmatrix} 1 & -1 & 2 \\ 1 & 1 & -1 \end{pmatrix}\),\(\mathbf{b}_1^\top = [0, -2, 1]\),\(W_2 = \begin{pmatrix} 2 & -1 \\ 1 & 3 \\ 0.5 & 0.5 \end{pmatrix}\),手算各个记忆槽的门控系数 \((c_1, c_2, c_3)\) 与最终输出向量。
- (b)(5 分) 现代大模型普遍采用三矩阵门控 \(\operatorname{SwiGLU}(\mathbf{x}) = \big(\operatorname{SiLU}(\mathbf{x}^\top W_{\text{gate}}) \odot (\mathbf{x}^\top W_{\text{up}})\big) W_{\text{down}}\)。推导为什么为与经典 \(4d\) MLP 保持完全一致的参数量(\(8d^2\))和前向 FLOPs(\(16nd^2\)),其中间维度须设定为 \(d_{\text{ff}} = \frac{8}{3}d\);解释为什么 LLaMA-7B(\(d=4096\))在工程上将理论值 \(10922.67\) 向上取整为 \(11008\)。
- (c)(12 分) 原论文训练配方定量核算:
- (6 分)对全词表标签平滑 \(\mathbf{q} \in \Delta^{V-1}\)(\(q_y = 1 - \epsilon + \frac{\epsilon}{V}\),其余 \(q_{i\neq y} = \frac{\epsilon}{V}\)),从 \(\mathcal{L}_{\text{LS}} = H(\mathbf{q}) + D_{\text{KL}}(\mathbf{q}\|\mathbf{p})\) 推导全局最优 logit 间隔 \(\Delta z^* = z_y^* - z_{i\neq y}^* = \ln\!\left(\frac{(1-\epsilon)V + \epsilon}{\epsilon}\right)\);取 \(V=10,\ \epsilon=0.1\) 算出 \(q_y, q_{i\neq y}\) 及 \(\Delta z^*\)(保留 \(4\) 位小数),并简述为何 Label Smoothing 会让测试 BLEU 上升而训练 PPL 略升。
- (6 分)写出 Noam 学习率调度 \(\eta(t) = d_{\text{model}}^{-0.5}\min(t^{-0.5},\ t \cdot t_w^{-1.5})\) 的峰值拐点步数与峰值公式;当 \(t_w = 4000\) 时,分别计算 Transformer Base(\(d_{\text{model}}=512\))在 \(t=1000, 4000, 16000\) 步的学习率,以及 Transformer Big(\(d_{\text{model}}=1024\))在 \(t=4000\) 步的峰值学习率。
参考答案与评分细则(先独立推导再展开)
- (a) Geva 键值记忆手算(8 分):
- 记 \(W_1\) 的第 \(m\) 列为键向量 \(\mathbf{k}_m\)、\(W_2\) 的第 \(m\) 行为值向量 \(\mathbf{v}_m^\top\),则 \(c_m(\mathbf{x}) = \operatorname{ReLU}(\mathbf{x}^\top\mathbf{k}_m + b_{1,m})\),输出为 \(\sum_{m=1}^{d_{\text{ff}}} c_m(\mathbf{x})\mathbf{v}_m^\top\)(\(3\) 分)。
- 预激活 \(\mathbf{x}^\top W_1 + \mathbf{b}_1^\top = [1+2+0,\ -1+2-2,\ 2-2+1] = [3, -1, 1]\),经 ReLU 得 \((c_1, c_2, c_3) = (3, 0, 1)\)(\(3\) 分)。
- 仅槽 \(1\) 与槽 \(3\) 激活:\(\mathbf{y}^\top = 3\cdot[2, -1] + 0 + 1\cdot[0.5, 0.5] = [6.5, -2.5]\)(\(2\) 分)。
- (b) SwiGLU 维度对等与对齐(5 分):
- 三矩阵 \(W_{\text{gate}}, W_{\text{up}} \in \mathbb{R}^{d\times d_{\text{ff}}}\) 与 \(W_{\text{down}} \in \mathbb{R}^{d_{\text{ff}}\times d}\) 总参数为 \(3 d d_{\text{ff}}\),前向 FLOPs 为 \(6 n d d_{\text{ff}}\)。令 \(3 d d_{\text{ff}} = 8 d^2 \implies d_{\text{ff}} = \frac{8}{3}d\),此时算力亦精确等于 \(16nd^2\)(\(3\) 分)。
- GPU Tensor Core 分块矩阵乘要求通道维度为 \(64/128/256\) 的整数倍以避免尾部填充浪费,\(11008 = 43 \times 256\) 是最接近的 \(256\) 倍数(\(2\) 分)。
- (c) Label Smoothing 与 Noam 学习率(12
分):
- KL 非负且仅当 \(\mathbf{p}=\mathbf{q}\) 取零,故最优分布为 \(p_y^* = 1 - \epsilon + \frac{\epsilon}{V},\ p_{i\neq y}^* = \frac{\epsilon}{V}\),由此 \(\Delta z^* = \ln(p_y^* / p_{i\neq y}^*) = \ln\!\left(\frac{(1-\epsilon)V + \epsilon}{\epsilon}\right)\)(\(3\) 分)。代入 \(V=10,\ \epsilon=0.1\):\(q_y = 0.91,\ q_{i\neq y} = 0.01\),\(\Delta z^* = \ln(91) \approx 4.5109\)。因压低目标置信度上限至 \(0.91\),NLL 与 PPL 略增;但有界间隔防止末层过自信并保留次优词概率梯度,使 Beam Search 测试 BLEU 提高(\(3\) 分)。
- 令两段相等 \(t^{-0.5} = t\cdot t_w^{-1.5} \implies t_{\text{peak}} = t_w\),\(\eta_{\max} = (d_{\text{model}}\cdot t_w)^{-0.5}\)(\(2\) 分)。代入 \(t_w=4000\):Base 峰值 \(\eta(4000) = (512\times 4000)^{-0.5} \approx 6.9877\times 10^{-4}\);\(t=1000\) 为峰值 \(1/4\) 即 \(1.7469\times 10^{-4}\);\(t=16000\) 为峰值 \(1/2\) 即 \(3.4939\times 10^{-4}\);Big 峰值缩小 \(1/\sqrt{2}\) 倍至 \(4.9411\times 10^{-4}\)(\(4\) 分)。
对应补漏章节:26|前馈网络、27|原论文训练配方。
第
3 题(25 分):LoRA SVD 低秩逼近、首步梯度与 SFT
-100 掩码及打包泄漏
- (a)(7 分) 陈述 Eckart-Young-Mirsky 定理如何保证截断奇异值分解 \(A_k = \sum_{i=1}^k \sigma_i \mathbf{u}_i\mathbf{v}_i^\top\) 是最优秩-\(k\) 逼近;设某 \(4\times 4\) 任务理想权重增量 \(\Delta W^*\) 的奇异值为 \((6.0, 2.0, 0.4, 0.2)\),计算秩-\(1\) 逼近的精确弗罗贝尼乌斯误差 \(\|\Delta W^* - \Delta W_1^*\|_F\)、相对误差及保留的能量比例(平方和比);再计算将 \(4096\times 4096\) 线性层改用秩 \(r=16\) LoRA 微调后的可训练参数压缩比。
- (b)(9 分) 设 LoRA 前向变换为 \(\mathbf{y} = W_0\mathbf{x} + s\,B(A\mathbf{x})\)(\(s = \alpha/r\),上游梯度 \(\mathbf{g}_y = \nabla_{\mathbf{y}}L\))。写出 \(\nabla_B L\) 与 \(\nabla_A L\) 的精确公式,证明为什么必须用 \(B_0 = \mathbf{0},\ A_0 \neq \mathbf{0}\) 而不能两者同时置零;取 \(W_0 = I_2,\ \mathbf{x}=(1, 2)^\top,\ \mathbf{y}^*=(2, 0)^\top,\ L=\frac{1}{2}\|\mathbf{y}-\mathbf{y}^*\|_2^2,\ r=1,\ \alpha=2,\ B_0=(0, 0)^\top,\ A_0=(1, 1),\ \eta=0.02\),手算第 \(0\) 步的 \(\nabla_{B_0}L,\ \nabla_{A_0}L\),以及一次 SGD 更新后第 \(1\) 步的 \(\mathbf{y}_1,\ L_1,\ \nabla_{B_1}L,\ \nabla_{A_1}L\)。
- (c)(9 分) 一条打包 SFT
样本缓冲区包含两段独立文档(词表大小 \(|V|=2\)):文档 1 占预测位置
\(t=1, 2\)(\(t=1\) 为 Prompt,\(t=2\) 为 Completion),目标
token ID 依次为
[0, 1];文档 2 占预测位置 \(t=3, 4\)(\(t=3\) 为 Prompt,\(t=4\) 为 Completion),目标 token ID 依次为[1, 0]。模型输出 logits 为 \(Z = \begin{pmatrix} 0.0 & 1.5 \\ 0.0 & 1.0 \\ 1.0 & 0.0 \\ 1.5 & 0.0 \end{pmatrix}\)。- 分别计算忘记掩码(全 \(4\) 步均值)与正确设置
labels = [-100, 1, -100, 0]后的交叉熵损失,并算出未掩码时 Prompt 位置占总损失的百分比; - 若打包时误用普通 \(4\times
4\) 下三角因果掩码而非块对角掩码 \(M_{\text{pack}}\),请列出(用
1-based 位置对 \((i, j)\)
表示)所有发生跨文档信息泄漏的注意力位置对,并写出 RoPE
应使用的
position_ids重置序列。
- 分别计算忘记掩码(全 \(4\) 步均值)与正确设置
参考答案与评分细则(先独立推导再展开)
- (a) Eckart-Young 截断与 LoRA 参数预算(7
分):
- 在所有秩 \(\le k\) 矩阵中,\(A_k\) 同时最小化 \(\|\cdot\|_F\)(最优误差 \(\sqrt{\sum_{i>k}\sigma_i^2}\))和 \(\|\cdot\|_2\)(\(\sigma_{k+1}\))(\(2\) 分)。
- \(\|\Delta W^*\|_F^2 = 36 + 4 + 0.16 + 0.04 = 40.20\);秩-\(1\) 绝对误差 \(\sqrt{4 + 0.16 + 0.04} = \sqrt{4.20} \approx 2.0494\),相对误差 \(\sqrt{4.20/40.20} \approx 32.32\%\),能量占比 \(36/40.20 \approx 89.55\%\)(\(3\) 分)。
- 参数比 \(\frac{2\times 16 \times 4096}{4096^2} = \frac{32}{4096} = \frac{1}{128} \approx 0.781\%\)(压缩 \(128:1\))(\(2\) 分)。
- (b) LoRA 梯度流推导与手算(9 分):
- \(\nabla_B L = s\,\mathbf{g}_y (A\mathbf{x})^\top\),\(\nabla_A L = s\,B^\top \mathbf{g}_y \mathbf{x}^\top\)。若 \(A_0=B_0=\mathbf{0}\),两者梯度恒为零锁死在鞍点;取 \(B_0=\mathbf{0},\ A_0\neq \mathbf{0}\) 则首步旁路输出为零不扰动基座,同时 \(\nabla_{B_0}L \neq \mathbf{0}\) 激活 \(B_1\) 更新,进而在第 \(1\) 步解锁 \(\nabla_{A_1}L\)(\(3\) 分)。
- 第 \(0\) 步(\(3\) 分):\(s=2\),\(h_0 = A_0\mathbf{x} = 3\),\(\mathbf{y}_0 = (1, 2)^\top\),\(L_0 = \frac{1}{2}(1+4) = 2.5000\);\(\mathbf{g}_{y,0} = \mathbf{y}_0 - \mathbf{y}^* = (-1, 2)^\top\),得 \(\nabla_{B_0}L = 2(-1, 2)^\top\cdot 3 = (-6, 12)^\top\),\(\nabla_{A_0}L = (0, 0)\)。
- 更新与第 \(1\) 步(\(3\) 分):\(B_1 = B_0 - 0.02(-6, 12)^\top = (0.12, -0.24)^\top\),\(A_1 = (1, 1)\)。第 \(1\) 步 \(\mathbf{y}_1 = (1, 2)^\top + 2\cdot 3\cdot (0.12, -0.24)^\top = (1.72, 0.56)^\top\),\(L_1 = \frac{1}{2}((-0.28)^2 + 0.56^2) = 0.1960\);\(\mathbf{g}_{y,1} = (-0.28, 0.56)^\top\),\(\nabla_{B_1}L = 6\mathbf{g}_{y,1} = (-1.68, 3.36)^\top\),\(\nabla_{A_1}L = 2 B_1^\top \mathbf{g}_{y,1} \mathbf{x}^\top = 2(0.12(-0.28) - 0.24(0.56))(1, 2) = -0.336(1, 2) = (-0.336, -0.672)\)。
- (c) SFT
-100掩码与打包泄漏(9 分):- 逐行算 NLL(\(3\)
分):
- \(t=1\)(目标 \(0\)):\(\ell_1 = \ln(1 + e^{1.5}) \approx 1.701413\);
- \(t=2\)(目标 \(1\)):\(\ell_2 = \ln(1 + e^{-1.0}) \approx 0.313262\);
- \(t=3\)(目标 \(1\)):\(\ell_3 = \ln(1 + e^{1.0}) \approx 1.313262\);
- \(t=4\)(目标 \(0\)):\(\ell_4 = \ln(1 + e^{-1.5}) \approx 0.201413\)。
- 未掩码均值 \(\frac{1.701413+0.313262+1.313262+0.201413}{4}
\approx 0.8823\),其中 Prompt 占比 \(\frac{1.701413+1.313262}{3.529350}
\approx 85.42\%\);掩码
-100后均值 \(\frac{0.313262 + 0.201413}{2} \approx 0.2573\)(\(3\) 分)。 - 普通因果掩码下文档 2 的位置 \(3, 4\) 会偷看到文档 1 的位置
\(1, 2\),泄漏集合共 \(4\) 处:\((3,1), (3,2), (4,1),
(4,2)\);
position_ids必须按文档边界重置为 \([0, 1, 0, 1]\)(\(3\) 分)。
- 逐行算 NLL(\(3\)
分):
第 4 题(25 分):DPO/GRPO 对齐推导、Chinchilla 拉格朗日求解与三大路线掩码秩及 KV 复用
- (a)(8 分) 从带参考策略 KL 正则的 RLHF 目标 \(\max_\pi \mathbb{E}_{y\sim\pi(\cdot\mid x)}[r(x,y)] - \beta D_{\mathrm{KL}}(\pi(\cdot\mid x)\|\pi_{\mathrm{ref}}(\cdot\mid x))\) 出发,构造拉格朗日函数求得闭式最优策略 \(\pi^*(y\mid x)\) 并反解出 \(r(x,y)\);证明在成对 Bradley-Terry 差值 \(r(x,y_w)-r(x,y_l)\) 中配分函数项 \(\beta\log Z(x)\) 精确相消导出 DPO 损失;再对 GRPO 采样组 \(G=4\) 的二值奖励 \(\mathbf{r}_A = (1, 1, 0, 0)\) 与全对组 \(\mathbf{r}_B = (1, 1, 1, 1)\) 分别求出各自优势向量 \(\hat{\mathbf{A}}\),说明全对/全错组为何导致梯度批萎缩。
- (b)(10 分) 给定 Chinchilla 参数化损失 \(L(N, D) = E + A N^{-\alpha} + B D^{-\beta}\) 与训练算力等式 \(g(N, D) = 6ND - C = 0\)。用拉格朗日乘数法严格推导边际均衡条件 \(\alpha A N^{-\alpha} = \beta B D^{-\beta}\) 与闭式指数 \(a = \frac{\beta}{\alpha+\beta},\ b = \frac{\alpha}{\alpha+\beta}\);采用 Chinchilla 论文 Appendix D.2 拟合常数(\(A=406.4,\ B=410.7,\ \alpha=0.34,\ \beta=0.28\))与固定算力 \(C = 6 \times 10^{21}\) FLOPs,算出最优 \((N^*, D^*)\) 及最优比 \(D^*/N^*\);简述为什么 Kaplan(2020)得到偏斜的 \(0.73\) vs \(0.27\),而现代推理高频模型(如 Llama 3 8B 训 \(15\text{T}\) tokens)又反过来突破 Chinchilla 比例主动“过训”。
- (c)(7 分) 对长度为 \(4\) 的零打分矩阵 \(S = \mathbf{0}_{4\times
4}\),写出
Encoder-only(\(M_{\text{enc}}\))与Decoder-only(\(M_{\text{causal}}\))经行 Softmax 后的基础注意力矩阵 \(A_{\text{enc}}^{(0)}\) 与 \(A_{\text{causal}}^{(0)}\),计算两者的矩阵秩与行列式,解释为什么无位置编码时因果模型(NoPE)依然可打破行置换对称性;另算一笔 Prefix Cache 账:有 \(K = 8\) 个并发请求共享长度 \(P = 3000\) 的系统提示词、各附带 \(Q = 250\) token 的用户提问,对比Decoder-only + Prefix Caching与Encoder-Decoder所需编码/Prefill 总 token 数及比值。
参考答案与评分细则(先独立推导再展开)
- (a) DPO 配分函数相消与 GRPO 优势(8
分):
- 含归一化约束的拉格朗日函数驻点给出 \(\pi^*(y\mid x) = \frac{1}{Z(x)}\pi_{\mathrm{ref}}(y\mid x)\exp\!\big(\frac{r(x,y)}{\beta}\big)\),其中 \(Z(x) = \sum_{y'}\pi_{\mathrm{ref}}(y'\mid x)\exp(r(x,y')/\beta)\)(\(2\) 分)。
- 两边取对数反解得 \(r(x,y) = \beta\log\frac{\pi^*(y\mid x)}{\pi_{\mathrm{ref}}(y\mid x)} + \beta\log Z(x)\);在同一个 \(x\) 下代入 \(r(x,y_w)-r(x,y_l)\) 时,\(\beta\log Z(x)\) 仅依赖 \(x\) 而严格相消,代入 Bradley-Terry 负对数似然即得 DPO 损失(\(3\) 分)。
- 对 \(\mathbf{r}_A = (1, 1, 0, 0)\):均值 \(0.5\),总体标准差 \(\sigma = 0.5\),优势 \(\hat{\mathbf{A}}_A = (+1, +1, -1, -1)\);对 \(\mathbf{r}_B = (1, 1, 1, 1)\):\(\sigma = 0\),优势全退化为 \((0, 0, 0, 0)\),导致样本对策略梯度无有效更新(需过采样过滤)(\(3\) 分)。
- (b) Chinchilla 拉格朗日推导与算例(10
分):
- 构造 \(\mathcal{L}(N,D,\lambda) = E + AN^{-\alpha} + BD^{-\beta} + \lambda(6ND - C)\),令偏导为零:\(\frac{\alpha A N^{-\alpha-1}}{6D} = \frac{\beta B D^{-\beta-1}}{6N} \implies \alpha A N^{-\alpha} = \beta B D^{-\beta}\)(\(3\) 分)。解出 \(D = (\frac{\beta B}{\alpha A})^{1/\beta} N^{\alpha/\beta}\) 代入 \(6ND=C\) 得 \(N^* = G(C/6)^a,\ D^* = G^{-1}(C/6)^b\),其中 \(a=\frac{\beta}{\alpha+\beta},\ b=\frac{\alpha}{\alpha+\beta},\ G=(\frac{\alpha A}{\beta B})^{1/(\alpha+\beta)}\)(\(2\) 分)。
- 代入数值:\(a = 0.28/0.62 \approx 0.451613\),\(b = 0.34/0.62 \approx 0.548387\),\(\frac{\alpha A}{\beta B} = \frac{138.176}{114.996} \approx 1.201572 \implies G \approx 1.344711\)。由于 \(C/6 = 10^{21}\),得 \(N^* \approx 4.0973 \times 10^9\)(约 \(4.10\text{B}\) 参数),\(D^* = 10^{21}/N^* \approx 2.4406 \times 10^{11}\)(约 \(244.06\text{B}\) tokens),\(D^*/N^* \approx 59.57\)(\(3\) 分)。
- Kaplan(2020)截取固定长余弦调度的早停中间检查点,高估了少数据区域的损失,将最优解歪推向大模型少数据;现代模型则把全生命周期推理算力 \(2ND_{\text{inf}}\) 纳入总预算 \(C_{\text{tot}} = 6ND + 2ND_{\text{inf}}\),驻点变为 \(\alpha AN^{-\alpha} = \beta B D^{-\beta}(1 + \frac{D_{\text{inf}}}{3D})\),促使模型主动缩容并显著延长训练 token 数(\(2\) 分)。
- (c) 掩码矩阵秩与 Prefix Cache 计算(7
分):
- \(A_{\text{enc}}^{(0)}\) 所有行均为 \([0.25, 0.25, 0.25, 0.25]\),\(\operatorname{rank}=1,\ \det=0\);\(A_{\text{causal}}^{(0)}\) 为下三角矩阵,主对角元为 \(1, \frac{1}{2}, \frac{1}{3}, \frac{1}{4}\),满秩 \(\operatorname{rank}=4\) 且 \(\det = \frac{1}{24} \approx 0.0417 \neq 0\)。不同位置的逐行平均方差随 \(1/i\) 递减,故无位置编码的因果注意力仍能打破行置换对称(\(4\) 分)。
Decoder-only + Prefix Caching总 Prefill \(= 3000 + 8\times 250 = 5{,}000\) tokens;Encoder-Decoder因第 \(3001\) 词会通过双向掩码重写前 \(3000\) 词,无法复用前缀,总计 \(8\times (3000 + 250) = 26{,}000\) tokens,耗费了 \(5.20\times\) 计算量(\(3\) 分)。
对应补漏章节:33|RLHF:从 PPO 到 DPO,再到 GRPO、34|Scaling Laws、40|三大路线之争。
四、Final Exam:前沿架构演进、推理工程、可解释性与后 Transformer(120 分,建议 120 分钟)
第 1 题(24 分):RoPE 旋转群相对位置推导与 FlashAttention Online Softmax 分块验算
- (a)(12 分) 设 RoPE
构造分块对角正交旋转矩阵 \(R_{\Theta, m} =
\bigoplus_{i=0}^{d/2-1} R(m\theta_i)\),其中 \(\theta_i =
\text{base}^{-2i/d}\)。
- (4 分)从矩阵正交性 \(R_{\Theta, m}^\top = R_{\Theta, -m}\) 与旋转群可加性出发,证明 \(\mathbf{q}_m^\top \mathbf{k}_n = (R_{\Theta, m} W_Q\mathbf{x}_m)^\top (R_{\Theta, n} W_K\mathbf{x}_n) = \mathbf{x}_m^\top W_Q^\top R_{\Theta, n-m} W_K\mathbf{x}_n\);
- (4 分)在单二维块(\(d=2,\ \theta_0 = \pi/3\))下,设未旋转特征 \(W_Q\mathbf{x}_1 = (2, 0)^\top\)(位置 \(m=1\))与 \(W_K\mathbf{x}_4 = (1, \sqrt{3})^\top\)(位置 \(n=4\))。分别用“先各自旋转再做点积”和“直接用相对旋转矩阵 \(R_{\Theta, 4-1}\) 作用”两种方式手算结果,确认完全一致;
- (4 分)当单头维度 \(d=128\)、上下文长度 \(L = 131{,}072\)(\(128\text{K}\))时,第 \(i\) 个通道(\(i=0, \dots, 63\))旋转周期为
\(T_i = 2\pi\cdot
\text{base}^{2i/d}\)。利用对数判定 \(T_i \le L\) 求出 \(\text{base}=10{,}000\) 与 \(\text{base}=500{,}000\)
下各自至少绕完一圈的通道总数(已知 \(\ln(131072 / (2\pi)) \approx
9.9456\),\(\ln 10000
\approx 9.2103\),\(\ln
500000 \approx 13.1224\)),说明为何调大
rope_theta只能推迟而非消灭绕圈失真。
- (b)(12 分) FlashAttention 用 SRAM
Tiling 与 Online Softmax 避免把 \(N\times N\) 矩阵写入 HBM。
- (4 分)设第 \(1\) 块统计量为 \((m_1, l_1, o_1)\)(其中 \(o_1\) 为第 \(1\) 块已归一化的输出均值向量),第 \(2\) 块局部统计量为 \((m_2, l_2, \tilde{o}_2)\)(其中 \(\tilde{o}_2 = \sum_{j\in B_2} e^{s_j - m_2} v_j\) 为未除 \(l_2\) 的局部加权和),写出跨块合并后的全局统计量 \((m_{\text{new}}, l_{\text{new}}, o_{\text{new}})\) 递推公式;
- (8 分)2-Block 手算验算:设单行查询与 \(4\) 个键的缩放分数分为两块 \(\mathbf{s}^{(1)} = [1.0, 3.0]\)、\(\mathbf{s}^{(2)} = [4.0, 2.0]\),对应标量值 \(\mathbf{v}^{(1)} = [2.0, 4.0]\)、\(\mathbf{v}^{(2)} = [6.0, 1.0]\)。用上述两步 Online Softmax 分块递推算法算出最终输出 \(o_{\text{new}}\)(保留 \(6\) 位小数),并与全局物化标准 Softmax 结果对比验证(已知 \(e^{-1}\approx 0.367879,\ e^{-2}\approx 0.135335,\ e^{-3}\approx 0.049787\));简述为何 FlashAttention 能将 HBM 访问降至下界 \(\Theta(N^2 d^2 M^{-1})\) 却仍保持 \(\Theta(N^2 d)\) 计算量。
参考答案与评分细则(先独立推导再展开)
- (a) RoPE 推导、二维验算与绕圈通道计数(12
分):
- 因为每对 \(2\times 2\) 旋转块满足 \(R(m\theta_i)^\top = R(-m\theta_i)\) 且 \(R(-m\theta_i)R(n\theta_i) = R((n-m)\theta_i)\),块对角矩阵随之满足 \(R_{\Theta, m}^\top R_{\Theta, n} = R_{\Theta, n-m}\)。代入内积得 \(\mathbf{x}_m^\top W_Q^\top R_{\Theta, m}^\top R_{\Theta, n} W_K\mathbf{x}_n = \mathbf{x}_m^\top W_Q^\top R_{\Theta, n-m} W_K\mathbf{x}_n\),绝对坐标完全抵消(\(4\) 分)。
- 路径一:\(R(\pi/3)(2, 0)^\top = (2\cos\frac{\pi}{3}, 2\sin\frac{\pi}{3})^\top = (1, \sqrt{3})^\top\);\(R(4\pi/3)(1, \sqrt{3})^\top = (1, -\sqrt{3})^\top\)(\((1,\sqrt{3})\) 极角 \(\pi/3\) 旋转 \(4\pi/3\) 至 \(5\pi/3\)),点积 \(1\cdot 1 + \sqrt{3}(-\sqrt{3}) = -2\)。路径二:\(n-m=3 \implies R(3\cdot\pi/3) = R(\pi) = -I_2\),点积 \((2, 0)\cdot(-I_2)(1,\sqrt{3})^\top = -2\),完全重合(\(4\) 分)。
- 临界条件 \(\frac{2i}{128}\ln(\text{base}) \le
\ln(L/(2\pi)) \approx 9.9456 \implies i \le 64\cdot
\frac{9.9456}{\ln(\text{base})}\)(\(i\in\{0,\dots,63\}\)):
- \(\text{base}=10{,}000\):\(i \le 64\times \frac{9.9456}{9.2103} \approx 69.11 \implies\) 全部 \(64/64\) 通道已绕至少一圈;
- \(\text{base}=500{,}000\):\(i \le 64\times \frac{9.9456}{13.1224}
\approx 48.51 \implies i = 0,\dots,48\) 共
\(49/64\)
通道已绕圈(仅剩 \(15\)
个低频通道保持单调)。且最高频通道 \(i=0\) 周期恒为 \(2\pi\) 与
base无关,故无法消灭绕圈(\(4\) 分)。
- (b) Online Softmax 公式与 2-Block 验算(12
分):
- \(m_{\text{new}} = \max(m_1, m_2)\),\(l_{\text{new}} = e^{m_1-m_{\text{new}}}l_1 + e^{m_2-m_{\text{new}}}l_2\),\(o_{\text{new}} = \frac{e^{m_1-m_{\text{new}}} l_1 o_1 + e^{m_2-m_{\text{new}}}\tilde{o}_2}{l_{\text{new}}}\)(\(4\) 分)。
- 分块手算(\(6\) 分):
- Block 1:\(m_1 = 3.0\),\(l_1 = e^{-2} + 1 \approx 1.135335\),\(o_1 = \frac{2e^{-2} + 4}{1.135335} \approx \frac{4.270671}{1.135335} \approx 3.761594\);
- Block 2:\(m_2 = 4.0\),\(l_2 = 1 + e^{-2} \approx 1.135335\),\(\tilde{o}_2 = 6\cdot 1 + 1\cdot e^{-2} \approx 6.135335\);
- 合并:\(m_{\text{new}} = 4.0\),\(l_{\text{new}} = e^{-1}(1.135335) + 1.135335 \approx 0.417666 + 1.135335 = 1.553002\);分子 \(= e^{-1}(4.270671) + 6.135335 \approx 1.571092 + 6.135335 = 7.706427\);故 \(o_{\text{new}} = \frac{7.706427}{1.553002} \approx \mathbf{4.962278}\)。
- 全局标准核对:以 \(m=4.0\) 计算 \([e^{-3}, e^{-1}, 1, e^{-2}]\) 和为 \(1.553002\),加权值分子同样为 \(2e^{-3}+4e^{-1}+6+e^{-2} \approx 7.706427\),比值精确等于 \(4.962278\)。
- Online Softmax 将全部中间分块乘加融合在片上 SRAM 内完成,避免向 HBM 读写 \(O(N^2)\) 的分数与概率矩阵;但所有 \(Q_i K_j^\top\) 与概率乘 \(V_j\) 的算术乘加一个未少,故 FLOPs 仍为 \(\Theta(N^2 d)\)(\(2\) 分)。
对应补漏章节:41|位置编码演进、42|FlashAttention。
第 2 题(24 分):MoE 负载均衡 Cauchy-Schwarz 最优下界与 DeepSeek MLA 矩阵吸收压缩账
- (a)(11 分) 在拥有 \(E\) 个专家的 MoE
层中,定义辅助负载均衡损失 \(L_{\text{aux}} = \alpha \cdot E
\sum_{i=1}^E f_i P_i\)(其中 \(f_i \ge 0\) 为实际路由到专家
\(i\) 的 token 比例且 \(\sum_{i=1}^E f_i = 1\),\(P_i \ge 0\)
为路由器平均分配给专家 \(i\) 的概率质量且 \(\sum_{i=1}^E P_i = 1\))。
- (5 分)当策略梯度更新使门控概率分布趋近实际比例(\(P_i = f_i\))时,利用 Cauchy-Schwarz 不等式证明 \(\sum_{i=1}^E f_i^2 \ge \frac{1}{E}\),从而严格证明均匀负载 \(f_i = P_i = 1/E\) 使 \(L_{\text{aux}}\) 取得全局最小值 \(\alpha\);
- (6 分)设 \(E = 8,\ \alpha =
0.01\)。对比完全均衡分布(\(f_i = P_i =
1/8\))与“双专家塌缩”分布(\(f_1=f_2=0.5,\
P_1=P_2=0.5\),其余 \(6\) 个专家均为 \(0\))下 \(L_{\text{aux}}\)
的精确数值;说明当
capacity_factor = 1.0且出现局部负载集中时,为什么被丢弃(dropped)的 token 会集中损害特定领域或代码片段,而不是均匀掉点。
- (b)(13 分) DeepSeek MLA(Multi-head
Latent Attention)借助 Strang 矩阵乘法结合律压缩 KV Cache:
- (6 分)记隐藏状态 \(\mathbf{h}_t \in \mathbb{R}^d\) 经降维投影得到共享低维潜向量 \(\mathbf{c}_{KV, t} = W_{DKV}\mathbf{h}_t \in \mathbb{R}^{d_c}\),第 \(j\) 个头的无位置内容键由上投影 \(W_{UK}^{(j)} \in \mathbb{R}^{d_h\times d_c}\) 恢复为 \(\mathbf{k}_{s}^{C,(j)} = W_{UK}^{(j)}\mathbf{c}_{KV, s}\)。已知查询 \(\mathbf{q}_t^{(j)} = W_Q^{(j)}\mathbf{h}_t\),利用矩阵乘法结合律推导如何把 \(W_{UK}^{(j)}\) 吸收进查询端,使推理阶段 KV Cache 只需存储 \(\mathbf{c}_{KV, s}\) 而无需物化各头键向量;同时解释为什么 RoPE 必须拆到独立的解耦通道 \(\mathbf{k}_s^R\) 而不直接作用在 \(\mathbf{k}_s^{C,(j)}\) 上;
- (7 分)KV Cache 显存账本:考虑一个 \(L = 60\) 层、查询头数 \(H = 128\)、头维 \(d_h = 128\) 的大模型,在 \(B = 1\)、上下文长度 \(S = 131{,}072\)(\(128\text{K}\))、BF16(\(2\) bytes)精度下,分别计算以下三种架构的总 KV Cache 占用(以 \(\text{GiB}\) 为单位,\(1\text{ GiB} = 2^{30}\) bytes):标准 MHA(\(H_{kv}=128\))、GQA-8(\(H_{kv}=8\))与 MLA(每层每 token 仅缓存共享潜向量 \(d_c = 512\) 加上解耦 RoPE 共享键 \(d_R = 64\),共 \(d_c + d_R\) 维),并算出 MLA 相对 MHA 与 GQA-8 的显存压缩倍数。
参考答案与评分细则(先独立推导再展开)
- (a) MoE 负载均衡证明与塌缩计算(11
分):
- 对向量 \(\mathbf{f}=(f_1,\dots,f_E)^\top\) 与全 \(1\) 向量 \(\mathbf{1}\) 应用 Cauchy-Schwarz 不等式:\(1 = (\mathbf{1}^\top \mathbf{f})^2 \le \|\mathbf{1}\|_2^2 \|\mathbf{f}\|_2^2 = E \sum_{i=1}^E f_i^2 \implies \sum_{i=1}^E f_i^2 \ge \frac{1}{E}\)(等号成立当且仅当 \(\mathbf{f} \parallel \mathbf{1}\) 即 \(f_i = 1/E\))。代入得 \(L_{\text{aux}} = \alpha E \sum f_i^2 \ge \alpha E \cdot \frac{1}{E} = \alpha\)(\(5\) 分)。
- 均衡时 \(L_{\text{aux}} = 0.01 \times 8 \times (8\times \frac{1}{64}) = \mathbf{0.0100}\);双专家塌缩时 \(L_{\text{aux}} = 0.01 \times 8 \times (0.25 + 0.25) = \mathbf{0.0400}\)(放大 \(4\) 倍)(\(3\) 分)。由于同域或同类代码 token 隐状态相近且在同一 batch 内集中涌入同一专家,溢出后这些特定语义样本跳过 FFN 只走残差通路,导致性能塌陷集中在特定领域而非均匀降噪(\(3\) 分)。
- (b) DeepSeek MLA 结合律吸收与显存计算(13
分):
- 利用矩阵乘法结合律:\((\mathbf{q}_t^{(j)})^\top \mathbf{k}_s^{C,(j)} = (\mathbf{h}_t^\top {W_Q^{(j)}}^\top)(W_{UK}^{(j)}\mathbf{c}_{KV, s}) = \big(\mathbf{h}_t^\top ({W_Q^{(j)}}^\top W_{UK}^{(j)})\big)\mathbf{c}_{KV, s}\)。将合并矩阵 \(\widetilde{W}_Q^{(j)} = {W_{UK}^{(j)}}^\top W_Q^{(j)}\) 预先离线吸收,推理时只需把窄向量 \(\mathbf{c}_{KV, s} \in \mathbb{R}^{d_c}\) 写入缓存(同理 \(W_{UV}^{(j)}\) 吸收进输出投影 \(W_O^{(j)}\))(\(4\) 分)。若在 \(\mathbf{k}_s^C\) 上直接施加位置依赖的旋转矩阵 \(R_{\Theta, s}\),它会插在 \(W_{UK}^{(j)}\) 左侧,阻断 \({W_Q^{(j)}}^\top R_{\Theta, s} W_{UK}^{(j)}\) 的离线合并;因此必须把 RoPE 放到单独的低维共享旁路 \(\mathbf{k}_s^R\) 中(\(2\) 分)。
- 显存计算(\(S = 2^{17} =
131{,}072\),注意 \(1\text{
GiB} = 2^{30}\))(\(7\) 分):
- MHA:\(2 \times 60 \times 128 \times 128 \times 2^{17} \times 2 = 60 \times 2^{33} = 480.00\text{ GiB}\)(每 token \(3{,}932{,}160\) bytes);
- GQA-8:\(2 \times 60 \times 8 \times 128 \times 2^{17} \times 2 = 60 \times 2^{29} = \mathbf{30.00\text{ GiB}}\)(每 token \(245{,}760\) bytes);
- MLA:\(60 \times (512 + 64) \times 2^{17} \times 2 = 60 \times 576 \times 2^{18} = 8.4375\text{ GiB}\)(每 token \(69{,}120\) bytes);
- 压缩比:相对 MHA 压缩 \(56.89\times\)(节省 \(98.24\%\) 显存),相对 GQA-8 再压缩 \(3.56\times\)。
第 3 题(24 分):无损投机采样无偏性证明与 Temperature / Top-\(p\) 解码陷阱
- (a)(10 分) 给定有限词表 \(\mathcal{V}\) 上的草稿分布 \(q(x)\) 与目标分布 \(p(x)\)(设分母非零情况)。在 Speculative Decoding 中:先采样 \(x \sim q\),以概率 \(\min\big(1, \frac{p(x)}{q(x)}\big)\) 接受并输出 \(x\);若拒绝,则从残差分布 \(p'(y) = \frac{\max(0,\ p(y) - q(y))}{\sum_{z\in\mathcal{V}} \max(0,\ p(z) - q(z))}\) 重采样输出 \(y\)。严格证明对任意 \(y \in \mathcal{V}\),最终输出分布满足 \(\mathbb{P}(\text{output} = y) = p(y)\)。
- (b)(7 分) 设草稿长度 \(K = 4\),独立近似接受率 \(\alpha = 0.75\),草稿模型相对目标模型的单步耗时比 \(c = 0.05\)。依据 Leviathan 等人(ICML 2023)的公式 \(\mathbb{E}[\text{tokens}] = \frac{1-\alpha^{K+1}}{1-\alpha}\) 与 \(\mathbb{E}[\text{speedup}] = \frac{1-\alpha^{K+1}}{(1-\alpha)(Kc+1)}\),计算每轮期望产出 token 数与期望加速比(保留 \(4\) 位小数);并从 GPU Roofline 算术强度角度解释为什么批大小(batch size)从 \(1\) 增大至 \(128\) 时,实际加速比会单调下降甚至跌破 \(1\times\)。
- (c)(7 分) 设词表仅有 \(4\) 个词 \(\{A, B, C, D\}\),当前步原始
logits 为 \(\mathbf{z} = [3.0,
2.0, 1.0, 0.0]\)。
- (5 分)比较两种常见推理引擎顺序:方案一(Hugging Face 默认顺序)先按原始分布做 \(\text{Top-}p = 0.80\) 核截断,再对保留集合施加温度 \(T = 2.0\) 缩放并重新归一化;方案二(vLLM 顺序)先施加温度 \(T = 2.0\) 缩放,再做 \(\text{Top-}p = 0.80\) 核截断并重新归一化。分别手算两个方案保留下来的候选词集合及其最终采样概率(保留 \(4\) 位小数);
- (2
分)说明为什么在代码生成与专有名词抽取任务中,盲目调高
frequency_penalty或repetition_penalty往往产生负优化。
参考答案与评分细则(先独立推导再展开)
- (a) 投机采样无偏性证明(10 分):
- 对任意词 \(y\),输出 \(y\) 来自“直接接受”或“拒绝后重采样”两个互斥事件之和: \[ \mathbb{P}(\text{output}=y) = q(y)\min\!\left(1, \frac{p(y)}{q(y)}\right) + \left(1 - \sum_{x\in\mathcal{V}} q(x)\min\!\left(1, \frac{p(x)}{q(x)}\right)\right)\frac{\max(0,\ p(y) - q(y))}{\sum_{z\in\mathcal{V}} \max(0,\ p(z) - q(z))} \] (\(3\) 分)。
- 利用恒等式 \(q(x)\min(1, p(x)/q(x)) = \min(p(x), q(x))\) 与逐点恒等式 \(\min(p(x), q(x)) + \max(0, p(x) - q(x)) = p(x)\)(按 \(p\ge q\) 与 \(p<q\) 两种情形立证)(\(4\) 分)。
- 对全体 \(x\) 求和得 \(\sum_z \max(0, p(z) - q(z)) = 1 - \sum_x \min(p(x), q(x))\),恰好等于总拒绝概率,分母分子相消,最终化简为 \(\min(p(y), q(y)) + \max(0, p(y) - q(y)) = p(y)\),与直采目标模型严格同分布(\(3\) 分)。
- (b) 加速比计算与 Batch 瓶颈迁移(7
分):
- \(\mathbb{E}[\text{tokens}] = \frac{1 - 0.75^5}{1 - 0.75} = \frac{1 - 0.237305}{0.25} \approx \mathbf{3.0508}\) tokens/轮;相对时间代价 \(Kc + 1 = 4\times 0.05 + 1 = 1.20\);理论加速比 \(\mathbb{E}[\text{speedup}] = \frac{3.050781}{1.20} \approx \mathbf{2.5423\times}\)(\(4\) 分)。
- batch \(= 1\) 时目标模型验证多 token 几乎处于 memory-bound 区间,搬运一次权重附带多算 \(K\) 个位置近乎“免费”;当 batch 增至 \(128\) 时,算术强度突破 GPU Roofline 拐点进入 compute-bound,被拒绝的草稿候选白白占用 Tensor Core 算力并挤占并发带宽,导致收益收缩甚至倒贴(\(3\) 分)。
- (c) Top-\(p\)
与 Temperature 顺序差及惩罚代价(7 分):
- 原始分布 \(\operatorname{softmax}([3,2,1,0])
\approx [0.6439,\ 0.2369,\ 0.0871,\ 0.0321]\):
- 方案一(先 Top-\(p=0.80\) 再 \(T=2.0\)):前 \(2\) 词累计 \(0.6439+0.2369 = 0.8808 \ge 0.80\),保留 \(\{A, B\}\);再取 logits \([1.5, 1.0]\) 做 softmax 得 \(\mathbf{[0.6225,\ 0.3775,\ 0,\ 0]}\)(\(2.5\) 分);
- 方案二(先 \(T=2.0\) 再 Top-\(p=0.80\)):\(\mathbf{z}/2 = [1.5, 1.0, 0.5, 0.0]\) 的分布为 \([0.4551,\ 0.2760,\ 0.1674,\ 0.1015]\),前 \(2\) 词累计 \(0.7311 < 0.80\),前 \(3\) 词累计 \(0.8985 \ge 0.80\),因此保留 \(\{A, B, C\}\),重归一化为 \(\mathbf{[0.5065,\ 0.3072,\ 0.1863,\ 0]}\)(\(2.5\) 分)。可见顺序直接改写了截断集合大小与概率分布。
- 代码变量名、
if/return、JSON 键名以及人名/专有名词本来就需要频繁原样重复;全局惩罚无差别压低已出现 token 的 logit,会诱发变量改名编译失败、JSON schema 错乱或代词指代混乱(\(2\) 分)。
- 原始分布 \(\operatorname{softmax}([3,2,1,0])
\approx [0.6439,\ 0.2369,\ 0.0871,\ 0.0321]\):
第 4 题(24 分):Elhage QK/OV 电路特征分解、诱导头组合与 \(TC^0\) 表达力边界
- (a)(10 分) 在 Elhage 等人(Anthropic,
2021)零层偏置无 MLP
简化模型中,单头注意力写入残差流的运算为 \(h(X) = A X W_V W_O\),其中
\(A =
\operatorname{softmax}\!\left(\frac{X W_Q W_K^\top
X^\top}{\sqrt{d_k}} + M_{\text{causal}}\right)\)。
- (5 分)指出 QK 电路矩阵(\(W_{QK} = W_Q W_K^\top\))与 OV 电路矩阵(\(W_{OV} = W_V W_O\))各自决定的计算语义与秩上限;假设在 \(3\) 维残差流正交基上测得某注意力头的等效 OV 矩阵为 \(W_{OV} = \begin{pmatrix} 1.5 & 0.5 & 0 \\ 0.5 & 1.5 & 0 \\ 0 & 0 & -0.5 \end{pmatrix}\),求其全部特征值与对应特征方向,解释为什么正特征值方向实现“特征复制(Copy Head)”而负特征值方向对应“反向抑制(如 Negative Name Mover)”;
- (5 分)描述第 1 层的 Previous Token
Head 与第 2 层的 Induction Head
如何通过 K-Composition 实现上下文模式补全
[A][B]...[A] -> [B];并说明 Olsson 等人(2022)在“2 层玩具 attention-only 模型”与“带 MLP 的 13B 大模型”之间给出的因果证据等级有何关键区分。
- (b)(14 分)
可解释性边界与理论复杂度天花板:
- (6 分)说明为什么不能把
attention weight直接等同于因果归因(列举注意力权重非唯一相关性证据、IOI 需 \(26\) 个头协作两项依据),并解释 Makelov 等人(ICLR 2024)指出的子空间 Activation Patching 为何会触发“休眠并行通路(dormant parallel pathway)”解释幻觉; - (8 分)依据 Merrill & Sabharwal(ICLR 2024)的计算复杂度证明,禁止生成中间推理步骤的定精度标准 Transformer Decoder 的计算能力被限制在哪一个电路复杂度类中?为什么判断 \(n\) 位二进制串的奇偶校验(Parity)或有向图连通性这类任务会撞上该上限?允许生成 \(t(n) = \Theta(n)\) 或 \(\mathrm{poly}(n)\) 步中间思维链(CoT)token 后,理论可计算类如何随之跃升?最后结合 Turpin 等人(NeurIPS 2023)说明为什么“CoT 提高了正确率”不等于“CoT 文本忠实反映了模型的内部计算轨迹”。
- (6 分)说明为什么不能把
参考答案与评分细则(先独立推导再展开)
- (a) QK/OV 电路与诱导头机制(10 分):
- \(W_{QK}\) 决定“当前 query 关注哪个历史位置”(路由选择),\(W_{OV}\) 决定“把被关注位置的特征以何种线性变换写入残差流”(内容复制/抑制),两者秩均 \(\le d_k\)(\(2\) 分)。求 \(W_{OV}\) 特征方程:上左 \(2\times 2\) 块 \(\det\begin{pmatrix} 1.5-\lambda & 0.5 \\ 0.5 & 1.5-\lambda \end{pmatrix} = 0 \implies \lambda_1 = 2.0\)(特征方向 \(\frac{1}{\sqrt{2}}(1,1,0)^\top\))、\(\lambda_2 = 1.0\)(\(\frac{1}{\sqrt{2}}(1,-1,0)^\top\));第 \(3\) 轴 \(\lambda_3 = -0.5\)(\((0,0,1)^\top\))。正特征值方向使输出与被关注嵌入同向对齐,抬高对应词 logit 实现复制;负特征值把内容反向写入从而压低对应预测置信度(\(3\) 分)。
- 第 1 层 Previous Token Head 将位置 \(t-1\) 的 token 特征写入位置 \(t\) 的残差流(记作“前驱是谁”);第 2 层 Induction Head 的 \(W_K\) 读取该前驱特征(即 K-Composition),当前位置出现 \(A\) 时检索“前驱同样是 \(A\)”的位置(即 \(B\) 所在位置),再通过正向 \(W_{OV}\) 复制 \(B\) 的特征用于预测下一词(\(3\) 分)。Olsson 等人在玩具模型中通过消融给出了强因果证据,但在带 MLP 的大模型中仅报告了训练相变与 ICL 跃升同步出现的相关性证据(\(2\) 分)。
- (b) 可解释性陷阱与 \(TC^0\) 复杂度(14
分):
- 注意力权重只衡量当前层值向量的混洗比例,经过深层残差叠加、MLP 非线性改写后与最终预测无唯一因果映射(Jain & Wallace 等),且如 GPT-2 small 的 IOI 仅一个指代任务就需要 \(26\) 个头、\(7\) 种角色协作(\(3\) 分)。激活替换会把 clean 与 corrupted 状态人为混拼出分布外激活,有时会激活一条原本不参与正常推理的休眠并行通路完成行为恢复,从而造成“以为定位了真因果子空间”的幻觉(\(3\) 分)。
- 无中间步数的定精度标准 Transformer Decoder 受限于常数深度阈值电路类 \(\mathrm{TC}^0\)(\(2\) 分)。奇偶校验 Parity 或图连通性在顺序状态累积下不属于均匀 \(\mathrm{TC}^0\)(任何固定层数并行阈值电路无法在 \(O(1)\) 层内准确处理任意长度奇偶翻转)(\(2\) 分)。允许生成 \(t(n) = \Theta(n)\) 步中间 token(配合 projected pre-norm)可扩展至识别所有正则语言,\(t(n) = \mathrm{poly}(n)\) 步则可达到多项式时间可解类 \(\mathrm{P}\)(\(2\) 分)。Turpin 等人在输入埋入偏置提示时发现模型准确率下降高达 \(36\%\),但生成的 CoT 文本从不承认偏置影响而是编造事后合理化理由,证明 CoT 是计算资源扩容而非忠实可解释记录(\(2\) 分)。
第 5 题(24 分):Mamba ZOH 离散化与 4 步并行扫描 vs 线性注意力状态矩阵与退化防线
- (a)(10 分) Mamba 通过输入依赖步长
\(\Delta_t\) 将连续状态系统
\(\dot{h}(t) = A h(t) + B_t
x_t\) 用零阶保持(ZOH)离散化:\(\overline{A}_t = \exp(\Delta_t
A)\),\(\overline{B}_t =
(\Delta_t A)^{-1}(\exp(\Delta_t A) - I)\Delta_t
B_t\)。
- (4 分)取标量系统 \(A = -1,\ B_t = 1\),分别计算 \(\Delta_t = 0.01\)(噪声词)与 \(\Delta_t = 2.0\)(核心实体词)下的精确 \((\overline{A}_t, \overline{B}_t)\)(保留 \(4\) 位小数),说明 \(\Delta_t\) 如何充当自适应选择性门控;
- (6 分)定义仿射状态更新算子组合 \((a_2, b_2) \circ (a_1, b_1) = (a_2 a_1,\ a_2 b_1 + b_2)\)。验证该运算满足结合律;随后取 \(4\) 步参数 \((a_1,b_1)=(0.5, 2),\ (a_2,b_2)=(0.5, 1),\ (a_3,b_3)=(0.2, 4),\ (a_4,b_4)=(0.5, 3)\),初始 \(h_0=0\),按 2 层 Blelloch 并行归约树(先并算 \(c_{12}=(a_2,b_2)\circ(a_1,b_1)\) 与 \(c_{34}=(a_4,b_4)\circ(a_3,b_3)\),再合并 \(c_{14}=c_{34}\circ c_{12}\))手算最终状态 \(h_4\),并与逐拍串行递推 \(h_t = a_t h_{t-1} + b_t\) 核对。
- (b)(7 分) 线性注意力用特征映射 \(\phi\) 将相似度替换成 \(\phi(\mathbf{q}_i)^\top\phi(\mathbf{k}_j)\)。写出状态矩阵的递归更新式 \(S_t = S_{t-1} + \phi(\mathbf{k}_t)\mathbf{v}_t^\top \in \mathbb{R}^{d_k\times d_v}\) 与归一化向量 \(z_t\);取 \(d_k=d_v=2\),依次写入两个正交键 \(\phi(\mathbf{k}_1)=(1, 0)^\top, \mathbf{v}_1=(3, -1)^\top\) 与 \(\phi(\mathbf{k}_2)=(0, 1)^\top, \mathbf{v}_2=(-2, 5)^\top\),手算用 \(\phi(\mathbf{q})=\phi(\mathbf{k}_1)\) 查询 \(S_2\) 的精确检索输出;若再写入第 \(3\) 个线性相关键 \(\phi(\mathbf{k}_3)=(1, 1)^\top, \mathbf{v}_3=(10, 10)^\top\) 后再次用 \(\phi(\mathbf{k}_1)\) 查询 \(S_3\),输出变成多少?由此说明 Zoology(Arora et al., ICLR 2024)的 MQAR 关联检索维度下界根源。
- (c)(7 分)
区分推理退化的三种主要形态(死循环重复、乱码/控制字符、无意义数字/语义兜圈)各自对应的机制触发链;解释为什么在长上下文下由
Attention Sink 与 Softmax
马太效应诱发死循环时,直接调大 decoding
temperature虽有机会跳出循环,却同时可能推高乱码风险;列出架构、数值、解码、运行时四层防线各自重点拦截的退化类型。
参考答案与评分细则(先独立推导再展开)
- (a) Mamba ZOH 离散化与 4 步并行扫描(10
分):
- 当 \(\Delta_t = 0.01\):\(\overline{A}_t = e^{-0.01} \approx \mathbf{0.9901}\),\(\overline{B}_t = \frac{e^{-0.01}-1}{-1} = 1 - e^{-0.01} \approx \mathbf{0.0100}\)(精确 \(0.009950\)),几乎原样保留旧状态并忽略当前噪声词。当 \(\Delta_t = 2.0\):\(\overline{A}_t = e^{-2} \approx \mathbf{0.1353}\),\(\overline{B}_t = 1 - e^{-2} \approx \mathbf{0.8647}\),大幅衰减旧记忆并重点写入当前关键输入(\(4\) 分)。
- 结合律验算:\(\big((a_3,b_3)\circ(a_2,b_2)\big)\circ(a_1,b_1)
= (a_3 a_2 a_1,\ a_3 a_2 b_1 + a_3 b_2 + b_3) =
(a_3,b_3)\circ\big((a_2,b_2)\circ(a_1,b_1)\big)\)(\(2\) 分)。 Blelloch
两层归约(\(4\) 分):
- 第一层并行:\(c_{12} = (0.5\times 0.5,\ 0.5\times 2 + 1) = (0.25,\ 2.0)\);\(c_{34} = (0.5\times 0.2,\ 0.5\times 4 + 3) = (0.10,\ 5.0)\);
- 第二层合并:\(c_{14} = c_{34}\circ c_{12} = (0.10\times 0.25,\ 0.10\times 2.0 + 5.0) = (0.025,\ \mathbf{5.2})\),故 \(h_4 = 5.2\)。
- 串行核对:\(h_1=2.0 \to h_2=0.5(2)+1=2.0 \to h_3=0.2(2)+4=4.4 \to h_4=0.5(4.4)+3=\mathbf{5.2}\),严格一致。
- (b) 线性注意力外积状态与检索碰撞(7
分):
- 由结合律重写 \(o_i = \frac{\phi(\mathbf{q}_i)^\top S_i}{\phi(\mathbf{q}_i)^\top z_i}\),其中 \(S_i = S_{i-1} + \phi(\mathbf{k}_i)\mathbf{v}_i^\top\),\(z_i = z_{i-1} + \phi(\mathbf{k}_i)\)(即逐拍累加秩-1 外积)(\(2\) 分)。
- 写入前两键:\(S_2 = \begin{pmatrix} 3 & -1 \\ -2 & 5 \end{pmatrix},\ z_2 = (1, 1)^\top\),用 \(\phi(\mathbf{k}_1)=(1, 0)^\top\) 查询得 \(\frac{(1,0)S_2}{(1,0)z_2} = \mathbf{(3, -1)}\)(无损取回 \(\mathbf{v}_1\))(\(2\) 分)。
- 再写入 \(\phi(\mathbf{k}_3)=(1, 1)^\top\) 后,\(S_3 = \begin{pmatrix} 13 & 9 \\ 8 & 15 \end{pmatrix},\ z_3 = (2, 2)^\top\),同样查询得 \(\frac{(13, 9)}{2} = \mathbf{(6.5,\ 4.5)}\),原值被彻底混叠污染。在 \(\mathbb{R}^{d_k}\) 空间中最多容纳 \(d_k\) 个正交键;当写入键值对数量 \(N > d_k\) 时,固定大小矩阵状态必然发生线性相关碰撞而丧失精确检索能力,这正是 MQAR 要求 \(d \ge N\) 的代数根源(\(3\) 分)。
- (c) 推理退化形态与四层防线(7 分):
- 死循环源于概率偏置 + 重复 KV 正反馈 + Causal Mask 切断退路;乱码/控制字符源于 FP16/量化溢出产生 Inf/NaN 扩散并落入词表边缘;无意义数字/语义兜圈属于似然陷阱软退化(\(3\) 分)。
- 调大
temperature拉平整体分布,虽然降低了高重复 token 持续垄断 \(\arg\max\) 的死循环锁死概率,却同时抬高了训练极少覆盖的词表长尾、控制字符及碎片边缘区域的采样概率(\(2\) 分)。 - 四层防线:架构层(显式 sink 锚定、滑动窗口、RoPE 外推修正)防长历史污染;数值层(Softmax/Norm 保 FP32、激活裁剪)防乱码溢出;解码层(惩罚系数、no-repeat-ngram、黑名单、动态早停)防重复与词表越界;运行时层(窗口熵/重复率监控、KV 后缀裁剪复位、请求熔断)切断被污染 Cache 的持续恶化(\(2\) 分)。
对应补漏章节:55|Transformer 的根本局限、56|状态空间模型、57|RWKV / RetNet / 线性注意力、59|推理退化。
五、全卷数值题纯 Python / NumPy 核验实验室
写完三套试卷并自评步骤后,可以在本地运行下面这段纯 Python 3 + NumPy 脚本(无外部框架依赖),一次性自动检验三套试卷全部数值题、矩阵分块、梯度与离散化结果(以下脚本与输出均在 Python 3 + NumPy 1.26.4 环境下实际运行验证):
import math
import numpy as np

print("=== QUIZ 1 VERIFICATION ===")
# Q1(b): Four Fundamental Subspaces & Orthogonal Split
A = np.array([[1.0, 1.0, 2.0], [0.0, 1.0, 1.0]])
n_vec = np.array([1.0, 1.0, -1.0])
x_in = np.array([4.0, 2.0, 0.0])
x_n = ((n_vec @ x_in) / (n_vec @ n_vec)) * n_vec
x_r = x_in - x_n
assert np.allclose(A @ x_n, 0.0) and np.isclose(x_r @ x_n, 0.0) and np.allclose(A @ x_in, A @ x_r)
print(f"Q1(b): rank={np.linalg.matrix_rank(A)}, x_r={x_r.tolist()}, x_n={x_n.tolist()}, Ax={(A @ x_in).tolist()}")

# Q2(a)(b): Orthogonal Projection P_a & Cauchy-Schwarz
a = np.array([1.0, 2.0, 2.0])
b = np.array([6.0, 3.0, 6.0])
P_a = np.outer(a, a) / (a @ a)
p = P_a @ b
e = b - p
cos_theta = float((a @ b) / (np.linalg.norm(a) * np.linalg.norm(b)))
assert np.allclose(P_a @ P_a, P_a) and np.isclose(p @ e, 0.0)
print(f"Q2(a): p={np.round(p, 6).tolist()}, e={np.round(e, 6).tolist()}, |p|^2={p @ p:.1f}, |e|^2={e @ e:.1f}, |b|^2={b @ b:.1f}, cos={cos_theta:.6f}")

# Q2(c): Dot-product scaling
s_raw = np.array([0.0, 8.0, 0.0])
for tag, sc in [("unscaled", 1.0), ("sqrt_dk", 8.0), ("dk", 64.0)]:
    z = s_raw / sc
    ez = np.exp(z - z.max())
    pr = ez / ez.sum()
    print(f"Q2(c) [{tag:8s}]: p2={pr[1]:.6f}, J22={pr[1]*(1.0-pr[1]):.6f}")

# Q3(a): Backprop Rank-1 Outer Product (row-vector forward y^T = x^T W)
x_bp = np.array([2.0, -1.0])
W1_bp = np.array([[2.0, -1.0], [1.0, 1.0]])
W2_bp = np.array([[1.0, 2.0], [-1.0, 3.0]])
gy_bp = np.array([1.0, -2.0])
z1_bp = x_bp @ W1_bp
h_bp = np.maximum(0.0, z1_bp)
y_bp = h_bp @ W2_bp
gW2_bp = np.outer(h_bp, gy_bp)
gh_bp = W2_bp @ gy_bp
gz1_bp = gh_bp * (z1_bp > 0).astype(float)
gW1_bp = np.outer(x_bp, gz1_bp)
gx_bp = W1_bp @ gz1_bp
print(f"Q3(a): z1={z1_bp.tolist()}, h={h_bp.tolist()}, y={y_bp.tolist()}")
print(f"Q3(a): gW2={gW2_bp.tolist()}, gW1={gW1_bp.tolist()}, gx={gx_bp.tolist()}")

# Q3(b)(c): Softmax Jacobian & Nullspace
z_sm = np.array([0.0, math.log(2.0), math.log(3.0)])
p_sm = np.exp(z_sm) / np.sum(np.exp(z_sm))
J_sm = np.diag(p_sm) - np.outer(p_sm, p_sm)
e3 = np.array([0.0, 0.0, 1.0])
gz_sm = J_sm.T @ (-e3 / p_sm)
assert np.allclose(J_sm @ np.ones(3), 0.0) and np.allclose(gz_sm, p_sm - e3)
print(f"Q3(b): p={np.round(p_sm, 6).tolist()}, 36*J={np.round(36*J_sm, 6).tolist()}")
print(f"Q3(c): gz={np.round(gz_sm, 6).tolist()}")

# Q4(a): 3-token Causal Scaled Dot-Product Attention
Q = np.array([[1., 1., 0., 0.], [1., 1., 1., 1.], [2., 0., 2., 0.]])
K = np.array([[1., 1., 0., 0.], [0., 2., 0., 0.], [1., 0., 1., 0.]])
V = np.array([[1., 0., 2., 0.], [0., 2., 0., 2.], [2., 2., 0., 0.]])
S_att = (Q @ K.T) / 2.0
M_c = np.where(np.tril(np.ones((3, 3), dtype=bool)), 0.0, -np.inf)
S_m = S_att + M_c
ex_a = np.exp(S_m - np.max(S_m, axis=1, keepdims=True))
A_att = ex_a / np.sum(ex_a, axis=1, keepdims=True)
O_att = A_att @ V
print("Q4(a): Attn =", np.round(A_att, 6).tolist())
print("Q4(a): Out  =", np.round(O_att, 6).tolist())

# Q4(b): FLOPs & crossover
d_m = 4096
for n_t in [4096, 24576, 65536]:
    g_fl = 24 * n_t * (d_m ** 2)
    a_fl = 4 * (n_t ** 2) * d_m
    print(f"Q4(b) [n={n_t:5d}]: total={(g_fl+a_fl)/1e12:.4f} TFLOPs, attn_share={a_fl/(g_fl+a_fl)*100:.2f}%")

print("\n=== MIDTERM (EXAM 2) VERIFICATION ===")
# Q1(c): LayerNorm d=4 forward & backward
x_ln = np.array([0.0, 6.0, 8.0, 14.0])
g_ln = np.array([3.0, -1.0, 2.0, 4.0])
xc_ln = x_ln - x_ln.mean()
sig_ln = math.sqrt(np.mean(xc_ln ** 2))
xhat_ln = xc_ln / sig_ln
P_ln = np.eye(4) - np.ones((4, 4)) / 4.0
grad_ln = (1.0 / sig_ln) * (P_ln @ g_ln - (np.dot(xhat_ln, g_ln) / 4.0) * xhat_ln)
assert np.isclose(np.sum(grad_ln), 0.0) and np.isclose(np.dot(xhat_ln, grad_ln), 0.0)
print(f"E2 Q1(c): mu={x_ln.mean():.1f}, sigma={sig_ln:.1f}, xhat={xhat_ln.tolist()}, grad={np.round(grad_ln, 4).tolist()}")

# Q2(a): Geva FFN Rank-1 KV Memory
x_ffn = np.array([1.0, 2.0])
W1_ffn = np.array([[1.0, -1.0, 2.0], [1.0, 1.0, -1.0]])
b1_ffn = np.array([0.0, -2.0, 1.0])
W2_ffn = np.array([[2.0, -1.0], [1.0, 3.0], [0.5, 0.5]])
c_ffn = np.maximum(0.0, x_ffn @ W1_ffn + b1_ffn)
y_ffn = c_ffn @ W2_ffn
print(f"E2 Q2(a): c={c_ffn.tolist()}, y={y_ffn.tolist()}")

# Q2(c): Label Smoothing & Noam LR
V_ls, eps_ls = 10, 0.1
dz_ls = math.log(((1.0 - eps_ls) * V_ls + eps_ls) / eps_ls)
q_ls = np.full(V_ls, eps_ls / V_ls)
q_ls[0] = 1.0 - eps_ls + eps_ls / V_ls
H_ls = -np.sum(q_ls * np.log(q_ls))
def noam(t, dm, tw=4000):
    return (dm ** -0.5) * min(t ** -0.5, t * (tw ** -1.5))
print(f"E2 Q2(c1): q0={q_ls[0]:.2f}, q_other={q_ls[1]:.2f}, dz*={dz_ls:.6f}, H(q)={H_ls:.6f}")
print(f"E2 Q2(c2): Base(1000)={noam(1000,512):.6e}, Base(4000)={noam(4000,512):.6e}, Base(16000)={noam(16000,512):.6e}, Big(4000)={noam(4000,1024):.6e}")

# Q3(a): LoRA SVD Eckart-Young
sv_l = np.array([6.0, 2.0, 0.4, 0.2])
err_1 = math.sqrt(np.sum(sv_l[1:] ** 2))
rel_1 = err_1 / math.sqrt(np.sum(sv_l ** 2))
en_1 = (sv_l[0] ** 2) / np.sum(sv_l ** 2)
print(f"E2 Q3(a): err_r1={err_1:.6f}, rel_err={rel_1*100:.2f}%, energy_r1={en_1*100:.2f}%, param_ratio={2*16/4096:.6f}")

# Q3(b): LoRA 2x2 step 0 & step 1 (lr=0.02)
x_lo = np.array([1.0, 2.0])
ystar_lo = np.array([2.0, 0.0])
A_lo = np.array([[1.0, 1.0]])
B_lo = np.zeros((2, 1))
s_lo, lr_lo = 2.0, 0.02
for st in range(2):
    h_lo = A_lo @ x_lo
    y_lo = x_lo + s_lo * (B_lo @ h_lo)
    L_lo = 0.5 * float(np.sum((y_lo - ystar_lo) ** 2))
    gy_lo = y_lo - ystar_lo
    gB_lo = s_lo * np.outer(gy_lo, h_lo)
    gA_lo = s_lo * (B_lo.T @ np.outer(gy_lo, x_lo))
    print(f"E2 Q3(b) step {st}: y={np.round(y_lo, 6).tolist()}, L={L_lo:.6f}, gB={np.round(gB_lo.ravel(), 6).tolist()}, gA={np.round(gA_lo.ravel(), 6).tolist()}")
    B_lo = B_lo - lr_lo * gB_lo
    A_lo = A_lo - lr_lo * gA_lo

# Q3(c): SFT -100 Loss Masking & Block-diagonal packing
Z_sft = np.array([[0.0, 1.5], [0.0, 1.0], [1.0, 0.0], [1.5, 0.0]])
tgt_full = np.array([0, 1, 1, 0])
ex_s = np.exp(Z_sft - Z_sft.max(axis=1, keepdims=True))
p_s = ex_s / ex_s.sum(axis=1, keepdims=True)
nll_s = -np.log(p_s[np.arange(4), tgt_full])
loss_unmasked = float(nll_s.mean())
loss_masked = float(nll_s[[1, 3]].mean())
prompt_share = float((nll_s[0] + nll_s[2]) / nll_s.sum() * 100.0)
doc_ids = np.array([0, 0, 1, 1])
idx_s = np.arange(4)
naive_m = idx_s[:, None] >= idx_s[None, :]
blk_m = naive_m & (doc_ids[:, None] == doc_ids[None, :])
leaks_1based = (np.argwhere(naive_m ^ blk_m) + 1).tolist()
print(f"E2 Q3(c): nll={np.round(nll_s, 6).tolist()}, unmasked={loss_unmasked:.6f}, masked={loss_masked:.6f}, prompt_share={prompt_share:.2f}%")
print(f"E2 Q3(c): leaked pairs (1-based)={leaks_1based}")

# Q4(a): GRPO
for name, rg in [("split", np.array([1., 1., 0., 0.])), ("all_1", np.array([1., 1., 1., 1.]))]:
    std = rg.std(ddof=0)
    adv = np.zeros_like(rg) if std == 0 else (rg - rg.mean()) / std
    print(f"E2 Q4(a) [{name}]: adv={adv.tolist()}")

# Q4(b): Chinchilla C=6e21
Ac, Bc, alc, bec = 406.4, 410.7, 0.34, 0.28
Cc = 6e21
ac = bec / (alc + bec)
bc = alc / (alc + bec)
Gc = (alc * Ac / (bec * Bc)) ** (1.0 / (alc + bec))
Nc = Gc * ((Cc / 6.0) ** ac)
Dc = (1.0 / Gc) * ((Cc / 6.0) ** bc)
print(f"E2 Q4(b): a={ac:.6f}, b={bc:.6f}, G={Gc:.6f}, N*={Nc:.4e}, D*={Dc:.4e}, D*/N*={Dc/Nc:.2f}")

# Q4(c): 4x4 mask rank & prefix KV reuse
A_enc0 = np.full((4, 4), 0.25)
A_caus0 = np.array([[1., 0., 0., 0.], [0.5, 0.5, 0., 0.], [1/3, 1/3, 1/3, 0.], [0.25, 0.25, 0.25, 0.25]])
print(f"E2 Q4(c): rank_enc={np.linalg.matrix_rank(A_enc0)}, det_enc={np.linalg.det(A_enc0):.4f}, rank_caus={np.linalg.matrix_rank(A_caus0)}, det_caus={np.linalg.det(A_caus0):.6f}")
K_r, P_r, Q_r = 8, 3000, 250
print(f"E2 Q4(c): Decoder+Prefix={P_r + K_r*Q_r}, Enc-Dec={K_r*(P_r+Q_r)}, ratio={(K_r*(P_r+Q_r))/(P_r+K_r*Q_r):.2f}x")

print("\n=== FINAL EXAM (EXAM 3) VERIFICATION ===")
# Q1(a): RoPE 2D & channel wrap
th0 = math.pi / 3.0
def rot2(ang):
    return np.array([[math.cos(ang), -math.sin(ang)], [math.sin(ang), math.cos(ang)]])
q0_r = np.array([2.0, 0.0])
k0_r = np.array([1.0, math.sqrt(3.0)])
qm_r = rot2(1 * th0) @ q0_r
kn_r = rot2(4 * th0) @ k0_r
assert np.isclose(qm_r @ kn_r, q0_r @ (rot2(3 * th0) @ k0_r))
print(f"E3 Q1(a): q1={np.round(qm_r, 6).tolist()}, k4={np.round(kn_r, 6).tolist()}, dot={qm_r @ kn_r:.6f}")
for base in [10000.0, 500000.0]:
    Ti = 2 * math.pi * (base ** (2 * np.arange(64) / 128))
    print(f"E3 Q1(a) [base={int(base)}]: wrapped={int(np.sum(Ti <= 131072))}/64")

# Q1(b): FlashAttention 2-block online softmax
s_all = np.array([1.0, 3.0, 4.0, 2.0])
v_all = np.array([2.0, 4.0, 6.0, 1.0])
pg = np.exp(s_all - s_all.max())
pg /= pg.sum()
og = float(pg @ v_all)
m1, m2 = 3.0, 4.0
l1 = float(np.sum(np.exp(s_all[:2] - m1)))
o1 = float(np.exp(s_all[:2] - m1) @ v_all[:2]) / l1
l2 = float(np.sum(np.exp(s_all[2:] - m2)))
o2_un = float(np.exp(s_all[2:] - m2) @ v_all[2:])
m_new = max(m1, m2)
l_new = math.exp(m1 - m_new) * l1 + math.exp(m2 - m_new) * l2
o_new = (math.exp(m1 - m_new) * l1 * o1 + math.exp(m2 - m_new) * o2_un) / l_new
assert math.isclose(o_new, og, rel_tol=1e-12)
print(f"E3 Q1(b): l1={l1:.6f}, o1={o1:.6f}, l2={l2:.6f}, o2_un={o2_un:.6f}, l_new={l_new:.6f}, o_new={o_new:.6f}, o_glob={og:.6f}")

# Q2(a): MoE aux loss
print(f"E3 Q2(a): L_bal={0.01*8*(8*(1/8)**2):.4f}, L_col={0.01*8*(2*0.5**2):.4f}")

# Q2(b): DeepSeek MLA KV Cache
L_ly, H_q, d_h, S_len, b_fp = 60, 128, 128, 131072, 2
kv_mha = 2 * L_ly * H_q * d_h * S_len * b_fp
kv_gqa8 = 2 * L_ly * 8 * d_h * S_len * b_fp
kv_mla = L_ly * (512 + 64) * S_len * b_fp
print(f"E3 Q2(b): MHA={kv_mha/(1024**3):.4f} GiB, GQA8={kv_gqa8/(1024**3):.4f} GiB, MLA={kv_mla/(1024**3):.4f} GiB, vs_MHA={kv_mha/kv_mla:.2f}x, vs_GQA8={kv_gqa8/kv_mla:.2f}x")

# Q3(b)(c): Speculative & Temperature/Top-p order
al_sp, K_sp, c_sp = 0.75, 4, 0.05
e_tok = (1 - al_sp**(K_sp + 1)) / (1 - al_sp)
e_spd = e_tok / (K_sp * c_sp + 1)
print(f"E3 Q3(b): E[tok]={e_tok:.6f}, E[speedup]={e_spd:.6f}x")

z_dec = np.array([3.0, 2.0, 1.0, 0.0])
sm = lambda v: np.exp(v - v.max()) / np.sum(np.exp(v - v.max()))
p_o = sm(z_dec)
p_t = sm(z_dec / 2.0)
p_ord1 = np.zeros(4); p_ord1[:2] = sm(z_dec[:2] / 2.0)
p_ord2 = np.zeros(4); p_ord2[:3] = p_t[:3] / p_t[:3].sum()
print(f"E3 Q3(c): p_orig={np.round(p_o, 6).tolist()}, p_T2={np.round(p_t, 6).tolist()}")
print(f"E3 Q3(c): Order1(TopP->T2)={np.round(p_ord1, 6).tolist()}, Order2(T2->TopP)={np.round(p_ord2, 6).tolist()}")

# Q4(a): Elhage W_OV eigenvalues
W_ov = np.array([[1.5, 0.5, 0.0], [0.5, 1.5, 0.0], [0.0, 0.0, -0.5]])
evals_ov, _ = np.linalg.eigh(W_ov)
print(f"E3 Q4(a): W_OV evals={np.round(evals_ov, 6).tolist()}")

# Q5(a): Mamba ZOH & Blelloch Scan
for dt in [0.01, 2.0]:
    ab = math.exp(dt * (-1.0))
    bb = ((ab - 1.0) / (-dt)) * dt
    print(f"E3 Q5(a) [dt={dt:4.2f}]: A_bar={ab:.6f}, B_bar={bb:.6f}")
ops = [(0.5, 2.0), (0.5, 1.0), (0.2, 4.0), (0.5, 3.0)]
comp = lambda op2, op1: (op2[0] * op1[0], op2[0] * op1[1] + op2[1])
h_s = 0.0; hs = []
for a_i, b_i in ops:
    h_s = a_i * h_s + b_i; hs.append(round(h_s, 6))
c12, c34 = comp(ops[1], ops[0]), comp(ops[3], ops[2])
c14 = comp(c34, c12)
assert math.isclose(c14[1], h_s)
print(f"E3 Q5(a): serial={hs}, c12={c12}, c34={c34}, c14={c14}")

# Q5(b): Linear Attention Outer-Product State Matrix Memory
k1, v1 = np.array([1.0, 0.0]), np.array([3.0, -1.0])
k2, v2 = np.array([0.0, 1.0]), np.array([-2.0, 5.0])
S2 = np.outer(k1, v1) + np.outer(k2, v2)
z2 = k1 + k2
out1 = (k1 @ S2) / (k1 @ z2)
k3, v3 = np.array([1.0, 1.0]), np.array([10.0, 10.0])
S3 = S2 + np.outer(k3, v3)
z3 = z2 + k3
out1_after = (k1 @ S3) / (k1 @ z3)
print(f"E3 Q5(b): 2-key exact retrieve={out1.tolist()}, 3-key collide={np.round(out1_after, 6).tolist()}")
实际运行输出如下:
=== QUIZ 1 VERIFICATION ===
Q1(b): rank=2, x_r=[2.0, 0.0, 2.0], x_n=[2.0, 2.0, -2.0], Ax=[6.0, 2.0]
Q2(a): p=[2.666667, 5.333333, 5.333333], e=[3.333333, -2.333333, 0.666667], |p|^2=64.0, |e|^2=17.0, |b|^2=81.0, cos=0.888889
Q2(c) [unscaled]: p2=0.999330, J22=0.000670
Q2(c) [sqrt_dk ]: p2=0.576117, J22=0.244206
Q2(c) [dk      ]: p2=0.361664, J22=0.230863
Q3(a): z1=[3.0, -3.0], h=[3.0, 0.0], y=[3.0, 6.0]
Q3(a): gW2=[[3.0, -6.0], [0.0, -0.0]], gW1=[[-6.0, -0.0], [3.0, 0.0]], gx=[-6.0, -3.0]
Q3(b): p=[0.166667, 0.333333, 0.5], 36*J=[[5.0, -2.0, -3.0], [-2.0, 8.0, -6.0], [-3.0, -6.0, 9.0]]
Q3(c): gz=[0.166667, 0.333333, -0.5]
Q4(a): Attn = [[1.0, 0.0, 0.0], [0.5, 0.5, 0.0], [0.244728, 0.090031, 0.665241]]
Q4(a): Out  = [[1.0, 0.0, 2.0, 0.0], [0.5, 1.0, 1.0, 1.0], [1.57521, 1.510543, 0.489457, 0.180061]]
Q4(b) [n= 4096]: total=1.9241 TFLOPs, attn_share=14.29%
Q4(b) [n=24576]: total=19.7912 TFLOPs, attn_share=50.00%
Q4(b) [n=65536]: total=96.7570 TFLOPs, attn_share=72.73%

=== MIDTERM (EXAM 2) VERIFICATION ===
E2 Q1(c): mu=7.0, sigma=5.0, xhat=[-1.4, -0.2, 0.2, 1.4], grad=[0.34, -0.58, -0.02, 0.26]
E2 Q2(a): c=[3.0, 0.0, 1.0], y=[6.5, -2.5]
E2 Q2(c1): q0=0.91, q_other=0.01, dz*=4.510860, H(q)=0.500288
E2 Q2(c2): Base(1000)=1.746928e-04, Base(4000)=6.987712e-04, Base(16000)=3.493856e-04, Big(4000)=4.941059e-04
E2 Q3(a): err_r1=2.049390, rel_err=32.32%, energy_r1=89.55%, param_ratio=0.007812
E2 Q3(b) step 0: y=[1.0, 2.0], L=2.500000, gB=[-6.0, 12.0], gA=[0.0, 0.0]
E2 Q3(b) step 1: y=[1.72, 0.56], L=0.196000, gB=[-1.68, 3.36], gA=[-0.336, -0.672]
E2 Q3(c): nll=[1.701413, 0.313262, 1.313262, 0.201413], unmasked=0.882337, masked=0.257337, prompt_share=85.42%
E2 Q3(c): leaked pairs (1-based)=[[3, 1], [3, 2], [4, 1], [4, 2]]
E2 Q4(a) [split]: adv=[1.0, 1.0, -1.0, -1.0]
E2 Q4(a) [all_1]: adv=[0.0, 0.0, 0.0, 0.0]
E2 Q4(b): a=0.451613, b=0.548387, G=1.344711, N*=4.0973e+09, D*=2.4406e+11, D*/N*=59.57
E2 Q4(c): rank_enc=1, det_enc=0.0000, rank_caus=4, det_caus=0.041667
E2 Q4(c): Decoder+Prefix=5000, Enc-Dec=26000, ratio=5.20x

=== FINAL EXAM (EXAM 3) VERIFICATION ===
E3 Q1(a): q1=[1.0, 1.732051], k4=[1.0, -1.732051], dot=-2.000000
E3 Q1(a) [base=10000]: wrapped=64/64
E3 Q1(a) [base=500000]: wrapped=49/64
E3 Q1(b): l1=1.135335, o1=3.761594, l2=1.135335, o2_un=6.135335, l_new=1.553002, o_new=4.962278, o_glob=4.962278
E3 Q2(a): L_bal=0.0100, L_col=0.0400
E3 Q2(b): MHA=480.0000 GiB, GQA8=30.0000 GiB, MLA=8.4375 GiB, vs_MHA=56.89x, vs_GQA8=3.56x
E3 Q3(b): E[tok]=3.050781, E[speedup]=2.542318x
E3 Q3(c): p_orig=[0.643914, 0.236883, 0.087144, 0.032059], p_T2=[0.455054, 0.276004, 0.167405, 0.101536]
E3 Q3(c): Order1(TopP->T2)=[0.622459, 0.377541, 0.0, 0.0], Order2(T2->TopP)=[0.50648, 0.307196, 0.186324, 0.0]
E3 Q4(a): W_OV evals=[-0.5, 1.0, 2.0]
E3 Q5(a) [dt=0.01]: A_bar=0.990050, B_bar=0.009950
E3 Q5(a) [dt=2.00]: A_bar=0.135335, B_bar=0.864665
E3 Q5(a): serial=[2.0, 2.0, 4.4, 5.2], c12=(0.25, 2.0), c34=(0.1, 5.0), c14=(0.025, 5.2)
E3 Q5(b): 2-key exact retrieve=[3.0, -1.0], 3-key collide=[6.5, 4.5]
考后诊断:从分数回溯薄弱章节
将三套试卷各题得分填入下面诊断表,对照得分率(\(\text{实际得分} / \text{该题满分}\))低于 \(70\%\) 的条目回看对应章节:
| 考卷与题号 | 核心考察能力 | 满分 | 低于 \(70\%\) 时的优先回溯章节 |
|---|---|---|---|
| Quiz 1 · 第 1 题 | Strang 四子空间、\(W_Q W_K^\top\) 秩界与多头拼块 | \(25\) | 03 矩阵四视角、03.5 Strang 地图、16 多头注意力 |
| Quiz 1 · 第 2 题 | 正交投影 \(P_{\mathbf{a}}\)、Cauchy-Schwarz 与 \(\sqrt{d_k}\) 缩放 | \(25\) | 02 向量与投影、15 缩放点积 |
| Quiz 1 · 第 3 题 | 反向传播秩-1 外积、Softmax Jacobian 与 \(J\mathbf{1}=\mathbf{0}\) | \(25\) | 06 反向传播、07 Softmax、08.5 神经网络 |
| Quiz 1 · 第 4 题 | 因果注意力手算与 \(24nd^2+4n^2d\) 交叉点 | \(25\) | 14 自注意力、17 因果掩码、18 复杂度账本 |
| Midterm · 第 1 题 | 正弦 \(SO(2)\) 旋转、Pre-LN vs Post-LN 与 LayerNorm Jacobian | \(25\) | 21 位置编码、24 残差连接、25 LayerNorm |
| Midterm · 第 2 题 | FFN 键值记忆、SwiGLU \(\frac{8}{3}d\)、Label Smoothing 与 Noam | \(25\) | 26 前馈网络、27 原论文配方 |
| Midterm · 第 3 题 | LoRA SVD / 不对称梯度与 SFT -100 /
块对角打包 |
\(25\) | 31 微调与 LoRA、32 指令微调 |
| Midterm · 第 4 题 | DPO/GRPO、Chinchilla 拉格朗日与掩码矩阵秩/KV 复用 | \(25\) | 33 RLHF/DPO/GRPO、34 Scaling Laws、40 三大路线 |
| Final · 第 1 题 | RoPE 绕圈周期与 FlashAttention Online Softmax | \(24\) | 41 PE 演进、42 FlashAttention |
| Final · 第 2 题 | MoE 负载均衡与 DeepSeek MLA 矩阵吸收压缩 | \(24\) | 44 MoE、49 KV Cache、03.5 Strang 地图 |
| Final · 第 3 题 | 无损投机采样无偏性、加速比与解码旋钮顺序 | \(24\) | 48 解码策略、50 投机解码 |
| Final · 第 4 题 | Elhage QK/OV 电路、诱导头、Patching 幻觉与 \(TC^0\) | \(24\) | 52–53 可解释性、54 涌现能力、55 局限 |
| Final · 第 5 题 | Mamba ZOH 与并行扫描、线性注意力碰撞与退化防线 | \(24\) | 56 状态空间模型、57 线性注意力、59 推理退化 |
参考资料
经典教材与课程(Gilbert Strang MIT 18.06 / 18.065)
- Gilbert Strang. Introduction to Linear Algebra (5th ed.). Wellesley-Cambridge Press, 2016.(四个基本子空间、正交投影、对称正定矩阵与特征值)
- Gilbert Strang. Linear Algebra and Learning from Data. Wellesley-Cambridge Press, 2019.(SVD 与 Eckart-Young、条件数优化与神经网络线性代数)
- MIT OpenCourseWare 18.06 (Linear Algebra)、18.065 (Matrix Methods in Data Analysis) 与 Stanford CS224N / MIT 6.S191 公开考题组织思路。
核心论文(按考卷专题索引)
- Vaswani A. et al. Attention Is All You Need. NeurIPS, 2017.(缩放点积、Noam 调度、Label Smoothing 与架构基线)
- Xiong R. et al. On Layer Normalization in the Transformer Architecture. ICML, 2020.(Pre-LN vs Post-LN 梯度流与谱分析)
- Geva M. et al. Transformer Feed-Forward Layers Are Key-Value Memories. EMNLP, 2021.(FFN 秩-1 键值记忆视角)
- Hu E. J. et al. LoRA: Low-Rank Adaptation of Large Language Models. ICLR, 2022.(低秩增量微调与不对称初始化)
- Hoffmann J. et al. Training Compute-Optimal Large Language Models (Chinchilla). NeurIPS, 2022.(拉格朗日算力配比最优解)
- Rafailov R. et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. NeurIPS, 2023.(DPO 闭式最优策略与配分函数相消)
- Shao Z. et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300, 2024(预印本,未经同行评审;GRPO 组相对优势)
- Su J. et al. RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing 568, 2024.(旋转位置编码相对不变性)
- Dao T. et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS, 2022.(SRAM Tiling 与 Online Softmax I/O 下界)
- Fedus W. et al. Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. JMLR, 2022;DeepSeek-AI. DeepSeek-V2 (arXiv:2405.04434, 2024,预印本,未经同行评审;MLA 矩阵吸收)
- Leviathan Y., Kalman M., Matias Y. Fast Inference from Transformers via Speculative Decoding. ICML, 2023.(投机采样无损等价性证明与加速比)
- Elhage N. et al. A Mathematical Framework for Transformer Circuits. Anthropic Transformer Circuits Thread, 2021;Olsson C. et al. arXiv:2209.11895, 2022(预印本,未经同行评审;诱导头与 K-Composition)
- Merrill W., Sabharwal A. The Expressive Power of Transformers with Chain of Thought. ICLR, 2024;Turpin M. et al. NeurIPS, 2023.(\(\mathrm{TC}^0\) 复杂度上限与 CoT 忠实性)
- Gu A., Dao T. Mamba: Linear-Time Sequence Modeling with Selective State Spaces. COLM, 2024;Arora S. et al. Zoology (ICLR, 2024)(ZOH 离散化、Blelloch 并行扫描与 MQAR 状态检索下界)
- Holtzman A. et al. The Curious Case of Neural Text Degeneration. ICLR, 2020;Xiao G. et al. Efficient Streaming Language Models with Attention Sinks. ICLR, 2024.(Nucleus 采样与 Attention Sink 防线)
开源实现与自测工具
- Python 3 / NumPy 1.26+ 本地验证环境(本文第五节独立脚本可直接离线复现全卷 13 道大题全部数值算例)。
← 上一篇:59|推理退化:乱码、死循环与无意义文本 | 系列首页:Transformer 与注意力机制 系列总览 →
源码下载
本文相关源码已整理,共 1 个文件。
文章导航
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【Transformer 与注意力机制】59|推理退化:乱码、死循环与无意义文本为何不是同一种 bug
拆解死循环、乱码与语义兜圈三类推理退化:推导 Softmax 注意力正反馈与秩坍塌、温度陷阱与掩码/FP16 污染,附 4-token 熵坍塌手算与 NumPy 验证及四层防线。
【Transformer 与注意力机制】01|为什么要从这里开始:课程大纲、学习方法与第一张全局地图
作为系统级 Transformer 课程的开篇地图,说明架构规模化统治力背后的数学与并行原理、全系列课程大纲与 6 条学习路径、符号约定,以及第一道张量形状与参数量热身题。
【Transformer 与注意力机制】03|矩阵乘法的四种视角:Gilbert Strang 如何看透 QK^T 与特征融合
以 Gilbert Strang 矩阵乘法的四种等价视角(点积、列线性组合、行线性组合、秩 1 外积之和)拆解 C = AB,手算 2×3 乘 3×2 全四种视角,并直接映射到 QK^T、attn·V、LoRA 低秩、多头注意力秩瓶颈与 GPU 算术强度。
【Transformer 与注意力机制】02|向量、内积与正交投影:从箭头到 QK^T
从二维平面箭头出发,用余弦定理严格证明点积代数与几何定义等价,推导 Cauchy-Schwarz 与三角不等式,系统讲透 Gilbert Strang 一维正交投影矩阵与高维几何,最后用 NumPy 落到注意力打分矩阵 QK^T。